この記事の要点
構成は、テンプレートに最初から入っているプロンプト拡張を外し、テキストエンコーダをテンプレートの既定より小さいファイルに替えたもの。この構成なら、VRAM の小さいほうの RTX 4070 SUPER でも ComfyUI で動き、Dev のテキストから画像、Edit Turbo の編集、参照画像を渡さない Edit Turbo のどれも最後まで生成できた。
テキストから画像を作るなら配布元が指定する Dev を使うことになり、待ち時間は Edit Turbo の編集の数倍から十倍近くになる。編集の指示を何度も試すなら、テンプレートの注記が方向を素早く試す用途に挙げる Edit Turbo を使う。
重みは非商用に限るライセンスで公開されていて、商用に使うには Bria との別の契約が要る。
Fibo 2.0はVRAM 12GB・16GBで動くか
VRAM 12GB の RTX 4070 SUPER と 16GB の RTX 5080 のどちらでも、Dev のテキストから画像 (文章のプロンプトから画像を作る使い方、text-to-image)・Edit Turbo の編集・参照画像を渡さない Edit Turbo の3つを、1024×1024 で7枚ずつ、GPU ごとに21枚すべて最後まで生成できた。同じプロンプトで続けて作ったときの1枚は、Dev が RTX 4070 SUPER で46.50秒・RTX 5080 で29.42秒、Edit Turbo の編集が4.85秒と3.20秒、画像を渡さない Edit Turbo が2.29秒と1.52秒だった。1つの使い方で読み込むファイルの合計は約12.7GiB で、RTX 4070 SUPER の VRAM (11.99GiB) より大きいが、それでも最後まで生成できた。
測ったのは2026年10月29日で、ソフトは ComfyUI v0.43.0、PC はメインメモリ96GiB の測定機。RTX 4070 SUPER は OCuLink (PCIe 4.0 x4) で外付けしている。ComfyUI のテンプレートに最初から入っているプロンプト拡張 (テンプレートの TextGenerate で指示文を書き直す工程) は外し、テキストエンコーダは int8 のファイル (qwen3vl_4b_int8_convrot) に替えた。拡散モデル (ComfyUI の models/diffusion_models に置くファイル) は、どちらの GPU でもテンプレートの既定の int8 を使った。ローカルで動く Fibo 2.0 のテンプレートは編集の2つだけなので、テキストから画像は編集のテンプレートを組み替えて測った (組み方は「テキストから画像の組み方」に書く)。
上の時間は ComfyUI が出す「Prompt executed in」の値で、1024×1024 の画像を同じプロンプトで続けて作った2〜4枚目の中央値。測定のプログラムが計った時間は、これより0.50〜0.77秒長かった。この差には、結果の記録を確かめてから監視を止めるまでの処理が入っていて、結果を受け取るまでの遅れを表すものではない。
読み込む3つのファイルは、拡散モデル (7.83GiB)・テキストエンコーダ (4.52GiB)・VAE (0.31GiB)。大きさは手元のファイルのバイト数を GiB に直した値 (1GiB = 1,073,741,824 バイト) で、3つの合計は13,603,333,006 バイト = 12.67GiB になる。GPU の VRAM は nvidia-smi が示す総量で、RTX 4070 SUPER が12,282MiB (11.99GiB)、RTX 5080 が16,303MiB (15.92GiB)。ComfyUI のログでは、3つのモデルとも dynamic VRAM で読み込まれていた。dynamic VRAM は ComfyUI の重みの読み込み方で、重みを空いている VRAM に置き、収まらない分はメインメモリに置いて必要なときに GPU へ送る。計算を CPU に回すわけではない。VRAM の使われ方の実測は後の節に載せた。
ComfyUI の入れ方やテンプレートの開き方から確かめたい場合は、ComfyUIの必要スペックと画像生成の始め方をまとめた入門記事が先に読める。
Fibo 2.0とは: Bria の画像生成と編集のモデル
Hugging Face の配布ページ (briaai/Fibo-2.0-dev、2026年10月18日に公開) によると、Fibo 2.0 は Bria が公開した80億パラメータ (8B) の画像生成・編集のモデルで、FLUX.2 の VAE の潜在空間で動く flow matching のモデルだという。プロンプトは Qwen3-VL-4B-Instruct で読み取り、編集に渡す画像は VLM と VAE の両方で読み取る、と配布ページは書いている。Edit Turbo の配布ページ (briaai/Fibo-2.0-edit-turbo、10月19日に公開) にも同じ説明がある。
配布ページの説明では、学習に使ったのは照明・構図・色・カメラ・被写界深度をはっきり書いた構造化 JSON のキャプションだ。短いプロンプトや普通の言葉の編集指示を構造化したプロンプトに書き直す役は、Bria が公開している別のパッケージ bria-vgl が受け持つ、とも書かれている。bria-vgl の既定は Google AI Studio 経由の Gemini で、使うには Gemini の API キーが要り、入力は外部のサービスへ送られる。テンプレートのプロンプト拡張 (手元の Qwen3-VL で書き直す) とは別の経路で、今回の測定では使っていない。
Dev と Edit Turbo の違い
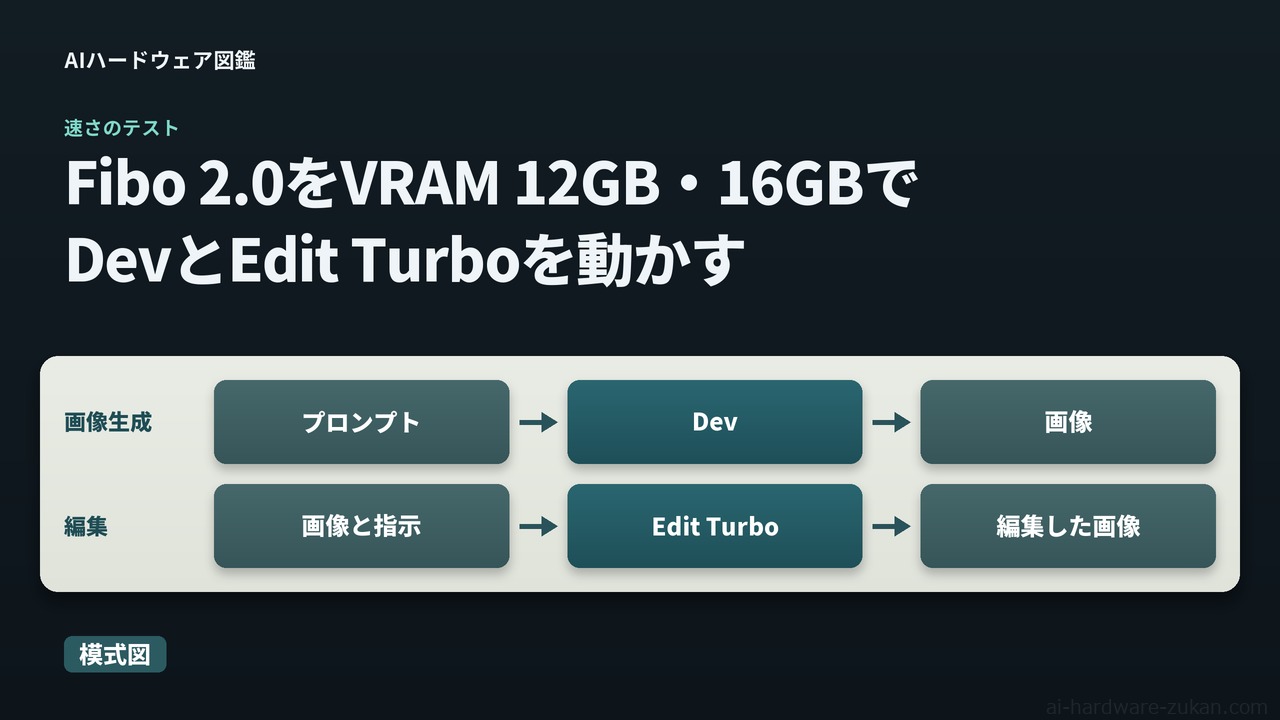
配布されているモデルは Dev と Edit Turbo の2つで、ステップ数と CFG (classifier-free guidance の強さ。ComfyUI ではテンプレートの KSampler にある cfg の値) と用途が違う。2つの配布ページの記載を並べたのが、Dev と Edit Turbo の違いの表になる。
| 項目 | Dev | Edit Turbo |
|---|---|---|
| モデルの種類 | 蒸留していないベースモデル | 蒸留した編集用のモデル |
| classifier-free guidance | 使う | 使わない |
| 指定のステップ数 | 50ステップ | 4ステップ |
| 指定の guidance_scale | 5.0 | 1.0 |
| 用途 | 編集とテキストから画像の両方 (Dev の配布ページ)。テキストから画像は Edit Turbo の配布ページも Dev を指定 | 編集専用 |
| 追加学習 (ファインチューニング) の出発点 | なる | しない |
Dev と Edit Turbo の違いの表から読み取れるのは、Dev が CFG を使って多くのステップを回し、編集とテキストから画像の両方を受け持つベースモデルで、Edit Turbo が少ないステップで編集だけを受け持つ蒸留モデルだという分担だ。Dev の配布ページは、1つのモデルで画像の編集・テキストから画像・繰り返しの手直しをこなす、と書いている。Edit Turbo の配布ページは、Turbo は編集専用で、テキストから画像には Dev を使う、と書いている。Edit Turbo ではネガティブプロンプトは結果に影響しない、とも書かれている。
参照画像と出力の大きさ
編集には参照画像を4枚まで渡せ、指示文の中では <image_1>、<image_2> のように順番で呼ぶ、と配布ページ (briaai/Fibo-2.0-dev) は書いている。この記事で測ったのは、参照画像1枚の編集だけ。
出力の大きさは、学習したときの面積である約1メガピクセルの近くで、16の倍数にする。配布ページでは既定が1024×1024 で、1424×800 (16:9) や 1248×832 (3:2) が例に挙がっている。ComfyUI のテンプレートの注記 (Comfy-Org/workflow_templates の commit 3c2199b9) も、約1メガピクセルで学習したのでその近くにとどめる、と書いている。測ったのは1024×1024 だけ。
配布ページには、Artificial Analysis の比較でオープンウェイトのモデルの中で画像の編集が1位、テキストから画像が2位 (2026年10月20日時点) という Bria の主張も載っている。これは配布元の主張で、順位をこの記事で確かめてはいない。画像の出来も、この記事では評価しない。
ライセンス: 重みは非商用
Bria の2つの配布ページ (briaai/Fibo-2.0-dev・briaai/Fibo-2.0-edit-turbo) は、Dev と Edit Turbo の重みを CC BY-NC 4.0 (Creative Commons Attribution–Non-Commercial) で、非商用の利用に限って公開していると書いている。商用の利用には Bria との商用の契約が要る、という記載もある。
ComfyUI 用にファイルを詰め直した Comfy-Org/Fibo-2.0 の配布も、同じ条件を書いている。README (revision 4742d4be、2026年10月28日更新) は、重みは BRIA AI のもので CC BY-NC 4.0 だとし、非商用の目的に限って使えること、商用には BRIA AI との別の契約が要ることを明記している。CC BY-NC 4.0 には非商用のほかにも条件があり、重みやそれを改変したものを人に渡すときは、クレジットとライセンスの表示を残すことなどが求められる。
ダウンロードの手続きは、2つの配布で違う。Bria の Hugging Face の配布ページは、ダウンロードの前に会社名や利用目的 (Commercial・Academic - Research・Personal から選ぶ) を入力し、商用の利用には別の商用契約が要ることを理解した、という欄にチェックする形になっている。Comfy-Org/Fibo-2.0 の配布には、この入力の手続きがない。2026年10月29日に Hugging Face の API で両方の配布の設定を確かめると、Bria の2つは gated (ダウンロードの前に入力を求める設定)、Comfy-Org/Fibo-2.0 は gated ではなかった。
入力の手続きがないことは、ライセンスの条件が緩いことを意味しない。Comfy-Org/Fibo-2.0 の README も、重みは CC BY-NC 4.0 で非商用に限ると書いている。どの使い方が非商用にあたるかは、この記事では判断しない。条文の原文と Bria のライセンスの案内は、参考資料の一覧に載せた。
そろえるファイルとテンプレートの設定
ローカルで動くテンプレートは編集の2つ
測った ComfyUI は v0.43.0 (2026年10月27日リリース) で、Fibo 2.0 のテンプレートは同梱の comfyui-workflow-templates 0.11.97 に入っている。ローカルで動かすテンプレートは「Fibo 2.0 Dev: Image Edit」と「Fibo 2.0 Turbo: Image Edit」の2つで、どちらも画像の編集のテンプレートだ。同じパッケージにあるもう1つの Fibo 2.0 のテンプレート (api_bria_fibo2_t2i) は Bria の API を呼ぶ Partner Node のテンプレートで、手元の GPU では動かない。ComfyUI の説明では、Partner Node は入力を外部のサービスへ送り、使うには Comfy のアカウントとクレジットが要る。今回の測定には入れていない。これは comfyui-workflow-templates 0.11.97 の中身で確認したもので、ほかのバージョンのテンプレートの一覧は確かめていない。
テンプレートの既定
2つのテンプレートが最初から読み込むファイルとステップ数・CFG などの値を比べるのが、テンプレートの既定の表。中身は Comfy-Org/workflow_templates の commit 3c2199b9 の2つのファイルで、手元の comfyui-workflow-templates 0.11.97 と同じだった。
| 項目 | Turbo のテンプレート | Dev のテンプレート |
|---|---|---|
| テンプレートのファイル | image_fibo2_edit_turbo_pe.json |
image_fibo2_edit_dev_pe.json |
| 拡散モデル | fibo2_edit_turbo_int8_convrot |
fibo2_dev_int8_convrot |
| テキストエンコーダ | qwen3vl_4b_bf16 |
qwen3vl_4b_bf16 |
| VAE | flux2-vae |
flux2-vae |
| ステップ数・CFG | 4・1 | 50・5 |
| サンプラーの設定 | euler・simple | euler・simple |
| ネガティブプロンプト | 空 | 構造化したキャプション (802文字) |
テンプレートの既定の表で2つのテンプレートが違うのは、拡散モデルとステップ数・CFG とネガティブプロンプトで、サンプラーの設定・テキストエンコーダ・VAE は共通になっている。Dev のテンプレートの TextEncodeFibo2 にはネガティブプロンプトとして構造化したキャプションが最初から入っていて、今回の測定でもそのまま使った (測定の記録で802文字)。Turbo のテンプレートの注記も、いちばんきれいな結果を狙うときは negative_prompt を埋めて Dev を回す、と書いている。この注記は「DevとEdit Turboのどちらを使うか」の節で詳しく扱う。
プロンプト拡張と外し方
テンプレートには既定でプロンプト拡張が入っている。テンプレートの注記によると、Fibo 2.0 は構造化したキャプションを読むので、1行の指示と参照画像を Qwen3-VL の8B のモデル (qwen3vl_8b_int8_convrot、8.71GiB) に渡し、場面の詳しい説明に書き直してから TextEncodeFibo2 に渡す。切り替えのノード (ComfySwitchNode) の switch を false にすると、書き直さずに元のプロンプトを使う。8.71GiB は Hugging Face の Comfy-Org/Qwen3-VL にあるファイルの大きさ (9,350,798,360 バイト) を GiB に直した値。プロンプト拡張を入れたときの時間とメモリは測っていない。
今回の構成とテンプレートの既定の違い
今回の測定は、テンプレートの主な設定を API 形式のワークフローに写して行い、どの使い方にも共通する変更は2か所にした。1つはプロンプト拡張を外して、元のプロンプトをそのまま TextEncodeFibo2 に渡したこと。もう1つは、テキストエンコーダを bf16 (qwen3vl_4b_bf16) から int8 (qwen3vl_4b_int8_convrot) に替えたこと。テキストから画像では、さらに参照画像と、TextEncodeFibo2 への VAE の結線も外した。どちらの GPU・どの使い方でも同じ構成で、テンプレートの既定のまま (bf16 のテキストエンコーダ・プロンプト拡張あり) の時間とメモリは測っていない。プロンプト拡張を外したので、画像の出来はテンプレートの既定の使い方とは比べられない。
ファイル名の int8_convrot は、Comfy-Org/Fibo-2.0 の README によると、同じ重みを int8 に量子化したものを指す。量子化にはアダマール回転とチャンネルごとのスケールを使い、adaLN の調整の層は bf16 のまま残している。配布元は、元の出力と少し違うと書いている。bf16 のファイル (拡散モデル15.32GiB) は測っていない。
置くファイル
測定に使ったファイルと、配布にあるが測っていないファイルを並べたのが、置くファイルの表。サイズは、使った4つは手元のファイルのバイト数を、使っていないものは配布元が公表しているバイト数を GiB に直した値で、配布元の表示の GB は10進なので数字が違って見える。
| 役割 | ファイル | サイズ | 置き場所 | 今回 |
|---|---|---|---|---|
| 拡散モデル Dev (int8、テンプレートの既定) | fibo2_dev_int8_convrot.safetensors | 7.83GiB | models/diffusion_models | 使った |
| 拡散モデル Edit Turbo (int8、テンプレートの既定) | fibo2_edit_turbo_int8_convrot.safetensors | 7.83GiB | models/diffusion_models | 使った |
| テキストエンコーダ (int8) | qwen3vl_4b_int8_convrot.safetensors | 4.52GiB | models/text_encoders | 使った |
| VAE | flux2-vae.safetensors | 0.31GiB | models/vae | 使った |
| テキストエンコーダ (bf16、テンプレートの既定) | qwen3vl_4b_bf16.safetensors | 8.27GiB | models/text_encoders | 使っていない |
| 拡散モデル Dev・Edit Turbo (bf16、それぞれ) | fibo2_dev_bf16.safetensors / fibo2_edit_turbo_bf16.safetensors | 15.32GiB | models/diffusion_models | 使っていない |
| プロンプト拡張のモデル (テンプレートの既定) | qwen3vl_8b_int8_convrot.safetensors | 8.71GiB | models/text_encoders | 使っていない |
置くファイルの表のとおり、Dev と Edit Turbo の拡散モデルは int8 どうしで同じ大きさで、テキストエンコーダと VAE は2つの使い方で共通になる。プロンプト拡張のモデルは Comfy-Org/Qwen3-VL の配布で、ほかは Comfy-Org/Fibo-2.0 の配布にある。
テキストから画像の組み方
ローカルで動くテキストから画像のテンプレートは無いので、編集のテンプレートを組み替えて使う。ComfyUI v0.43.0 の TextEncodeFibo2 のノードの説明 (comfy_extras/nodes_fibo2.py) によると、画像をつなぐとプロンプトを編集の指示として扱い、画像をつながなければテキストから画像の入力になる。出力の幅と高さを0のままにすると、画像があれば1枚目の画像の縦横比で約1メガピクセル、画像がなければ1024になる。今回のテキストから画像は、編集のテンプレートから LoadImage のノードと、VAE から TextEncodeFibo2 の vae の入力への線を外した形で測った。VAE Decode につながる VAE はそのまま残す。
1枚にかかる時間
2つの GPU と3つの使い方の組み合わせごとに、1024×1024 の1枚にかかった時間を並べたのが、1枚にかかる時間の表。「1枚目」は ComfyUI を起動して最初の1枚で、モデルの読み込みを含む。「同じプロンプト」は seed を1つずつ進めて作った2〜4枚目の中央値、「プロンプトを変えた3枚」は5〜7枚目の中央値。「サンプリング」以外の列の時間は ComfyUI の「Prompt executed in」の値で、各条件1回ずつ測った。「サンプリング」の列は測り方が違い、サンプラーのノードの区間を指す。ComfyUI が送る「このノードを実行中」の通知を測定のプログラムが受け取った時刻の差で測ったもので、GPU の計算だけの時間ではなく、ノードの中でのモデルの準備や重みの転送も入りうる。
| 条件 | ステップ・CFG | 1枚目 | 同じプロンプト (2〜4枚目の中央値) | プロンプトを変えた3枚 (中央値) | サンプリング (同じプロンプト) |
|---|---|---|---|---|---|
| RTX 4070 SUPER・Dev | 50・5 | 50.02秒 | 46.50秒 | 47.63秒 | 46.13秒 |
| RTX 4070 SUPER・Edit Turbo (編集) | 4・1 | 8.91秒 | 4.85秒 | 6.93秒 | 4.48秒 |
| RTX 4070 SUPER・Edit Turbo (画像なし) | 4・1 | 5.94秒 | 2.29秒 | 3.38秒 | 1.92秒 |
| RTX 5080・Dev | 50・5 | 32.00秒 | 29.42秒 | 29.80秒 | 29.14秒 |
| RTX 5080・Edit Turbo (編集) | 4・1 | 6.36秒 | 3.20秒 | 4.10秒 | 2.91秒 |
| RTX 5080・Edit Turbo (画像なし) | 4・1 | 4.98秒 | 1.52秒 | 1.87秒 | 1.22秒 |
表の「Edit Turbo (画像なし)」は、編集用のモデルに参照画像を渡さずテキストから画像を作った形を指す。この形の扱いは、この節の「画像を渡さない Edit Turbo の扱い」に書く。
図のとおり、どちらの GPU でも Dev の1枚が飛び抜けて長い。同じプロンプトで続けて作ったときの1枚で比べると、Dev のテキストから画像は Edit Turbo の編集の約9.6倍 (RTX 4070 SUPER)・約9.2倍 (RTX 5080) かかった。プロンプトを変えた3枚の中央値どうしでは約6.9倍と約7.3倍に縮む。
「同じプロンプト (2〜4枚目の中央値)」の列どうしで比べると、RTX 5080 は RTX 4070 SUPER より約1.5〜1.6倍速かった (画像なしの Edit Turbo 1.51倍・編集 1.52倍・Dev 1.58倍)。この差には VRAM の大きさだけでなく GPU の世代や性能の違いと、RTX 4070 SUPER を OCuLink (PCIe 4.0 x4) でつないでいることも入っていて、どれがどれだけ寄与しているかは切り分けていない。「プロンプトを変えた3枚 (中央値)」の列どうしでは1.6〜1.8倍で、倍率は条件で変わる。
「1枚目」が長いのは、モデルの読み込みを含むから。条件ごとに ComfyUI を起動し直したが、OS のファイルキャッシュは空にしておらず、同じファイルを直前の条件でも読んでいる。そのため1枚目の読み込みが、ディスクから初めて読んだものか、OS のファイルキャッシュに残っていた分を使ったものかは、条件ごとには確かめていない。
ステップ数と CFG から見た Dev の長さ
「サンプリング (同じプロンプト)」の列で、どちらも参照画像を渡さない条件で測った Dev と Edit Turbo を比べると、Dev のサンプリングは約24倍かかった。RTX 4070 SUPER では46.13秒÷1.92秒、RTX 5080 では29.14秒÷1.22秒で、どちらの GPU でもほぼ同じ倍率になる。
この差の大きさは、ステップ数と CFG から見積もった計算量とほぼ合う。ステップ数は50と4で12.5倍。さらに ComfyUI は CFG が1のときネガティブプロンプトの側の計算を省く (ComfyUI v0.43.0 の comfy/samplers.py にある処理) ので、CFG 5 の Dev では1ステップごとに、プロンプトの側とネガティブプロンプトの側の両方を計算する。2つの計算は1回のモデルの呼び出しにまとめて流されることもある。そこで呼び出しの回数ではなく計算量の目安として見ると、ステップ数の比に1ステップあたりの計算が2つ分になることをかけて25倍になり、今回の測定の約24倍とほぼ合う。この見積もりは、1ステップの重さが同じとした概算だ。2つのモデルは別のチェックポイントで、サンプラーの区間にはモデルの準備や重みの転送も入る。それらを切り分けていないので、時間の差の原因がステップ数と CFG だけだとは確かめていない。
Dev の1ステップは、「サンプリング (同じプロンプト)」を50で割ると、RTX 4070 SUPER で約0.92秒、RTX 5080 で約0.58秒になる。Edit Turbo は4ステップしかなく、最初のステップの準備の分が混ざるので、1ステップの値は出していない。
Dev のテンプレートの注記 (image_fibo2_edit_dev_pe.json、commit 3c2199b9) は、Dev を「いちばんきれいな結果が出る、サンプリングの時間はおよそ12倍」と説明している。注記の「およそ12倍」はステップ数の比 (12.5倍) に近く、CFG の分を含めた数字かは注記から読み取れない。注記が付いているのは編集のテンプレートで、今回の測定の約24倍はテキストから画像で測った値だ。Dev は編集でも CFG 5 で回すが、Dev で編集したときの時間は測っていない。
プロンプトを変えると長くなる分
同じプロンプトの2〜4枚目では、プロンプトと参照画像を読み取るエンコードのノード (TextEncodeFibo2) は前の結果を使い回して実行されなかった (ComfyUI の実行の記録でキャッシュされたノードを確認した)。プロンプトを変えた3枚では毎回このノードが動き、その実行時間を並べたのがエンコードのノードの表になる。この時間は、テキストエンコーダを GPU に載せる処理があればそれも含み、編集では参照画像を VAE で読む処理も含む。
| 条件 | エンコードのノード (3枚の範囲) |
|---|---|
| RTX 4070 SUPER・Dev | 0.81〜0.87秒 |
| RTX 4070 SUPER・Edit Turbo (編集) | 1.57〜1.60秒 |
| RTX 4070 SUPER・Edit Turbo (画像なし) | 0.78〜0.79秒 |
| RTX 5080・Dev | 0.31〜0.32秒 |
| RTX 5080・Edit Turbo (編集) | 0.81〜0.90秒 |
| RTX 5080・Edit Turbo (画像なし) | 0.27〜0.30秒 |
エンコードのノードの表を見ると、エンコードのノードの時間は Dev の1枚に対しては小さく、Edit Turbo の短い1枚に対しては割合が大きい。プロンプトを毎回変えながら Edit Turbo を回すと、同じプロンプトのときより1枚が長くなるのは、主にこの分が乗るためだ。編集では、参照画像もプロンプトと一緒にテキストエンコーダに渡る。プロンプトを変えるとサンプリングも少し延びた条件があるが、その理由は切り分けていない。
編集が画像なしより長い分
参照画像を1枚渡す編集は、同じ4ステップの Edit Turbo でも、画像なしよりサンプリングが約2.3〜2.4倍長かった (RTX 4070 SUPER 4.48秒÷1.92秒、RTX 5080 2.91秒÷1.22秒)。エンコードのノードの時間も、エンコードのノードの表のとおり編集のほうが長い。
配布ページ (briaai/Fibo-2.0-dev) の説明では、編集に渡す画像は VLM と VAE の両方で読み取られ、VAE で読んだ参照の潜在は、生成中の潜在と一緒に画像のトークンとして処理される。時間の差のうちどれだけがどちらから来るかは切り分けていない。
画像を渡さない Edit Turbo の扱い
画像を渡さない Edit Turbo は、配布元が勧めていない使い方 (Turbo は編集専用) で、ここに載せたのは時間で (VRAM は後の節の表にある)、画像の出来は評価していない。テキストから画像を作るときに、Dev と比べてどれだけ速いかの目安として載せた。プロンプト拡張も外した状態の値だ。
出力の例
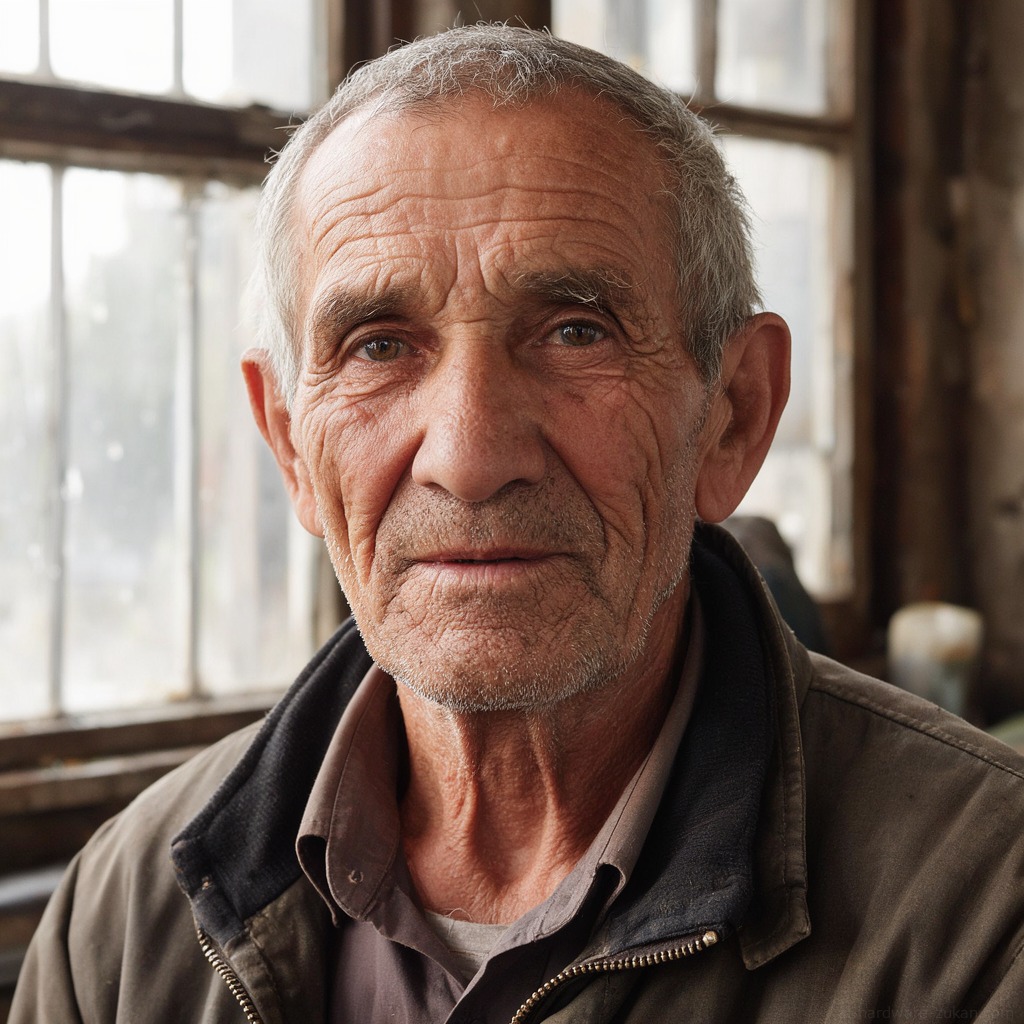
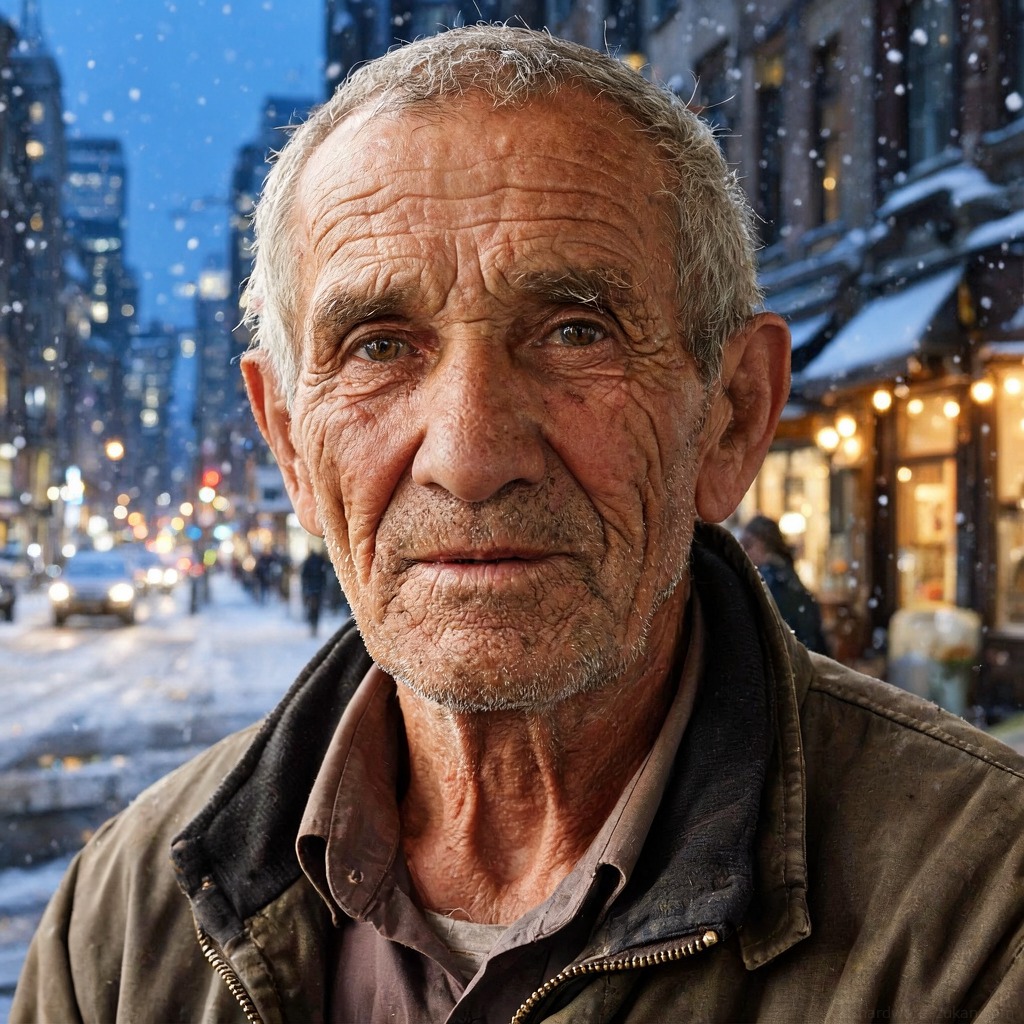
RTX 4070 SUPER で測ったときの1枚目 (seed 12345) から Dev と Edit Turbo の編集の2枚を選び、編集に渡した参照画像と合わせて3つの図にした。どちらもプロンプト拡張は外し、英語で書いた1行のプロンプトをそのまま渡している。Dev のネガティブプロンプトは、テンプレートの既定 (構造化したキャプション、802文字) のまま。画像の出来は比べたり評価したりしていない。
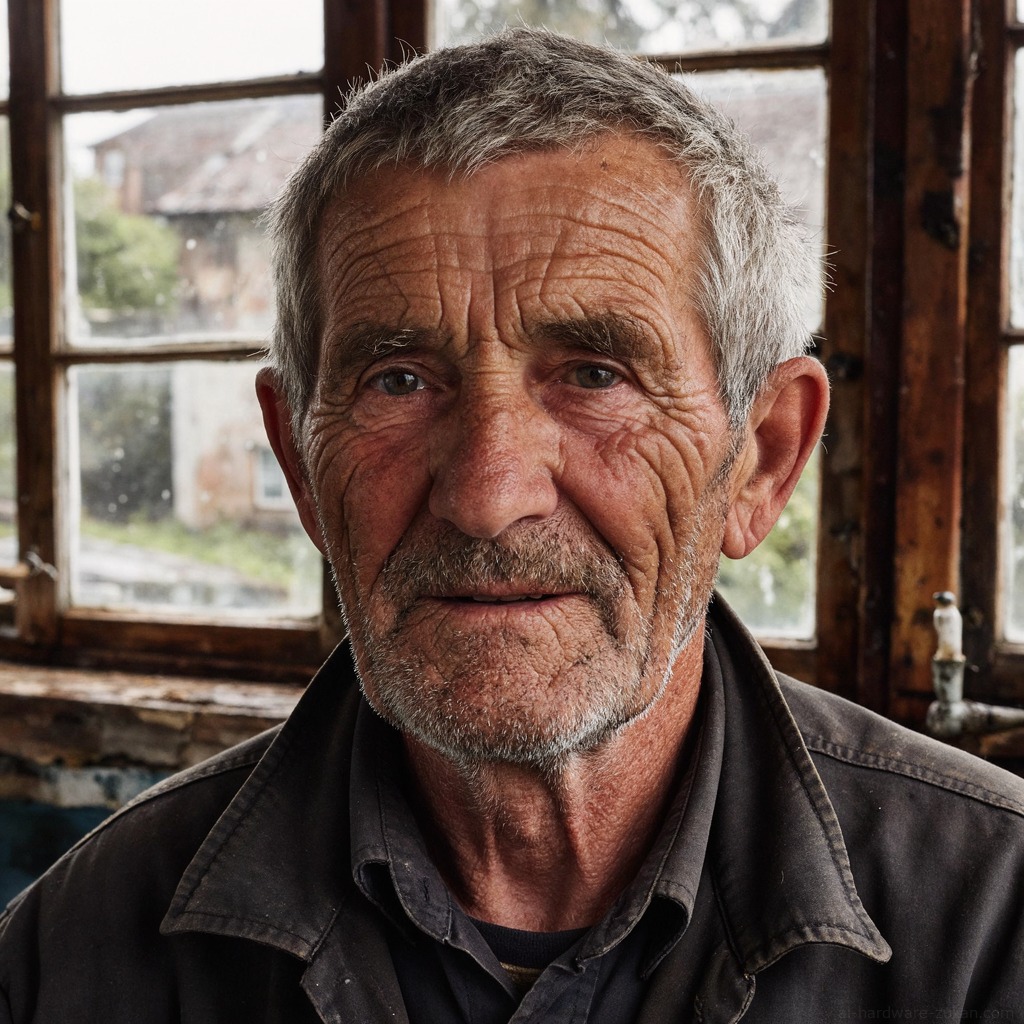
編集に渡した参照画像は、測り方の節に書いた漁師の肖像の1枚。測定とは別に、Dev と同じプロンプトを seed 12345 で画像を渡さない Edit Turbo に回して RTX 4070 SUPER で作った。この1枚に背景を変える指示を出した結果が、参照画像の下の図になる。
VRAM 12GBと16GBでの使われ方
測った2つの GPU では、同じ処理でも VRAM の大きい RTX 5080 のほうがピークが大きかった。nvidia-smi で繰り返し読んだ GPU 全体の使用量を、条件ごとに並べたのが VRAM の使われ方の表。「生成中のピーク」は条件ごと7枚の最大、「生成の合間」は2〜7枚目を始める直前の値の範囲。nvidia-smi は1回読むごとに0.25秒待ったので、読んだ値と値の間の短いピークは拾えていないことがある。
| 条件 | VRAM の総量 | ComfyUI 起動前 | ComfyUI 起動後 | 生成の合間 (2枚目以降の開始時) | 生成中のピーク |
|---|---|---|---|---|---|
| RTX 4070 SUPER・Dev | 12,282MiB | 0MiB | 162MiB | 9,948MiB | 10,932MiB |
| RTX 4070 SUPER・Edit Turbo (編集) | 12,282MiB | 0MiB | 162MiB | 9,276〜9,404MiB | 10,934MiB |
| RTX 4070 SUPER・Edit Turbo (画像なし) | 12,282MiB | 0MiB | 162MiB | 9,948MiB | 10,932MiB |
| RTX 5080・Dev | 16,303MiB | 1,177MiB | 1,404MiB | 13,606〜13,608MiB | 14,430MiB |
| RTX 5080・Edit Turbo (編集) | 16,303MiB | 1,177MiB | 1,404MiB | 13,768〜13,928MiB | 15,474MiB |
| RTX 5080・Edit Turbo (画像なし) | 16,303MiB | 1,177MiB | 1,404MiB | 13,606〜13,607MiB | 14,430MiB |
21枚それぞれのピークの範囲で見ると、生成中の VRAM のピークは RTX 4070 SUPER で10,710〜10,934MiB (約10.5〜10.7GiB)、RTX 5080 で14,388〜15,474MiB (約14.1〜15.1GiB) だった。VRAM の使われ方の表の値は、その中の条件ごとの最大にあたる。ピークは GPU 全体の使用量で、ComfyUI 以外の分も含む。RTX 5080 は画面の表示もしていて、ComfyUI の起動前から1,177MiB 使われていた。RTX 4070 SUPER は画面の表示をしておらず、起動前は0MiB だった。画面の表示も受け持つ VRAM 12GB の GPU では、ComfyUI が使える VRAM がその分減るが、その状態は測っていない。
起動前から使われていた分を引いても、RTX 5080 のピークは RTX 4070 SUPER より約2,300〜3,400MiB 多い (画像なし・Dev で2,321MiB、編集で3,363MiB)。ComfyUI のログでは、3つのモデルとも「prepared for dynamic VRAM loading」と出ていた。ComfyUI の dynamic VRAM は空いている VRAM に重みを置いておくので、このピークは「この量がないと動かない」という値ではない。VRAM 8GB など、もっと小さい GPU で動くかは測っていない。
1枚を作り終えたあとも、次の1枚の開始まで VRAM は大きく減らなかった。同じ ComfyUI の中で続けて作ったとき、2枚目以降の開始時点で RTX 4070 SUPER は9,276〜9,948MiB、RTX 5080 は13,606〜13,928MiB 使われていた。
dynamic VRAM が VRAM をどう使うかの詳しい説明は、ComfyUIの起動オプションと VRAM の使われ方を実測した記事にまとめてある。
DevとEdit Turboのどちらを使うか
どちらを使うかは、画像の作り方で決まる。使い方ごとに、配布元とテンプレートの注記が挙げるモデルを並べたのが、使い方ごとのモデルの表。
| 使い方 | 使うモデル | 配布元・テンプレートの記載 |
|---|---|---|
| テキストから画像を作る | Dev | Edit Turbo の配布ページが、Turbo は編集専用で、テキストから画像には Dev を使う、と書いている |
| 画像の編集を何度も試す | Edit Turbo | Turbo のテンプレートの注記が、Turbo は方向を素早く試すためのもの、と書いている |
| 編集でいちばんきれいな1枚を狙う | Dev (Dev での編集の時間は測っていない) | Turbo のテンプレートの注記が、fibo2_dev_int8_convrot を読み込み、negative_prompt を埋めて50ステップ・CFG 5 で回す、と書いている |
使い方ごとのモデルの表のうち、テキストから画像は配布元の指定がはっきりしている。Edit Turbo は蒸留した編集用のモデルで、classifier-free guidance を使わず4ステップで編集する。編集の方向を探る段階では、1枚の待ち時間の短い Edit Turbo で試す流れになる。
編集の仕上げに Dev を使う場合の時間は、今回は測っていない。Dev のテンプレートの注記は、Dev のサンプリングの時間をおよそ12倍と説明していて、今回の測定のテキストから画像の約24倍とは一致しない。その理由は確かめていない。約12倍は Dev の編集のテンプレートの注記にある概算で、今回の測定で確かめた値ではない。約24倍は両方とも画像を渡さずに測ったサンプリングの比 (Edit Turbo の編集と比べると約10倍) で、Dev で編集したときの時間には当てはめられない。
画像を渡さない Edit Turbo は、配布元が勧めていない使い方で、測ったのは時間と VRAM の使用量だけだ。画像の出来も評価していないので、使い方ごとのモデルの表には、テキストから画像の候補として入れていない。
同じ VRAM 16GB の GPU で別の画像生成モデルを動かした結果は、FLUX.3 Image Klein を VRAM 16GB で動かした記事で読める。
検証環境と測り方
測定は2026年10月29日 16時32分〜16時47分 (日本時間) に行った。測定機の構成は検証環境の表のとおり。
| 項目 | 内容 |
|---|---|
| GPU | RTX 4070 SUPER (VRAM 12GB、OCuLink の PCIe 4.0 x4 で外付け) / RTX 5080 (VRAM 16GB) |
| メインメモリ | 96GiB (OS の表示で95.78GiB) |
| ドライバ | 610.88 |
| ComfyUI | v0.43.0 (commit 426f5eea) |
| PyTorch | 2.14.0+cu130 |
| Python | 3.12.10 |
| comfy-kitchen | 0.2.40 |
| comfy-aimdo | 0.6.0 |
| 注意機構 (ComfyUI の表示) | pytorch attention |
1つの GPU で1つの ComfyUI を動かし、2つの GPU を同時には使っていない。条件ごとに ComfyUI を起動し直し、1枚目、同じプロンプトで seed を1つずつ進めた3枚、プロンプトを変えた3枚の順に7枚作った。時間は ComfyUI が出す「Prompt executed in」の値、サンプリングはサンプラーのノードの区間 (実行中のノードの通知を受け取った時刻の差)。VRAM は nvidia-smi で繰り返し読み、1回読むごとに0.25秒待った (実際の間隔は読む時間の分だけ長い)。Windows で動かし、ComfyUI の起動ログで、使った GPU が cuda:0 として認識されていることと GPU の名前を確かめた。プレビューは切った (--preview-method none)。表の「同じプロンプト」と「プロンプトを変えた3枚」は3枚の中央値で、各条件1回ずつの測定。
テキストから画像のプロンプトは英語の4つで、年配の漁師の肖像 (1〜4枚目)、大理石の台の香水瓶、日の出の霧の谷、日本語の文字が入った木のカフェの看板。編集の参照画像は、同じ日に画像なしの Edit Turbo で作った1024×1024 の漁師の肖像1枚で、指示は英語の4つ (背景を雪の街に・夕方の光とフィルムの粒子・水彩画風・雨の夜とネオン)。プロンプトと指示は測定の記録に残した文で、日本語で書いたプロンプトは測っていない。
使ったファイルの sha256 は、Hugging Face の Comfy-Org/Fibo-2.0 に載っている値と一致した。対象は fibo2_dev_int8_convrot・fibo2_edit_turbo_int8_convrot・qwen3vl_4b_int8_convrot・flux2-vae の4ファイル (使い方ごとに3つ) で、2026年10月29日に確認した。
本記事の実測値は2026年10月29日に、上記の測定機・設定で計測したもの。
測定機の詳しい構成は検証環境のページに、ほかの GPU やモデルの実測はAIハードウェア実測データベースにまとめている。
測っていないこと
手元で試すときに気になりやすい順に、今回測っていない項目を並べる。
- 画像の出来の評価 (どの使い方・どの GPU でも比べていない。「出力の例」の画像は例として載せたもので、評価ではない)
- テンプレートの既定のプロンプト拡張 (8B のモデル) を入れたときの時間とメモリ
- bf16 のテキストエンコーダ・bf16 の拡散モデル
- Dev での編集
- 参照画像2〜4枚の編集
- 1024×1024 以外の大きさ
- VRAM 8GB 以下の GPU
- 画面の表示も受け持つ VRAM 12GB の GPU
- メインメモリが96GiB より少ない PC
- RTX 4070 SUPER を PC の中の PCIe x16 につないだとき
- ほかの NVIDIA の GPU と AMD の GPU
- 日本語のプロンプト
- Comfy-Org の配布にある LoRA (fibo_2.0_turbo_lora_avg_rank_270_bf16)
- Linux や Diffusers での実行
まとめ
メインメモリ96GiB の測定機で、プロンプト拡張を外しテキストエンコーダを int8 にした構成では、VRAM 12GB の RTX 4070 SUPER (OCuLink 接続) でも、読み込むファイルの合計が VRAM を上回る状態のまま、3つの使い方を最後まで生成できた。テンプレートの既定のまま動かすと構成が変わるので、この結果はそのままは当てはまらない。
テキストから画像は Dev、編集の試行は Edit Turbo という分け方は配布元とテンプレートの注記に沿ったものだ。手元の時間では、Dev のテキストから画像の1枚は Edit Turbo の編集の約9.2〜9.6倍かかった。両方とも画像を渡さずに比べたサンプリングは約24倍で、ステップ数と CFG から見積もった計算量 (25倍) とほぼ合った。画像を渡さない Edit Turbo の値は、時間の目安にとどまる。
Fibo 2.0 の拡散モデルの重みは、Bria の配布でも Comfy-Org の配布でも CC BY-NC 4.0 で、非商用に限られる。一緒に使うテキストエンコーダ (Qwen3-VL) と VAE (FLUX.2 の VAE) は Fibo 2.0 とは別に作られた部品なので、使う条件はそれぞれの元の配布で確かめる。Comfy-Org の配布にダウンロード前の入力がないことは、条件が違うことを意味しない。
参考資料
- briaai/Fibo-2.0-dev (Hugging Face)
- briaai/Fibo-2.0-edit-turbo (Hugging Face)
- Comfy-Org/Fibo-2.0 (Hugging Face)
- Comfy-Org/Qwen3-VL (Hugging Face)
- Creative Commons Attribution-NonCommercial 4.0 International (CC BY-NC 4.0)
- Bria のライセンスと料金 (Fibo 2)
- ComfyUI v0.43.0 リリース (GitHub)
- Comfy-Org/workflow_templates image_fibo2_edit_turbo_pe.json (GitHub)
- Comfy-Org/workflow_templates image_fibo2_edit_dev_pe.json (GitHub)
- ComfyUI v0.43.0 comfy_extras/nodes_fibo2.py (GitHub)
- ComfyUI v0.43.0 comfy/samplers.py (GitHub)