ComfyUI

ComfyUIの導入、ワークフロー、拡張機能、必要スペックをまとめます。

画像・動画生成の実測をもとに、導入方法と安定して動かす条件を確認できます。
ComfyUI

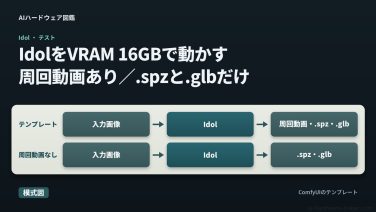
IdolをVRAM 16GBで動かす|周回動画まで書き出すか、.spzと.glbだけにするか

1枚の画像から3Dを作るIdolを、ComfyUIのテンプレートでRTX 5080とRTX 5060 Ti (16GB) で測った。1枚の時間の内訳、周回動画を外したときの時間、VRAMのピーク、.glbの大きさ、元のTripoSplatとの見た目の違いまで。
AI画像生成

P-H3-ImageをVRAM 16GBで動かす|ComfyUIで8MP生成、RTX 5080・5060 Tiの実測とw4a8・int8の選び方

P-H3-Imageの8MP生成を、VRAM 16GBのRTX 5080・5060 TiとComfyUI 0.44.0で実測。配布元はピーク21GBと書くが、2枚とも最後まで通り、2本目は約21秒と約40秒。w4a8とint8の本体の違い、プロンプト拡張と編集の時間と結果もまとめた。
AI動画生成

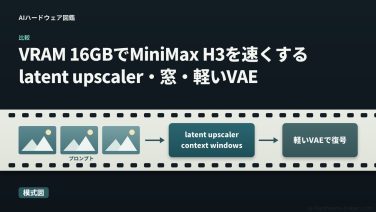
MiniMax H3をVRAM 16GBで速くする|latent upscaler・context windows・軽いVAEはどれを使うか

MiniMax H3をComfyUI 0.44で動かし、latent upscalerとcontext windowsの時間をRTX 5080で、映像VAE 5種の復号をRTX 5080/5060 Tiで実測。8秒の動画は1169秒が397〜616秒に縮んだが、構図や動きは変わった。
AI動画生成

FastH3 OmniをVRAM 16GBで動かす|元のMiniMax H3のTurbo LoRAとどちらを使うか

FastH3 OmniをRTX 5080とRTX 5060 Ti(VRAM 16GB)のComfyUI v0.43.0で実測。元のMiniMax H3・Turbo LoRAとの時間、INT8・NVFP4・FP8の違い、15秒の動画や参照を足したときの時間とメモリを比べた。
AI画像生成

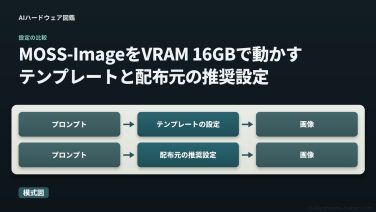
MOSS-ImageをVRAM 16GBで動かす|テンプレートと配布元の推奨設定を比較

MOSS-ImageをComfyUIとVRAM 16GBのRTX 5080・5060 Tiで実測。テンプレートの設定と配布元の推奨設定では1枚の時間が約1.9倍違い、構図の大枠は同じだった。プロンプト拡張で増える秒数、日本語の文字、本体のint8とbf16の違い、2048×2048の共有GPUメモリもまとめた。
AI画像生成

Qwen-Image-2.1-TurboをVRAM 16GBで動かす|8ステップでベースの25ステップより何倍速いか、ComfyUIの刻みと公式の刻みの違いも実測

メインメモリ96GB・Windows 11 の測定機では、測った組み合わせ (Turbo 本体 int8_convrot、Turbo 本体 bf16、ベース+Turbo の LoRA) はどれも RTX 5080 と RTX 5060 Ti (どちらも VRAM 16GB) で最後まで生成できた。
AI画像生成

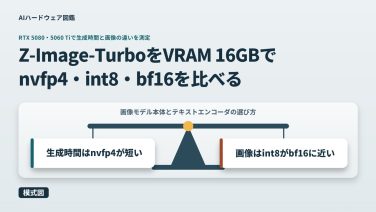
Z-Image-TurboをVRAM 16GBで動かす|nvfp4・int8・bf16はどれを選ぶか、生成時間と画像の違いをRTX 5080・5060 Tiで比較

Z-Image-TurboをComfyUIでRTX 5080・5060 Ti(VRAM 16GB)に載せて実測。画像モデル本体3種(bf16・int8_convrot・nvfp4)とテキストエンコーダ3種の9通りで、速さ・VRAMとメインメモリの使い方・同じseedでの画像の違いを比べ、目的別の選び方をまとめた。
AI画像生成

Ming-Image-0.1-DesignをVRAM 16GBで動かす|透過PNGは2048×2048で抜けやすく、プロンプト拡張は既定のmtp設定のままだと止まる

Ming-Image-0.1-DesignをComfyUIとVRAM 16GBで実測。配布ファイルの4つの組み合わせの所要時間とメインメモリ、背景が透明なPNGが抜けやすい解像度、公式テンプレートのプロンプト拡張を動かす設定をRTX 5080・5060 Tiで確かめた。
AI動画生成

Wan Animate 2をVRAM 16GBで動かす|PyTorchのバージョンとキャッシュの置き場で所要が変わる実測

Wan Animate 2 を VRAM 16GB の RTX 5080・5060 Ti で動かした実測。480×848・81フレームはどの設定でも生成でき、所要を最も大きく変えたのは PyTorch の CUDA 版だった。キャッシュの置き場ごとの所要とホストRAMもまとめた。
AI画像生成

Qwen-Image-2.1をVRAM 16GBで動かす|30GiBのbf16も動く、量子化版はPyTorch cu130なら速い実測

Qwen-Image-2.1 のファイル一式は組み合わせで13.27〜30.21GiB。合計30.21GiB の bf16 同士も16GBのカードで生成できた。PyTorch cu130 版では量子化版が bf16 同士より1.7〜2.3倍速く、cu128 版では逆に遅かった理由もまとめた。