この記事の要点
標準の解像度で試した蒸留版 (少ないステップで出すように作られた版) のモデルファイルの組み合わせは、測った2枚の GPU のどちらでも最後まで画像を出せた。いちばん速かったのは蒸留版の int8 にテキストエンコーダの int8 を組む形で、nvfp4 はそれより遅く、bf16 はさらに大きく遅れた。
配布元が使うよう求めるプロンプト拡張 (短い指示を場面全体の説明文に書き直す別の言語モデル) を通すと、1枚の時間ははっきり伸びる。前の世代のモデルと拡張なしの同じ説明文で比べると1枚はこちらのほうが短いが、拡張込みでは前の世代の拡張なしより長くなる。日本語の看板は、試した分ではこちらだけが正しく描いた。
最も大きい解像度も生成までは進んだが、画像に戻す段で VRAM に収まらず、記録した GPU ではドライバがメインメモリを共有 GPU メモリとして貸していた。
FLUX.3 Image KleinはVRAM 16GBで動くか
RTX 5080 と RTX 5060 Ti はどちらも VRAM 16GB で、メインメモリ96GiB の測定機では、両方の GPU で測った組み合わせ (1024×1024 の蒸留版の6通り、プロンプト拡張つき、FLUX.2 Klein 9B との比較、4096×4096) がどちらでも最後まで生成できた。2048×2048・3840×2160・参照画像を使う編集・base 版は RTX 5080 だけで測っている。いちばん速かったのは蒸留版の int8 とテキストエンコーダの int8 の組み合わせで、1024×1024 の1枚あたりは RTX 5080 で4.04秒、RTX 5060 Ti で7.19秒だった。配布元が必須とするプロンプト拡張を入れると、11.86秒・16.00秒に伸びる。RTX 5060 Ti は外付けの OCuLink (PCIe 4.0 x4) でつないだ板で、この記事の RTX 5060 Ti の値はすべてこの接続での値になる。PCIe スロットに挿した場合に同じになるかは測っていない。
FLUX.3 Image Klein は Black Forest Labs が公開したオープンウェイトの画像生成モデルで、配布元の表記は『FLUX 3 Image Klein』(数字の前に点が無い)。この記事では前の世代の FLUX.2 と並べやすいよう FLUX.3 Image Klein と書く。配布元のモデルカードによれば大きさは 5.6B (56億パラメータ)。この数は画像を作る部分のもので、テキストエンコーダは別に数える。文章からの画像生成と画像の編集を1つのモデルでこなし、プロンプトと最大10枚の参照画像を受け取って1枚の画像を返す、と説明されている。ComfyUI は v0.41.0 のリリースで FLUX.3 の画像モデルへの対応を加え、配布元も ComfyUI v0.41 用のワークフローを配っている。
前の世代の FLUX.2 Klein 9B を同じ VRAM 16GB で動かした結果はFLUX.2 Klein 9BをVRAM 16GBで実測で扱っている。すでにそちらを使っている場合は、この記事の中ほどで同じ説明文・同じ seed を使って2つを並べた節が入口になる。
FLUX.3 Image Kleinの中身とライセンス
配布されるチェックポイントは蒸留版と base 版の2つ。蒸留版は少ないステップで画像を出せるように作られた版で、配布元の既定は16ステップ・ガイダンスなし。base 版のほうは50ステップ・CFG 3.5 が既定とされている。
5.6B は画像を作る部分 (トランスフォーマー) の大きさで、文章を読むテキストエンコーダには Qwen3-VL-4B-Instruct が別に要る。ComfyUI では、画像を作るモデル、テキストエンコーダ、画像に戻す VAE をそれぞれ別のファイルとして置く。
配布元の発表は、上位の FLUX 3 Image と共通の機能として、ネイティブの 4K 生成、画素単位の編集、要素の位置を指定する bounding box を挙げ、最大10枚の参照画像を使った生成にも対応するとしている。bounding box は、プロンプトの中で 0〜1000 の格子の箱を使って要素の位置と大きさを指定する機能で、モデルカードによれば箱は配置の目安であり、画素をその範囲に閉じ込めるマスクではない。この記事で時間を測ったのは、このうち 4K と参照画像の2つ。前の世代との比較としては、FLUX.2 Klein 9B に対して文章からの画像生成で 91 Elo、編集で 70 Elo 上回り、パラメータは38%少ないとしている。これは Black Forest Labs 自身の評価の数字で、この記事では画質を比べていない。
ライセンスは FLUX Kommunity License v1.0。モデルカードの License 節では、非商用の利用に加えて、関連会社を含めた年換算の総売上が500万米ドル未満の利用者に、ライセンスの条件のもとで生成物の商用利用を認めている。利用者を問わず商用に使えるライセンスではなく、それ以外の使い方は配布元の商用ライセンスの案内による。個別の使い方が認められるかどうかは、ライセンス本文で確かめる必要がある。
どのファイルを使うか
ファイルを選ぶときに決めるのは、蒸留版か base 版かと、精度 (数値の持ち方) の2つだ。int8・NVFP4・BF16 はモデルの重みを持つ精度の違いで、int8 や NVFP4 のように精度を落とすことを量子化と呼ぶ。精度を落とした形式ほどファイルは小さく、配布元は精度とチェックポイントを選んでファイル名を差し替えるよう案内している。なお、Hugging Face の配布ページは、連絡先の共有に同意しないとファイルを取得できない形になっていて、ログインも要る。
配布元は2026年10月17日に画像生成のファイル名をハイフン区切りに改め、名前に -base- が入っているものが base 版、それ以外が蒸留版になった。蒸留版の int8 は flux3-image-klein-int8-convrot、base 版の int8 は flux3-image-klein-base-int8-convrot だ。それより前の名前では _sd_ が入っているものが蒸留版で、印の無いものが base 版だった。_sd_ も -base- も無い名前は、旧名では base 版、新名では蒸留版を指し、新旧で逆になる。取り違えに注意が要る。古い名前のファイルは、同じ10月17日のあとの更新でリポジトリから消えた。新しい名前の画像生成のファイル6本は、配布元が公開している sha256 が、この記事の測定 (2026年10月16日) に使った古い名前のファイルと一致する。つまり中身は同じだ。
下の表は、2026年10月17日に確認した配布元のモデルカードのファイル表から、蒸留版とその周りのファイルを並べたもので、サイズは配布元の表記をそのまま写した。プロンプト拡張は int8 版のほかに、w4a8 版と BF16 版も表に載っている。BF16 版の拡張はこの記事では測っていない。
| 役割 | ファイル | サイズ |
|---|---|---|
| 画像生成 (蒸留版 int8) | flux3-image-klein-int8-convrot.safetensors | 5.8 GB |
| 画像生成 (蒸留版 NVFP4) | flux3-image-klein-nvfp4.safetensors | 5.3 GB |
| 画像生成 (蒸留版 BF16) | flux3-image-klein-bf16.safetensors | 11.1 GB |
| テキストエンコーダ (int8) | qwen3vl_4b_int8_convrot.safetensors | 4.9 GB |
| テキストエンコーダ (BF16) | qwen3vl_4b_bf16.safetensors | 8.9 GB |
| プロンプト拡張 (int8) | qwen3.5_9b_flux3_prompt_upsampler_int8_convrot.safetensors | 9.8 GB |
| プロンプト拡張 (w4a8) | qwen3.5_9b_flux3_prompt_upsampler_w4a8.safetensors | 6.7 GB |
| プロンプト拡張 (BF16) | qwen3.5_9b_flux3_prompt_upsampler_bf16.safetensors | 18.8 GB |
| VAE | flux2-vae.safetensors | 0.3 GB |
この記事でいちばん速かったのは、蒸留版 int8 (flux3-image-klein-int8-convrot.safetensors、測定に使った古い名前は flux3_image_klein_sd_int8_convrot.safetensors) にテキストエンコーダ int8 (qwen3vl_4b_int8_convrot.safetensors) と VAE (flux2-vae.safetensors) を組む形だった。配布元どおりにプロンプト拡張を使うなら、表のプロンプト拡張のファイルも加わる。配布元のダウンロード例の4つ (蒸留版 int8・テキストエンコーダ int8・VAE・プロンプト拡張 int8) は、表のサイズの合計で約20.8 GB になる。NVFP4 や BF16 の蒸留版とどれだけ差があったかは、後の1024×1024の節で実測の表にしている。
形式の選び方について、配布元は、int8 のファイルは RTX 3070 のような VRAM 8GB の GPU や、FP8 に対応しない GPU (RTX 30 シリーズ以前) で動き、NVFP4 には Blackwell 世代の GPU が要ると説明している。VRAM 8GB の GPU はこの記事では測っていない。
プロンプト拡張を入れると何秒増えるか
配布元は、プロンプト拡張なしではこのモデルを使わないよう案内している。FLUX.3 Image Klein は場面全体を書いた説明文を入力にとるモデルで、短いプロンプトを打ったまま入れるとありきたりな絵になる、というのが配布元の説明だ。
テンプレートでの扱いは、ComfyUI の版で変わっている。配布元のモデルカードは、2026年10月16日の時点で、テンプレートごとの扱いを次のように書いていた。文章からの画像生成のテンプレートでは、蒸留版はプロンプト拡張 (enable_prompt_upsampler) が最初から on、base 版は off。編集のテンプレートにはプロンプト拡張の手順が無く、拡張した説明文を自分で貼る使い方になる。同じ日に取得した配布元のワークフローと、ComfyUI 0.41.0 に付くテンプレート (comfyui-workflow-templates 0.11.84) はこの記述どおりだった。配布元のワークフローは10月17日の更新で差し替わり、モデルカードも、参照画像や bounding box を使うときも含めて最初からプロンプト拡張を使う、と書くようになった。差し替わった後のワークフローの中身は、この記事では確かめていない。
2026年10月16日に出た ComfyUI v0.41.2 は、テンプレートの指定を 0.11.86 に上げている。0.11.86 のテンプレートでは、base 版の文章からの画像生成も拡張が on になり、プロンプト拡張のモデルは w4a8 版に替わり、base 版のファイル名は印の無い名前から flux3_image_klein_base_int8_convrot に替わり、編集のテンプレートにもプロンプト拡張の手順が加わった。10月17日に出た ComfyUI v0.41.3 はテンプレートの指定を 0.11.87 に上げ、0.11.87 のテンプレートが読みに行く画像生成のファイルは新しい名前 (蒸留版は flux3-image-klein-int8-convrot、base 版は flux3-image-klein-base-int8-convrot) に替わった。手元の ComfyUI の版によって、開いたときの拡張の有無と読みに行くファイルが違うので、テンプレートを開いた画面で確かめるのが確実だ。
時間の面では、プロンプト拡張は1枚の所要をはっきり伸ばした。蒸留版 int8・テキストエンコーダ int8・1024×1024・16ステップで、短いプロンプトから毎回拡張する使い方を測った結果が次の表になる。「うち拡張」は拡張の文章を書く TextGenerate ノードの所要で、値は 4 seed × 3 周の2回目以降の中央値。
| プロンプト拡張 | RTX 5080 (1枚) | うち拡張 (5080) | RTX 5060 Ti (1枚) | うち拡張 (5060 Ti) |
|---|---|---|---|---|
| なし | 4.04秒 | — | 7.19秒 | — |
| int8 (モデルカードの案内) | 11.86秒 | 5.71秒 | 16.00秒 | 7.36秒 |
| w4a8 | 10.08秒 | 5.09秒 | 14.77秒 | 6.82秒 |
モデルカードが案内する int8 版でプロンプト拡張を通すと、短いプロンプトからの1枚あたりは RTX 5080 で11.86秒、RTX 5060 Ti で16.00秒になり、拡張なしの4.04秒・7.19秒より7.82秒・8.81秒増えた。そのうち拡張の文章を書く部分 (TextGenerate) は5.71秒・7.36秒で、RTX 5080 ではこの部分だけで拡張なしの1枚を上回り、RTX 5060 Ti ではほぼ同じだった。増えた分のうち TextGenerate の外側の2.11秒・1.45秒の内訳は切り分けていない。毎回プロンプト拡張とテキストエンコーダが動く使い方での値だ。
プロンプト拡張を w4a8 版 (qwen3.5_9b_flux3_prompt_upsampler_w4a8) に替えると、RTX 5080 で10.08秒、RTX 5060 Ti で14.77秒で、int8 版の拡張より少し短かった。拡張が書いた文章の中身は比べていない。
なお、拡張なしの行には、int8 のプロンプト拡張が先に書いた説明文を固定で与えた。int8 の拡張は同じプロンプトからは seed を変えても同じ説明文を書いたので、int8 の行は RTX 5060 Ti の看板のプロンプトを除いて、拡張なしの行と同じ説明文から絵を作っている。w4a8 の行は別の説明文を書いていた。場面全体の説明文を自分で書いて貼る使い方なら、時間の目安はこの拡張なしの行になる。拡張なしと拡張ありで絵がどう違うかも比べていない。
FLUX.2 Klein 9Bと比べる: 1枚の時間
同じ ComfyUI 0.41.0 で、前の世代の FLUX.2 Klein 9B を同じ拡張済みの説明文・同じ seed で回すと、1枚は FLUX.3 Image Klein のほうが短かった。どちらもプロンプト拡張は通していない。FLUX.2 Klein 9B は Q8_0 の GGUF とテキストエンコーダ Qwen3 8B fp8mixed の組み合わせで、ステップは前の世代の実測記事と同じ4。表は1024×1024・4 seed × 3 周の2回目以降の中央値で、「うちサンプラー」は画像を作るノード (KSampler) の所要。
| モデル | ステップ | RTX 5080 (1枚) | うちサンプラー (5080) | RTX 5060 Ti (1枚) | うちサンプラー (5060 Ti) |
|---|---|---|---|---|---|
| FLUX.3 Image Klein 蒸留版 int8 + テキストエンコーダ int8 | 16 | 4.04秒 | 2.91秒 | 7.19秒 | 5.74秒 |
| FLUX.2 Klein 9B Q8_0 (GGUF) + Qwen3 8B fp8mixed | 4 | 7.96秒 | 4.62秒 | 13.01秒 | 9.13秒 |
1枚あたりは、FLUX.2 Klein 9B が RTX 5080 で7.96秒、RTX 5060 Ti で13.01秒。FLUX.3 Image Klein の蒸留版 int8 は4.04秒・7.19秒だった。FLUX.3 Image Klein は16ステップ、FLUX.2 Klein 9B は4ステップで、ステップは4倍あっても1枚は短い。ただし量子化の方式 (GGUF Q8_0 と int8_convrot) もテキストエンコーダ (Qwen3 8B fp8mixed と Qwen3-VL 4B int8) も違い、サンプラー以外の所要も FLUX.2 Klein 9B のほうが長い (RTX 5080 で3.34秒対1.13秒) ので、この差をモデルの構造の違いだけによるものとは読めない。
これは拡張なし同士の比較だ。FLUX.3 Image Klein を配布元どおり短いプロンプトから拡張して使うと11.86秒・16.00秒で、拡張なしの FLUX.2 Klein 9B (7.96秒・13.01秒) より長い。FLUX.2 Klein 9B に拡張を足した時間は測っていない。比較に使った説明文は FLUX.3 Image Klein のプロンプト拡張 (int8) が書いたもので、FLUX.2 Klein 9B にも同じ文を渡した。FLUX.2 Klein 9B 向けに書き直した説明文では試していない。
日本語の看板を描かせた3枚
続けて、日本語の看板 (『秋の新メニュー』『栗のモンブラン 580円』) を描かせる説明文を RTX 5080 で2つのモデルに渡し、seed を変えて3枚ずつ出した文字を目で読んだ。
| seed | FLUX.3 Image Klein | FLUX.2 Klein 9B |
|---|---|---|
| 444 | 秋の新メニュー / 栗のモンブラン 580円 (指定どおり) | 『メニュー』が崩れる・『栗』が別の字・『モンバラン』 |
| 1444 | 秋の新メニュー / 栗のモンブラン 580円 (指定どおり) | 『メニュー』が崩れる・『栗』が別の字・『モンバラン』 |
| 2444 | 秋の新メニュー / 栗のモンブラン 580円 (指定どおり) | 『メニュー』の『ニ』が抜ける・『栗』が別の字 (『モンブラン 580円』は正しい) |
FLUX.3 Image Klein は3枚とも2行の文字をそのまま描いた。FLUX.2 Klein 9B は3枚とも、どこかの文字が崩れたり別の字になったりした。崩れたのは『栗』とカタカナの並び (『メニュー』『モンブラン』) で、『580円』は3枚とも正しかった。
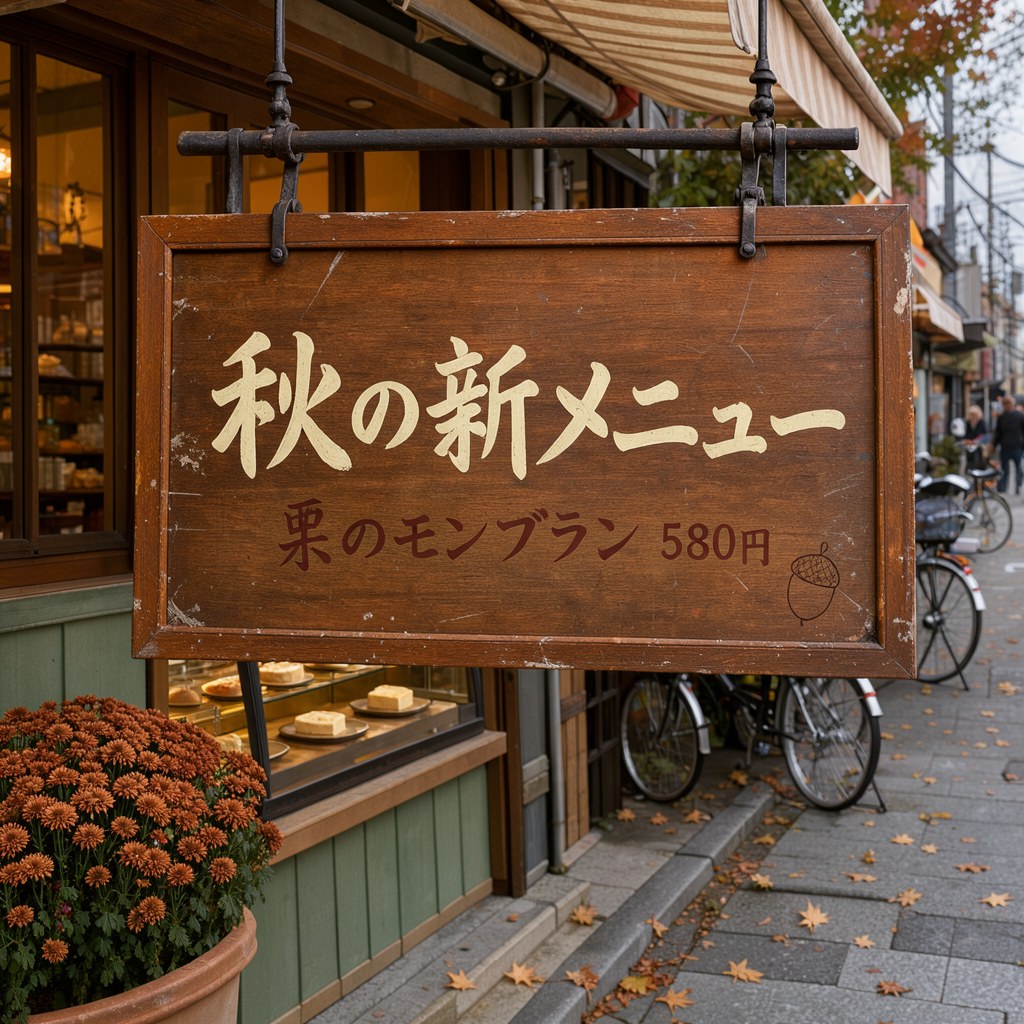
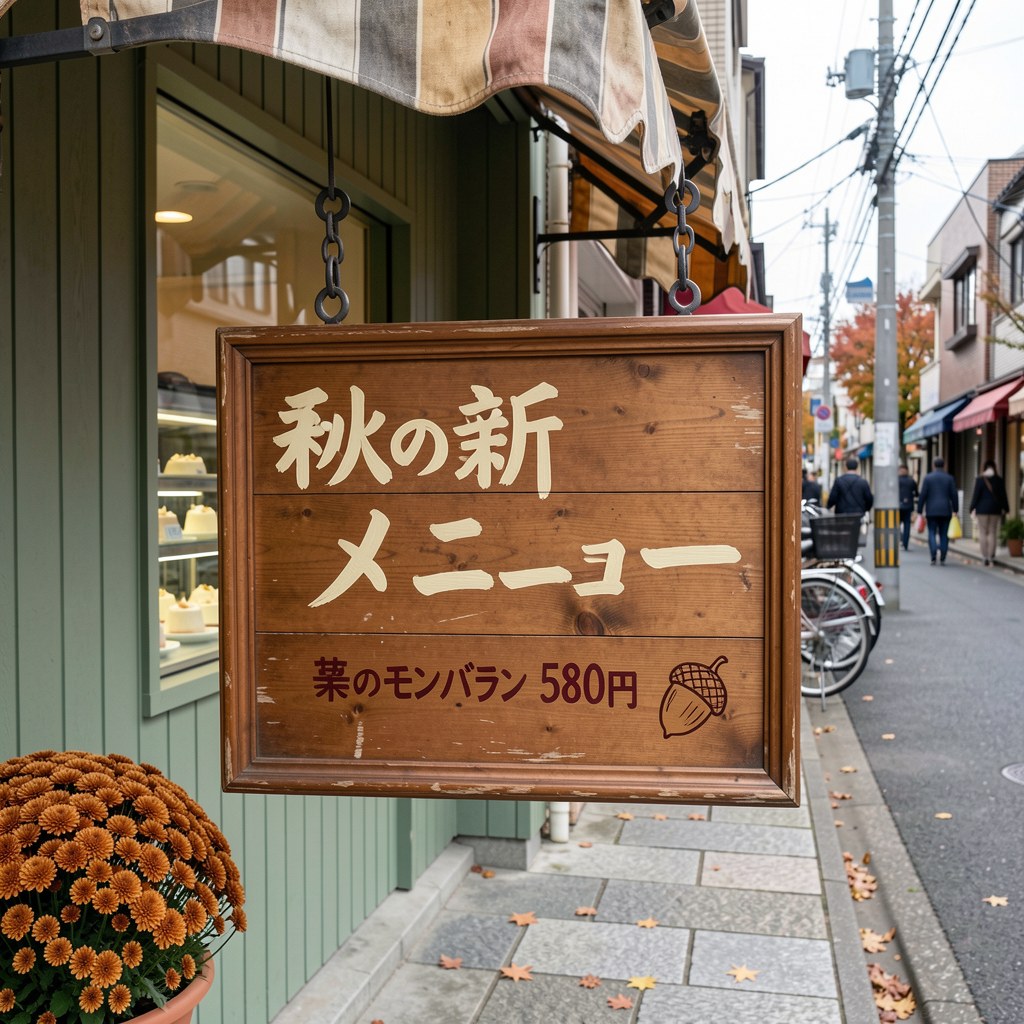
ここまでの看板の比較は、同じ説明文で seed を変えた3周、主題1つ・各3枚を目で読んだ結果で、採点や文字認識の計測ではない。プロンプトを変えれば結果は変わりうる。配布元もモデルカードの制限事項で、画像内の文字は不正確になったり崩れたりすることがあると書いており、FLUX.3 Image Klein でも文字が崩れる場合はありうる。画質全般の優劣はこの比較の対象に入れていない。
1024×1024の生成時間: 精度 (int8・NVFP4・BF16) とテキストエンコーダの組み合わせ
ここからは、条件を揃えて時間とメモリを数えた実測の段になる。最初は1024×1024で、蒸留版の精度3種 (int8・NVFP4・BF16) とテキストエンコーダ2種を掛け合わせた6つの組み合わせを並べた。条件は16ステップ・euler・cfg 1・プロンプト拡張なし (拡張済みの説明文を固定で与えた) で、値は ComfyUI に送ってから画像を保存するまでの秒数の、4 seed × 3 周の2回目以降の中央値。測定機は RTX 5080 / RTX 5060 Ti (どちらも VRAM 16GB)・Windows 11・メインメモリ96GiB・ComfyUI 0.41.0・PyTorch 2.14.0+cu130・NVIDIA ドライバ 610.88。
| 拡散モデル (蒸留版) | テキストエンコーダ | RTX 5080 | RTX 5060 Ti |
|---|---|---|---|
| int8 | int8 | 4.04秒 | 7.19秒 |
| int8 | bf16 | 4.21秒 | 7.51秒 |
| nvfp4 | int8 | 4.76秒 | 9.12秒 |
| nvfp4 | bf16 | 4.99秒 | 9.39秒 |
| bf16 | int8 | 8.47秒 | 17.69秒 |
| bf16 | bf16 | 9.20秒 | 18.50秒 |
どちらの GPU でも、6つの組み合わせの中でいちばん短かったのは蒸留版 int8 (flux3-image-klein-int8-convrot) とテキストエンコーダ int8 の組み合わせで、1024×1024 の2枚目以降の1枚あたりは RTX 5080 で4.04秒、RTX 5060 Ti で7.19秒だった。
nvfp4 の蒸留版は int8 より遅かった。テキストエンコーダ int8 どうしで比べると、RTX 5080 は4.76秒対4.04秒、RTX 5060 Ti は9.12秒対7.19秒。NVFP4 は Blackwell 世代向けの形式で、測った2枚はどちらも Blackwell 世代にあたる。
bf16 の蒸留版 (配布元の表記で11.1 GB) はテキストエンコーダ int8 と組んで RTX 5080 で8.47秒、RTX 5060 Ti で17.69秒かかり、int8 の約2.1倍・約2.5倍の時間になった。原因は切り分けていない。重みの読み出し量や演算の精度の違いのほか、テキストエンコーダ等と合わせて VRAM 16GB に収まらない分の出し入れも考えられる。
テキストエンコーダを bf16 に替えたときの差は小さく、蒸留版 int8 では RTX 5080 が4.04秒から4.21秒、RTX 5060 Ti が7.19秒から7.51秒に伸びた程度だった。この程度の差は、起動ごとの揺れの範囲に入りうる (後のテンプレートの節で触れる)。
ComfyUI を起動して最初の1枚 (読み込み込み) は、蒸留版 int8 + テキストエンコーダ int8 で RTX 5080 が7.1秒、RTX 5060 Ti が10.0秒。プロンプト拡張込みでは13.6秒・19.5秒だった。これは組み合わせごとに ComfyUI を起動し直した直後の1回の値で、中央値ではない。
配布元の発表 (2026年10月15日) には、INT8 版は ComfyUI か Diffusers で VRAM 8GB の GeForce RTX でも動き、蒸留版の INT8 で 1MP の画像が RTX 5090 で約4秒、ComfyUI の RTX 4070 で9秒未満とある。RTX 5090 と RTX 4070 はこの記事では測っておらず、GPU が違うので上の表の値とは比べられない。
同じ VRAM 16GB で、少ないステップで出す別の画像モデルの時間を見たい場合は、Qwen-Image-2.1-TurboをVRAM 16GBで動かすの実測が並べて読める。
4Kと4096×4096: VRAM 16GBを超えた分はどこへ行くか
解像度を上げると、画像を作る時間だけでなく、画像に戻す VAE の段とメインメモリの確保量も伸びた。RTX 5080 で、蒸留版 int8・テキストエンコーダ int8・16ステップ・拡張なしのまま解像度だけを変えている。1024×1024 は 4 seed × 3 周、ほかは seed 1 つで4回 (1回目は読み込み込み) の2回目以降の中央値。「うち VAE」は画像に戻す段 (VAEDecode) の所要で、メインメモリは ComfyUI のプロセスの確保量 (commit) の最大を記録した。
| 解像度 | 1枚 | うちサンプラー | うち VAE | メインメモリ (commit 最大) |
|---|---|---|---|---|
| 1024×1024 | 4.0秒 | 2.9秒 | 0.3秒 | 17.1GiB |
| 2048×2048 | 16.6秒 | 13.7秒 | 1.2秒 | 19.3GiB |
| 3840×2160 | 53.8秒 | 36.7秒 | 15.4秒 | 29.7GiB |
| 4096×4096 | 182.1秒 | 116.3秒 | 63.3秒 | 54.5GiB |
1枚あたりは 2048×2048 で16.6秒、4K にあたる 3840×2160 で53.8秒と1分弱、4096×4096 では182.1秒と約3分かかった。4096×4096 では、メインメモリの確保量 (commit) が最大54.5GiBまで増えている。commit は物理メモリとページファイルで裏付けられた確保済みの量で、物理メモリを実際に使った量ではない。ComfyUI のプロセスの作業セット (物理メモリに載っていた分) の最大は、2048×2048 で3.0GiB、3840×2160 で13.2GiB、4096×4096 で38.0GiBだった。確保量 (commit) と作業セットのどちらの値からも、必要なメインメモリの容量は決められない。3840×2160 でも、PyTorch が確保した GPU メモリの最大は24,802MiBで VRAM 16GB を超えており (2048×2048 は12,570MiB)、4096×4096 と同じく VRAM の外 (共有 GPU メモリ) も使ったとみている。3840×2160 の共有 GPU メモリは記録していないので、どれだけ出たかは分からない。
測定機のメインメモリは96GiBで、メインメモリが少ない PC で同じ解像度が回るかは測っていない。確保量 (commit) の数字を手元のメモリ容量とどう突き合わせて読むかは、画像・動画生成でシステムRAMは何GB要るかで扱っている。
4096×4096 で VRAM を超えた分は共有 GPU メモリへ
4096×4096 では、PyTorch が確保した GPU メモリの最大が50,050MiBと、VRAM 16GB を大きく超えた。それでも止まらずに生成できた理由を見るため、RTX 5060 Ti で同じ設定を1回回し、Windows の性能カウンタ (typeperf の GPU Adapter Memory) で GPU のメモリを1秒ごとに記録した。
| 項目 | RTX 5080 | RTX 5060 Ti |
|---|---|---|
| 1枚 | 182.1秒 | 615.2秒 |
| うちサンプラー | 116.3秒 | 268.8秒 |
| サンプラーより後 (VAE と保存) | 65.8秒 | 346.4秒 |
| PyTorch が確保した GPU メモリの最大 | 50,050MiB | 50,050MiB |
| サンプラーの間の専用 / 共有 GPU メモリ | 記録なし | 14,909MiB / 270MiB |
| サンプラーより後の専用 / 共有 GPU メモリ (記録できた範囲の最大) | 記録なし | 15,641MiB / 34,977MiB |
| メインメモリ (commit 最大) | 54.5GiB | 54.3GiB |
| 接続 | PCIe 5.0 x16 | OCuLink (PCIe 4.0 x4) |
RTX 5080 の列は seed 1 つで4回の2回目以降の中央値、RTX 5060 Ti の列は1回の値。共有 GPU メモリは RTX 5060 Ti でだけ記録していて、RTX 5080 では記録していない (PyTorch の確保量の最大は2枚で同じ値だった)。
画像を作るサンプラーの間は、1秒ごとの記録では、専用 GPU メモリ (VRAM) が14,909MiB・共有 GPU メモリが270MiBとほぼ一定で、VRAM の中で回っていた。サンプラーが終わって画像に戻す VAE の段に入ると、共有 GPU メモリが34,977MiBまで伸びた。記録は生成が始まる約25秒前から1秒ごとに取り始め、生成が始まってから約6分40秒の時点で終わった。生成の最後の約3分40秒は記録できていない。34,977MiB は記録できた範囲の最大で、生成全体の最大は分からない。VRAM を超えた分は、RTX 5060 Ti の記録では、ドライバがメインメモリを共有 GPU メモリとして貸した分にあたる。
これは NVIDIA のドライバの動作によるものだ。NVIDIA のサポート記事によれば、Windows 用ドライバは 536.40 から、GPU のメモリを使い切ったときにアプリが共有メモリ (メインメモリ) を使えるようにしている。546.01 以降では、NVIDIA コントロールパネルの『3D 設定の管理』のプログラム設定で ComfyUI を動かす python.exe を追加し、『CUDA - Sysmem Fallback Policy』を『Prefer No Sysmem Fallback』にするとこの動作を止められる。ただし止めると、GPU のメモリより多くを要する設定ではアプリが落ちることがある、とも書かれている。止めた設定はこの記事では試していない。
VAE の段は、4096×4096 で RTX 5080 が約63秒 (3回の中央値)、RTX 5060 Ti が約341秒 (1回) だった。RTX 5080 では 2048×2048 で約1.2秒、3840×2160 で約15.4秒で、4096×4096 で大きく伸びている。RTX 5060 Ti は外付けの OCuLink で PCIe 4.0 x4 につながっていて、RTX 5080 は PCIe 5.0 x16。共有 GPU メモリとのやり取りが細い接続を通るせいだと推定しているが、切り分けてはいない。
画像編集: 参照画像の枚数と所要時間
編集では、参照画像を増やすほど1枚の時間が伸び、配布元の上限の10枚でも VRAM 16GB の板で最後まで生成できた。蒸留版の編集テンプレート (image_flux3_klein_distilled_image_edit) で、蒸留版 int8・テキストエンコーダ int8・16ステップ・拡張なし。参照画像にはこの記事で出した 1024×1024 の画像を使い、値は RTX 5080 で seed 1 つ・4回の2回目以降の中央値。nvidia-smi のピークは GPU 全体の値で、画面出力の分を含む。
| 参照画像 | 1枚 | うちサンプラー | nvidia-smi のピーク |
|---|---|---|---|
| 1枚 | 6.2秒 | 5.4秒 | 13,733MiB |
| 3枚 | 14.9秒 | 13.8秒 | 13,701MiB |
| 10枚 | 71.4秒 | 70.3秒 | 15,305MiB |
参照画像を1枚・3枚・10枚と増やすと、1枚あたりは RTX 5080 で6.2秒・14.9秒・71.4秒になった。伸びた時間のほとんどはサンプラーの段に出ている。ピークの値は「それだけ要る量」としては読めない (理由は検証環境の節に書いた)。nvidia-smi のピークは専用メモリ側の値で、共有 GPU メモリは編集では記録していないので、10枚のときに VRAM に収まったか共有 GPU メモリへ出たかは、この表からは分からない。参照画像を増やしたときに出てくる絵がどう変わるかは見ていない。
テンプレートの既定・base版・VRAM 8GB相当
テンプレートの既定のステップ数は、ComfyUI の版で違う。ComfyUI 0.41.0 に付くテンプレート (comfyui-workflow-templates 0.11.84) は2026年10月16日に取得した配布元のワークフローと同じ値で、蒸留版の文章からの画像生成は15ステップ、base 版の文章からの画像生成は25ステップ・CFG 3.5、蒸留版の編集は16ステップだった。v0.41.2 に付く 0.11.86 では、蒸留版の文章からの画像生成が16ステップ、base 版の文章からの画像生成が50ステップ・CFG 3.5 になり、どちらも配布元の既定と同じ値になった。下の表は1024×1024・テキストエンコーダ int8・拡張なしで、蒸留版の2行 (16ステップと15ステップ) は 4 seed × 3 周、base 版と模擬の行は seed 1 つで4回の2回目以降の中央値。
| 設定 | GPU | 1枚 | nvidia-smi のピーク |
|---|---|---|---|
| 蒸留版 int8・16ステップ (配布元の既定・0.41.2 のテンプレート) | RTX 5080 | 4.04秒 | — |
| 蒸留版 int8・15ステップ (0.41.0 のテンプレート) | RTX 5080 | 3.53秒 | — |
| base 版 int8・50ステップ・CFG 3.5 (配布元の既定) | RTX 5080 | 15.79秒 | — |
蒸留版 int8・16ステップ・--reserve-vram 8 (8GB 相当の模擬) |
RTX 5060 Ti | — (模擬のため載せない) | 8,160MiB |
0.41.0 のテンプレートの15ステップでは、RTX 5080 で3.53秒だった。16ステップとの差 (0.51秒) は、サンプラーの1ステップ分 (約0.18秒) より大きく、起動ごとの揺れも含む。0.2秒程度の差は、この揺れの範囲に入りうる。15と16のどちらで出した絵が良いかは比べていない。base 版 int8 を配布元の既定の50ステップ・CFG 3.5 で回すと、RTX 5080 で15.79秒だった。base 版を 0.41.0 のテンプレートの値 (25ステップ) で回した時間は測っていない。
VRAM 8GB 相当の行は模擬の結果。RTX 5060 Ti で ComfyUI に --reserve-vram 8 (OS やほかのソフトのために VRAM を約8GB 空けておく指定) を付け、ComfyUI が使う VRAM を約8GB に抑えて蒸留版 int8 を回すと、GPU 全体のピークは8,160MiBで、最後まで生成できた。この値は抑えた上限の近くに張り付いた値で、必要な量ではない。VRAM 16GB の板で ComfyUI が使う量を抑えただけで、VRAM 8GB の GPU で測ったわけではない。この速さは 8GB の GPU の速さを表さないので、秒数は載せていない。
--reserve-vram の効き方や、ComfyUI の dynamic VRAM がどう VRAM を使うかは、ComfyUIの起動オプション実測ガイドで起動オプションごとに測っている。
検証環境と測り方
| 項目 | 内容 |
|---|---|
| GPU | RTX 5080 (VRAM 16GB、PCIe 5.0 x16) / RTX 5060 Ti (VRAM 16GB、OCuLink で PCIe 4.0 x4) |
| メインメモリ | 96GiB |
| OS / ドライバ | Windows 11 / NVIDIA 610.88 |
| ComfyUI | 0.41.0 (comfy-aimdo 0.5.6・comfy-kitchen 0.2.37) |
| PyTorch / Python | 2.14.0+cu130 / 3.12.10 |
| モデル | black-forest-labs/flux-3-image-klein-comfy (2026年10月16日に取得) |
| 回し方 | 1つの組み合わせごとに ComfyUI を起動し直し、1枚目 (読み込み込み) と2枚目以降を分けて数えた。GPU は1枚ずつ順に使った |
本記事の実測値は2026年10月16日に、上記の測定機・設定で計測したもの。RTX 5080 は画面出力を兼ね、外付けの RTX 5060 Ti は画面出力をしていない。GPU は1枚ずつ (CUDA_VISIBLE_DEVICES で指定して) 順に使い、2枚を同時には回していない。短いプロンプトは4種類 (人物・商品・風景・日本語の看板) で、seed 12345・222・333・444 を1つずつ割り当て、2周目以降は周ごとに1000ずつ足した。測ったのは ComfyUI 0.41.0 で、同じ日に出た v0.41.2 との差分は Krea のノードの追加と版の指定だけで、FLUX.3 を動かすコードは変わっていない (変わったのはテンプレートの中身で、プロンプト拡張の節に書いた)。
ComfyUI 0.41.0 は起動時に dynamic VRAM を有効にしていた (起動ログに『DynamicVRAM support detected and enabled』と出る)。空いている VRAM をあるだけ使う動きになるため、この記事に載せた nvidia-smi のピークは「それだけ要る量」を表さない。ピークは GPU 全体の値で、RTX 5080 では画面出力の分も含む。また専用メモリ (VRAM) 側の値で、共有 GPU メモリに出た分は含まない。
この記事で「PyTorch が確保した GPU メモリの最大」と書いた値は torch.cuda.max_memory_reserved() の値で、PyTorch が使い回すために取っておく分もまとめて GPU から確保した量を指す。テンソルが実際に使った量の最大 (max_memory_allocated()) はこれより小さく、3840×2160 で17,398MiB、4096×4096 で35,156MiBだった。どちらの指標で見ても、この2つの解像度は VRAM 16GB を超えている。
この記事で測っていないものは、画質全般、Linux での動作、ほかの GPU、VRAM 8GB の実機、メインメモリの少ない PC、Diffusers での動作、ボックスでレイアウトを指定する使い方 (bounding box)、NVIDIA のフォールバックを止めた設定。これらについては結果を書いていない。
測定機の構成の詳細は検証環境のページにあり、ほかのモデルや GPU での数字はAIハードウェア実測データベースから引ける。
まとめ
VRAM 16GB の GPU で FLUX.3 Image Klein を ComfyUI で試すなら、メインメモリ96GiB の測定機では、速さを優先して蒸留版 int8 とテキストエンコーダ int8 から始めると時間の見当がつく。画質は比べていないので、ほかの精度を選ぶ理由が画質にあるかは別に確かめる。配布元どおりプロンプト拡張を通す場合は、1024×1024 の1枚が RTX 5080 で約8秒、RTX 5060 Ti で約9秒長くなり、拡張の文章を書く部分の秒数を足すだけでは足りない。
FLUX.2 Klein 9B から乗り換えるかは、拡張の扱いで見え方が変わる。拡張なしの同じ説明文なら FLUX.3 Image Klein の1枚が短く、拡張込みでは拡張なしの FLUX.2 Klein 9B より長い。日本語の看板は試した3枚で FLUX.3 Image Klein だけが正しく描いたが、主題1つの観察にとどまる。
4K (3840×2160) は RTX 5080 で1分弱で回ったが、PyTorch の確保量は VRAM 16GB を超えていて、共有 GPU メモリも使ったとみている (共有 GPU メモリは記録していない)。4096×4096 は両方の GPU で最後まで回り、共有 GPU メモリを記録した RTX 5060 Ti では、VRAM を超えた分がドライバ経由でメインメモリに出ていた (RTX 5080 では記録していない)。この解像度の RTX 5060 Ti の値、とくに画像に戻す段には、OCuLink 接続の影響が含まれうる。参照画像10枚の編集は RTX 5080 で最後まで回った。メインメモリの少ない PC と VRAM 8GB の実機は測っておらず、そこは別の確かめ方が要る。商用で使うなら、先にライセンスの条件を確かめる。
同じ説明文・同じ seed で MOSS-Image と並べた1枚あたりの時間と日本語の看板は、MOSS-ImageをVRAM 16GBで動かす で比べている。
参考資料
- FLUX 3 Image Klein for ComfyUI (Black Forest Labs, Hugging Face)
- FLUX 3 Image Klein (Black Forest Labs ブログ)
- FLUX Kommunity License
- ComfyUI v0.41.0 リリース
- System Memory Fallback for Stable Diffusion (NVIDIA)
- FLUX 3 Klein のテンプレートの更新 (Comfy-Org/workflow_templates #1346)
- FLUX 3 Klein の新しいファイル名への更新 (Comfy-Org/workflow_templates #1353)