この記事の要点
生成AIを自分の PC で動かすなら、GPU (グラフィックボード。グラボとも呼ぶ) を VRAM (GPU に載っているメモリ) の容量で先に決める。GPU 1枚の VRAM はあとから増やせないからだ。電源 (PC に電気を送る部品) は、その GPU の推奨電源容量以上を選ぶ (NVIDIA の公表値は GPU ごとに 550W〜1000W)。
メインメモリ (パソコン本体のメモリ。VRAM とは別) は、画像生成が中心なら 32GB、動画生成まで使うなら 64GB から考える。測定機 (メインメモリ96GB の PC) で使った量から出した目安で、長い動画のアップスケール (動画を高解像度にする処理) では 64GB を超えた測定が1回あった。
SSD (データを保存する場所) は、モデル (AI の本体のファイル) を入れ替えながら使うなら 1TB、モデルも作った画像・動画も消さずにためるなら 2TB から選ぶ。測定機では、画像・動画のモデルの本体ファイルが1本 16GB 前後、測った動画のモデル1つが付属のファイル込みで約42.5GB、置いていた大きめの LLM (文章を作る AI) 6本が1本 18〜24GB 級だった。
GPU から決めるなら GPU の選定ツール、完成品 (BTO) から探すなら BTO の選定ツールで候補を絞れる。
用途別に決める部品の目安
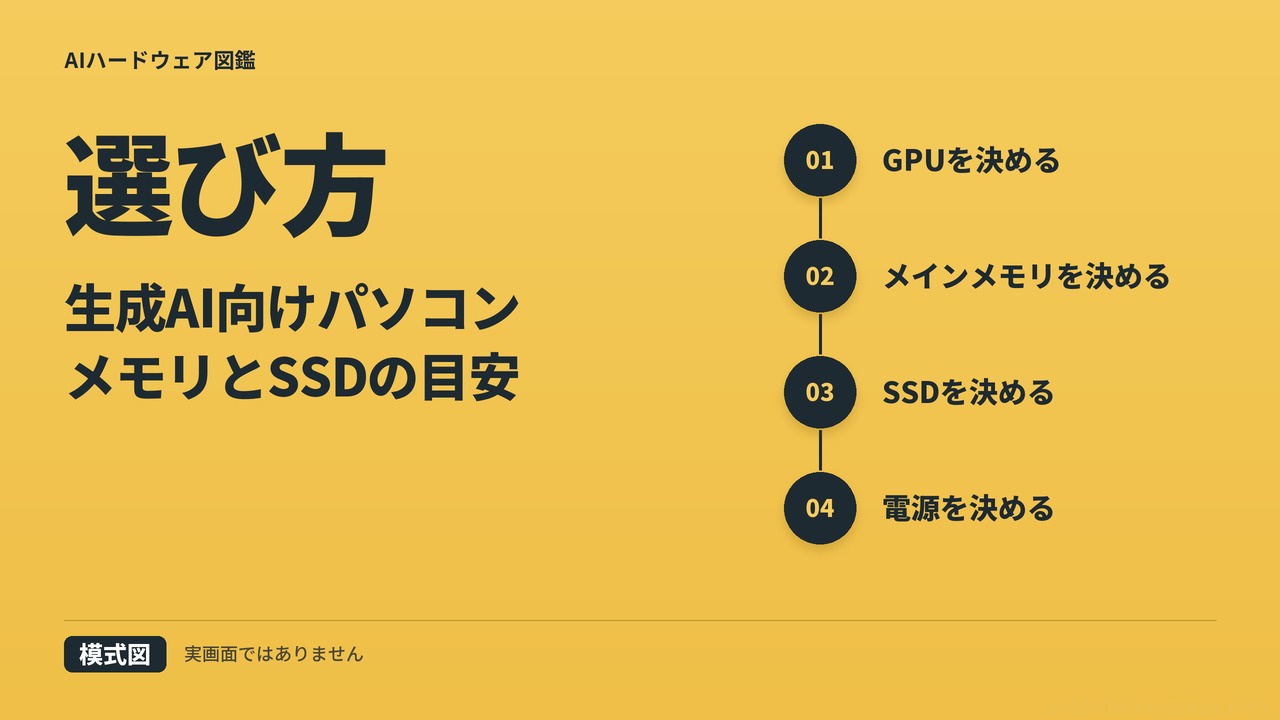
決める順番は、作りたいもの (画像・動画・文章) → GPU → メインメモリ → SSD → 電源で、最後に冷却とケースを確かめる。
この記事は、画像・動画・文章の生成AIを自分の PC で動かす (ローカル) ための部品の選び方を扱う。AI 処理用の専用チップ (NPU) を載せた「AIパソコン」や、ブラウザで使うサービスだけの使い方は扱わない。用途ごとに VRAM を何GB にするかは生成AI用グラボの選び方にまとめた。
| 用途 | メインメモリ | SSD に置くモデルの大きさ |
|---|---|---|
| 画像生成 | 32GB から | 本体1本 16GB 前後 |
| 動画生成 | 64GB から | 1式で約42.5GB (測った1つ) |
| 文章を作る AI (LLM)、VRAM 16GB に収まる大きさ | 容量の目安ではない。測った2本で Ollama が使ったのは約1〜1.3GiB (確保量は約11.6GiB) | モデル1本の大きさを足す |
| 文章を作る AI (LLM)、VRAM 16GB を少し超える大きさ | 容量の目安ではない。測った5本で Ollama が使ったのは約5〜11GiB (確保量は約20〜25GiB) | 置いていた大きめの6本は1本 18〜24GB 級 |
画像生成と動画生成の行のメインメモリは、測定機 (メインメモリ96GB の PC) で使った量の最大から出した、まず選ぶ容量の目安だ。VRAM 16GB の GPU で、画像1枚を作ったときは 20GB 台を使った。短い動画を1本作ったときは、ソフトのバージョンなどが違う2回の測定で、最大 40GB 台と 10GB 台に分かれた (差の原因は切り分けていない)。32GB と 64GB の分け方は、画像と動画のモデルを1つずつ測った値からの目安だ。
LLM の行は、Ollama (LLM を手元の PC で動かすソフト) が使ったメモリを測った値で、選ぶ容量の目安ではない (GiB は GB に近い単位)。「使ったのは」は、メインメモリに実際に置かれていた量 (物理メモリに載っていた量) の最大だ。括弧内の確保量は Ollama が確保した量の最大で、メインメモリに置かれていない分も含む。どちらも Ollama だけの量で、OS やほかのアプリの分は含まない。32GB・64GB の PC では試していないので、LLM のために何GB を選べば足りるかは、この記事では決めていない。7本の値は「LLMを動かしたときに使ったメモリ」の表にある。
SSD の列は、画像の行はモデルの本体ファイル1本、動画の行は付属のファイルを含めた1式の大きさだ。測定機に残っていた動画 (約1800本) は1本平均 90.1 MB だった。測ったモデルの名前や条件は、後半の各表と最後の節にまとめた。
動画の 64GB は、ソフトのバージョンが違う2回の測定のうち、大きいほうに合わせた目安だ。長い動画のアップスケールまでするなら、96GB など 64GB より大きい容量も候補に入れる (アップスケールを試した2通りのうち、長いほうの動画では 64GB を超え、測定機の 96GB には収まった)。32GB でも 64GB でも、Windows のページファイル (メモリが足りないときに SSD などを代わりに使う仕組み) は無効にしたり小さくしたりしない (初期設定のままでよい)。初期設定ではページファイルが必要に応じて大きくなる。ただ、置き先のドライブ (初期設定では Windows を入れたドライブ) に空きが無いと大きくなれず、ソフトがメモリを確保できないことがある。空きがあっても、大きくなるのが間に合わずに確保に失敗することもある。そのドライブの空きは残しておく。初期設定のままでもメモリ不足のエラーが出るときは、ページファイルの大きさと置き先の設定を見直す。
SSD は、入れたいモデルの大きさを足して決める。たとえば、画像・動画のモデルの本体ファイル3本 (約48GB)、動画のモデル1式 (約42.5GB)、VRAM 16GB に入りきらない大きさの LLM 3本 (54〜72GB 級) なら、合わせて約145〜163GB になる。ここにソフト本体・OS (Windows など)・作った画像や動画と付属のファイルが加わっても、モデルを入れ替えながら使うなら 1TB に収まる見込みだ。
一方、LLM 30個と動画約1800本のほか、作業用のファイルや画像・動画のモデルも消さずにためた測定機では、データ用ドライブ (保存用のドライブ) の AI 関連だけで 1TB を超え、AI と無関係のファイルも入った 2TB のドライブの空きは 149.5 GB まで減った。同じくらいためるなら 2TB から選ぶ。
電源は、選んだ GPU の推奨電源容量 (NVIDIA が各 GPU に示す電源の容量の目安) 以上のものを選ぶ。NVIDIA が公表している値は、RTX 5060 が 550W、RTX 5060 Ti が 600W、RTX 5070 が 650W、RTX 5070 Ti が 750W、RTX 5080 が 850W、RTX 5090 が 1000W だ。ほかの GPU や、NVIDIA 以外の会社が作るカード (ASUS・MSI など) は、買うカードの商品ページで推奨電源容量を見る。BTO では、注文する構成 (GPU を変えて注文するときは、変えたあとの構成) の仕様欄で、電源のワット数 (W) がこの値以上かを見る。
画像生成で使うモデルを決めかねているなら、画像生成のハード要件ガイドがモデル別の必要 VRAM と1枚あたりの所要時間を実測つきで挙げている。動画生成では、VRAM・メインメモリ・GPU をどう見るかを動画生成のハード要件ガイドが実測を添えて説明している。
BTOか自作か
BTO (注文に合わせて組み立てて売られる完成品) でも自作でも、探す条件の中心は同じ4つで、VRAM の容量、メインメモリ (32GB か 64GB から)、SSD の容量、電源の W 数だ。主な違いは、組み立てと部品どうしの相性の確認を誰が引き受けるかにある。自作では、ケースに GPU が収まるかと、補助電源のケーブル (GPU に追加で電気を送るケーブル) が足りるかも自分で確かめる。
- 部品の相性や組み立てに不安があるなら、BTO から始める。
- 困ったときの問い合わせ先を1つにしたいなら、BTO を選ぶ。
- 部品を1つずつ自分で選びたい、手持ちの部品を使い回したいなら、自作を選ぶ。
完成品は、BTO の選定ツールで VRAM とメインメモリ 32GB (動画まで使うなら 64GB) の条件から絞れ、SSD の容量と電源のワット数 (W) は、候補の仕様欄 (GPU を変えて注文するときは変更後の構成) で確かめる。VRAM 16GB の GPU を使った3つの価格帯の構成例と速さはVRAM 16GBの3つの価格帯の比較に、予算帯ごとの構成はAI用PC 購入ガイドにある。
CPU やマザーボードまで含めた部品構成の例はAI用PCの最低スペックガイドにあり、自作ならこれをたたき台にできる。
ここまでで部品の目安は決められる。ここから先は、部品ごとの根拠を確かめたい人向けの実測で、測定の条件は最後の節にまとめた。
GPUは先にVRAMで決める
GPU は、載せたいモデルが VRAM に入るかを先に決める。同じ容量なら、速さも見て選ぶ。どの用途に何GB 要るかは生成AI用グラボの選び方にまとめた。
VRAM に全部載せられるモデルの大きさは VRAM の容量で決まるが、生成の速さは同じ容量でも GPU ごとに違う。SDXL (画像生成のモデルの1つ) の生成時間の表は、その違いを見るためのものだ。
| GPU | VRAM | 1枚の生成時間 | VRAM増分 (待機時から) | GPU温度 |
|---|---|---|---|---|
| RTX 5080 | 16GB GDDR7 | 5.8秒 | 約7.7 GiB | 65°C |
| RTX 4070 SUPER | 12GB GDDR6X | 8.4秒 | 約7.7 GiB | 68°C |
| RTX 5060 Ti | 16GB GDDR7 | 11.6秒 | 約7.7 GiB | 58°C |
上の表の条件で測った参考の比較では、同じ 16GB の2枚でも、SDXL の1枚の時間は約2倍違い、12GB の RTX 4070 SUPER は 16GB の RTX 5060 Ti より速かった。RTX 5080 は本体のスロット、RTX 5060 Ti と RTX 4070 SUPER は外付けの OCuLink 接続 (PC の外に GPU を置く接続) で測っていて、差の要因 (CUDA コア数・世代・クロック・メモリ帯域・接続の違い) は切り分けていない。SDXL の値はComfyUI推奨スペック実測ガイドの測定から取った。
NVIDIA の公称仕様 (2026年10月19日に確認) では、VRAM は RTX 5060 が 8GB、RTX 5070 が 12GB、RTX 5060 Ti 16GB・RTX 5070 Ti・RTX 5080 が 16GB、RTX 5090 が 32GB で、どれも GDDR7 だ。RTX 5060 Ti には 16GB と 8GB の2種類があるので、16GB を選ぶなら製品の表記で 16GB を確かめる。
16GB の3枚の違いはVRAM 16GB の GPU を AI の用途別に比べた記事で詳しく比べていて、VRAM と電源から候補を絞り込むならGPU の選定ツールが使える。
メインメモリはLLMと画像・動画生成で見方が違う
メインメモリの数字は2種類ある。1つは、動かしたソフト (ComfyUI・Ollama) が物理メモリの上で使っていた量の最大で、画像・動画生成と LLM の両方で測った。もう1つは LLM だけにある、Ollama の報告から出した VRAM からあふれた分の概算で、こちらは使った量を測った値ではない。
LLM を Ollama (LLM を手元の PC で動かすソフト) で動かすときは、メインメモリは VRAM に載りきらない分の置き場になる。ただ、測った使用量にはその分のほかも入り、VRAM に全部載った LLM でも約1〜1.3GiB あった。画像・動画生成を ComfyUI (画像や動画を作るソフト) で動かすときの値は、ソフトが物理メモリの上で使っていた量の最大で、VRAM からあふれた分だけの値ではない。ComfyUI でメモリが増える要因は分けて測っておらず、増え方は、VRAM からあふれた分がメインメモリに来ているという1つの説明ではまとまらなかった。容量や規格の基本はAI用PCのメモリの基礎の解説で説明している。
この節の表のメモリの値は GiB で書く。1GiB は約1.07GB だ。メインメモリの商品容量の 32GB は実際には 32GiB で、GPU の VRAM の 16GB も同じ数え方なので、表の GiB の値とそのまま比べられる。16.3 GiB のモデルは、16GB の VRAM に収まらない。画面の表示などにも VRAM の一部が使われるので、16GiB より少し小さいモデルでも全部は載らないことがある。
Krea 2 (Turbo のモデル)・MiniMax H3 は測ったモデルの名前で、32GB と 64GB の分け方は、この2つのモデルで測った値からの目安だ。FP8・Q4_K_M はモデルを小さく持つための形式、LoRA は追加で読み込む小さな重みのファイルだ。細かい仕組みは読み飛ばしてよいが、変えるとメモリの量や速さも変わる。
画像・動画生成で使ったメモリの最大
画像1枚は 20GiB 台、動画生成 (864x480・56フレーム) は 40GiB 台か 10GiB 台で、64GB を超えたのは 192フレームの動画のアップスケールだけだった。GPU は RTX 5080 16GB で、メモリ使用量の最大は、そのソフトが物理メモリの上で使っていた量の最大だ (OS やほかのアプリの分は含まない)。
| ワークフロー | 条件 | ComfyUI | メモリ使用量の最大 |
|---|---|---|---|
| 画像生成 Krea 2(FP8) | 1枚 | 0.31.1 | 20.5 GiB |
| 画像生成 Krea 2(FP8 + LoRA) | 1枚 | 0.31.1 | 20.98 GiB |
| 動画生成 MiniMax H3(FP8) | 864x480 56フレーム (LoRA あり・なし、4・8ステップの4条件) | 0.31.1 | 44.04〜44.73 GiB |
| 動画生成 MiniMax H3(FP8) | 864x480 56フレーム (同じ4条件を PyTorch 2通りで、計8条件) | 0.37.1 | 13.2〜18.0 GiB |
| 動画のアップスケール (4x-UltraSharp) | 入力 1344x768 16フレーム | 0.31.1 | 6.21 GiB |
| 動画のアップスケール (4x-UltraSharp) | 入力 1344x768 192フレーム | 0.31.1 | 69.17 GiB |
動画生成 (MiniMax H3) は、ComfyUI 0.31.1 では4条件 (LoRA あり・なし、4・8ステップ) で 44.04〜44.73 GiB、0.37.1 では 13.2〜18.0 GiB と分かれた。PyTorch を同じ 2.9.1+cu128 にそろえた回でも 0.37.1 では大きく下がったが、2回は起動環境 (読み込むカスタムノードや GPU メモリの確保方式) も違うので、ComfyUI 本体のバージョンだけの効果とは切り分けていない。動画の目安は、大きいほうの 0.31.1 の値に合わせて 64GB にしている。
アップスケールは、入力 1344x768 のまま 16フレームで 6.21 GiB、192フレームで 69.17 GiB と、フレーム数とともに増えた。アップスケール用のモデルは4件合計 0.2 GB と小さいので、増えた分はモデルの大きさでは説明できない。
表の値は使った量で、必要な搭載量は Windows のページファイルの設定でも変わる。画像1枚でも、物理メモリに載っていない分まで含めてソフトが確保した量 (確保量) は 36.19 GiB で、32GB を上回った。Windows には、PC 全体でソフトが確保できる量の上限 (コミットの上限) がある。上限はおおむねメインメモリとページファイル (メモリが足りないときに SSD などを代わりに使う仕組み) を足した量で決まり、ソフトの確保量もこの上限に数えられる。そのため、ページファイルを無効にしたり小さくしたりしている 32GB の PC では、この画像生成が最後まで動かないことがある。動画1本 (ComfyUI 0.31.1) の確保量は 59.32〜60.37 GiB で、ページファイルを無効にしたり小さくしたりしていると、64GB の PC でも OS などの分を足したときに上限に近づく見込みだ (64GB の PC では試していない)。ワークフローごとの細かな記録は画像・動画生成でシステムメモリが何GB要るかの実測にある。
LLMを動かしたときに使ったメモリ
RTX 5080 16GB 1枚 (メインメモリ96GB の測定機) で LLM 7本を3回ずつ動かし、Ollama が使ったメモリの最大を測った (2026年10月23日、Ollama 0.40.9、コンテキスト長 8192。コンテキスト長は LLM が一度に扱える文章の長さ)。メモリ使用量と確保量は、画像・動画生成の表と同じ道具・同じ量で測ったが、こちらは読み込みを含む1回目も入れた3回の最大だ。VRAM に全部載った2本はメモリ使用量が約1〜1.3GiB、載りきらなかった5本は約5〜11GiB だった。細かい条件は「測定の条件と注意点」にまとめた。
| モデル | VRAM 16GB に | メモリ使用量の最大 | 確保量の最大 |
|---|---|---|---|
| qwen3:14b | 全部載った | 1.27 GiB | 11.55 GiB |
| phi4:14b | 全部載った | 1.07 GiB | 11.55 GiB |
| qwen3.5:27b | 載りきらなかった | 4.99 GiB | 19.55 GiB |
| qwen3-coder:30b | 載りきらなかった | 5.58 GiB | 19.61 GiB |
| gemma4:31b | 載りきらなかった | 10.38 GiB | 25.19 GiB |
| qwen3:32b | 載りきらなかった | 8.49 GiB | 22.53 GiB |
| qwen3.6:35b-a3b | 載りきらなかった | 10.66 GiB | 24.96 GiB |
確保量は、全部載った2本でも 11.55 GiB、載りきらなかった5本では 19.55〜25.19 GiB で、メモリ使用量よりかなり大きい。確保量がメモリ使用量よりずっと大きい理由は切り分けておらず、Ollama のバージョンが違えば変わりうる。
コンテキスト長を 8192 から 32768 に延ばすと、gemma4:31b では、メモリ使用量が 10.38 GiB から 12.64 GiB に、確保量が 25.19 GiB から 27.34 GiB に増えた。VRAM に載りきらない LLM では、もっと大きいモデルやもっと長いコンテキスト長で使う量が増えるとみられるが、コンテキスト長を変えて測ったのはこの1本だけだ。
LLMがVRAMからあふれたとき
Ollama の FAQ は、モデルが GPU とシステムメモリの両方に部分的に載る状態があると説明している (ollama ps の Processor 欄で確かめられる。2026年10月19日に確認)。VRAM に載りきらないモデルがこの状態になったことは、「16GB 1枚と2枚構成の LLM の比較」の「VRAM に載った割合」で確かめた。あふれた分をメインメモリに置いて動かすことを、オフロードと呼ぶ。
LLM は、文章をトークン (LLM が文章を区切って扱う単位) ごとに作っていく。表の「作り」の MoE は、トークンを1つ作るごとにモデルの一部だけを計算に使う作りで、dense は毎回モデル全体を使う作りだ。27B などの B はモデルの大きさの単位で、十億個のパラメータを表す。測ったときのコンテキスト長は 8192 だった。コンテキスト長は、LLM が一度に扱える文章の長さ (入力と出力を合わせた分) の上限だ。2枚構成の列は、全部を VRAM に載せたときとの対照で、2枚目を買い足す提案ではない。
| モデル | 作り | Ollama が報告した大きさ | 16GB 1枚で VRAM に載った割合 | 16GB 1枚の速さ | 2枚構成で VRAM に載った割合 | 2枚構成の速さ |
|---|---|---|---|---|---|---|
| qwen3.5:27b | dense | 16.3 GiB | 78% | 毎秒12.8トークン | 100% | 毎秒30.1トークン |
| qwen3-coder:30b | MoE (計算に使う部分 3.3B) | 18.4 GiB | 74% | 毎秒72.5トークン | 100% | 毎秒157.8トークン |
| gemma4:31b | dense | 20.0 GiB | 61% | 毎秒7.5トークン | 100% | 毎秒25.7トークン |
| qwen3:32b | dense | 21.4 GiB | 64% | 毎秒7.4トークン | 100% | 毎秒25.9トークン |
| qwen3.6:35b-a3b | MoE (計算に使う部分 3B) | 21.9 GiB | 58% | 毎秒55.5トークン | 100% | 毎秒129.3トークン |
全体が 16.3〜21.9 GiB のモデルは、16GB 1枚では、Ollama の報告で全体の 22〜42% が VRAM に載らずメインメモリ側に置かれ、それでも動いた。GiB に直すと約3.6〜9.2 GiB (qwen3.5:27b で約3.6 GiB、qwen3.6:35b-a3b で約9.2 GiB) になる。これは Ollama が報告した大きさと VRAM に載った割合からの概算で、メインメモリの使用量を測った値ではない。この概算のうち MoE の2本 (qwen3-coder:30b と qwen3.6:35b-a3b) は、前のモデルが VRAM に残っていた可能性のある回の値で、あふれ分は多めに出ている可能性がある。メインメモリで実際に使った量は「LLM を動かしたときに使ったメモリ」の表で測っていて、どのモデルもこの概算より大きい。あふれた分のほかの分も入るからで (VRAM に全部載った2本でも約1〜1.3GiB)、測った Ollama のバージョンと一部のモデルの中身も違う。
16GB 1枚で載りきらない大きさを使ったとき、MoE の2本は毎秒 55.5 と 72.5 トークンで、dense の3本 (毎秒 7.4〜12.8 トークン) より速かった。どのモデルも、2枚構成よりは遅かった (5本・1条件の結果)。
大きさは、コンテキスト長 8192・Q4_K_M のときに Ollama が報告した合計だ。Ollama の FAQ は、並列で処理する数とコンテキスト長に応じて必要なメモリが増えると説明していて、コンテキスト長を長くすると大きさも増えうる。
1枚と2枚では容量以外 (演算資源・帯域・GPU 間の分割) も変わるので、速さの差は容量だけの効果ではない。モデルごとのあふれ方の詳細はVRAM 32GB で何が変わるかの実測、オフロードの仕組みはVRAMに収まらない大型LLMをRAMオフロードで動かすで扱っている。
SSDはモデルの本数と1本の大きさ、生成物で決める
SSD の容量は、入れたいモデルの大きさを足して決める。動画を作るなら、生成物の置き場も足す。
1本の大きさは、画像・動画の本体ファイル (diffusion_models) が平均 16.0 GB、動画モデルの例の MiniMax H3 が1式で約42.5GB、LLM の 26B〜35B 級が1本 18〜24GB 級で、動画の生成物は1件平均 90.1 MB だった。ここでの「1本」は、画像・動画ではフォルダの中のファイル1つ、LLM では Ollama のタグ1つのことで、動画モデルは何本かのファイルを1式で数える。AI と無関係のファイルも同居した 2TB のドライブでは、モデルや生成物、GGUF などの作業ファイルも消さずに残してきたところ、空きが 149.5 GB まで減っていた。測定機では、フォルダごとの差は本数より1本の大きさに出ていた。
画像・動画生成のモデル
ComfyUI がモデルを置く models フォルダでは、画像・動画の本体 (diffusion_models) がいちばん大きく、次に一体型のモデルとテキストエンコーダが続いた。実消費は、同じファイルを2回数えずに足したファイルサイズの合計で、ドライブが確保した量とは一致しない。
| フォルダ | 実消費 | ファイル数 | 1本あたり |
|---|---|---|---|
| diffusion_models(画像・動画の本体) | 191.9 GB | 12 件 | 16.0 GB |
| checkpoints(一体型のモデル) | 113.8 GB | 8 件 | 14.2 GB |
| text_encoders(プロンプトを解釈する側) | 75.6 GB | 13 件 | 5.8 GB |
| clip | 24.8 GB | 5 件 | 5.0 GB |
| unet | 22.6 GB | 3 件 | 7.5 GB |
| vae | 10.5 GB | 9 件 | 1.2 GB |
| loras | 1.1 GB | 3 件 | 0.4 GB |
| upscale_models | 0.2 GB | 4 件 | 0.1 GB |
画像・動画の本体は12件で 191.9 GB だった。VAE は9件で 10.5 GB、LoRA とアップスケール用のモデルは計 1.1 GB と 0.2 GB だった。「1本あたり」はフォルダの本数で割った値で、よくある質問の足し算はこの平均を当てはめた仮の数字だ。見込み量は、入れるモデルのファイルサイズを配布元で確かめて足すほうが近い。
動画モデルは、何本かのファイルを1式で使う。MiniMax H3 では、拡散モデルのほかにテキストエンコーダと映像・音声の VAE が要った。
| 役割 | ファイル | サイズ |
|---|---|---|
| 拡散モデル(推論用・FP8) | minimax_h3_fl2va_pruned_fp8_scaled.safetensors | 20.96GB |
| テキストエンコーダ(NVFP4 AWQ) | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | 15.69GB |
| 映像VAE | minimax_h3_video_vae_fp16.safetensors | 5.21GB |
| 音声VAE | minimax_h3_audio_vae_fp32.safetensors | 0.61GB |
この4ファイルで、合計は約42.5GB になる。同じ配布元には精度の違う別のファイルもあり、選ぶファイルで合計は変わる。ComfyUI 本体や Python の環境、LoRA、生成物の分は含まない。このファイル構成で動かした記録はMiniMax H3をVRAM 16GBで動かすに載せた。
LLM のモデル
表の6本は、SSD に置いていた Ollama の 4bit (Q4_K_M) のタグで (あふれ方と速さを測った5本とは一部が違う)、どれも1本 18〜24GB 級だった。同じモデルでも、8bit のタグは約1.6〜1.8倍、16bit のタグは約3倍の大きさになる (Ollama のライブラリのタグ一覧、2026年10月22日に確認)。論理サイズは、タグごとの、モデルを構成するデータのまとまり (層) の大きさを足した値だ。
| タグ | 論理サイズ |
|---|---|
| qwen3.6:35b-a3b | 23.94 GB |
| qwen3.5:35b-a3b | 23.87 GB |
| qwen3:32b | 20.20 GB |
| gemma4:31b | 19.87 GB |
| qwen3-coder:30b | 18.56 GB |
| gemma4:26b | 17.99 GB |
この論理サイズは SSD に置くファイルの大きさ (GB) で、「16GB 1枚と2枚構成の LLM の比較」の「Ollama が報告した大きさ」(コンテキスト長 8192 で動かしたときの GiB の値) とは別の値だ。SSD の容量を決めるときは、論理サイズを足す。複数のタグが同じ層を共有することがあり、30タグ全体では、論理サイズの合計 343.6 GB に対して実際に置かれていた層は 286.6 GB だった。
生成物
作った動画は1件平均 90.1 MB で、100本ためると約9GB になる。画像の1.6 MB から桁が変わる。
| 種類 | 本数 | 実消費 | 1件あたり |
|---|---|---|---|
| png(画像) | 2840 件 | 4.5 GB | 1.6 MB |
| mp4(動画) | 1809 件 | 163.0 GB | 90.1 MB |
1件の大きさは解像度・長さ・保存形式で変わり、このフォルダには生成物以外のファイルも入っている。
消さずに残した2TBの内訳
LLM と画像・動画生成をどちらも回してきたデータ用ドライブでは、LLM 側の領域がいちばん大きかった。
| 領域 | 実消費 |
|---|---|
| LLM 側のツール・モデル・作業ファイル(Ollama・llama.cpp・GGUF) | 709.9 GB |
| ComfyUI 本体と画像・動画モデル | 448.6 GB |
| ComfyUI が生成物を書き出すフォルダ | 168.4 GB |
LLM 側の値は、ツール、モデル、作業ファイルを分けずに数えた。AI 関連の3領域の合計は 1326.9 GB で、この測定機の残し方では 1TB に収まらなかった。システムドライブ側にも、AI 関連が 269.5 GB あった。
フォルダごとの細かな記録はローカルAIでSSDは何TB要るかの実測に、容量・規格の基本はSSDの基礎知識にある。
電源はGPUの推奨電源容量から決める
電源は、選んだ GPU の推奨電源容量を最小の目安にして選ぶ。自作なら、補助電源のケーブルが足りるかも一緒に見る。
推奨電源容量は、NVIDIA が各 GPU に示す電源の容量だ。RTX 50 シリーズの主な6つの GPU の公称値 (2026年10月19日に確認) は、消費電力の目安が 145W〜575W、推奨電源容量が 550W〜1000W だ。
| GPU | 消費電力の目安 | 推奨電源容量 |
|---|---|---|
| RTX 5060 | 145W | 550W |
| RTX 5060 Ti | 180W | 600W |
| RTX 5070 | 250W | 650W |
| RTX 5070 Ti | 300W | 750W |
| RTX 5080 | 360W | 850W |
| RTX 5090 | 575W | 1000W |
どれも公称値で、RTX 5060 Ti は 16GB と 8GB で同じ値が1つの欄に書かれている。推奨電源容量は NVIDIA が基準にした PC での最小値で、構成によって必要な量は変わる。電源は PCIe CEM 5.1 に準拠したものが推奨されているので、電源の仕様欄で準拠の記載を確かめる。
自作では、容量のほかに補助電源のケーブルが足りるかも見る。NVIDIA の仕様では、PCIe 8ピンのケーブルが RTX 5060 系で1本、RTX 5070 系で2本、RTX 5080 で3本、RTX 5090 で4本要り、どれもカードが指定する対応電力の PCIe Gen 5 ケーブル1本でも代えられる (各 GPU の NVIDIA のページの Supplementary Power Connectors 欄、2026年10月19日に確認)。買うカードと電源の仕様を見比べて、必要な本数の PCIe 8ピン (または対応電力の PCIe Gen 5) の接続を用意できるかを確かめる。使うケーブルは、電源に付いてくるものか、電源のメーカーが対応を示しているものにする。BTO は、注文する構成 (GPU を変えたときは変更後) の仕様欄で、電源の W 数を見ればよい。
NVIDIA の仕様は、NVIDIA 以外の会社が作るカード (ASUS・MSI など) では異なることがある。店頭で買うカードの多くはそうしたカードなので、買うカードの商品ページの推奨電源容量も見比べる。
RTX 5090 は、仕様表の 1000W を目安にする。NVIDIA のページには、仕様表とは別に電源の確認欄に「850W Minimum」という見出しもあり、構成によってはより大きな容量が要ることがあると書かれている。「NVIDIA の公称仕様」には仕様表の値を載せた。
LLM を GPU 1枚で動かしたとき、カードの電力は VRAM に全部載ったモデルで高くなった。
| GPU | モデル | カードの電力 | 載り方 |
|---|---|---|---|
| RTX 5080 16GB | phi4:14b | 316.8W | VRAM に全部載った |
| RTX 5080 16GB | qwen3:14b | 301.9W | VRAM に全部載った |
| RTX 5080 16GB | gemma4:12b | 264.8W | VRAM に全部載った |
| RTX 5080 16GB | qwen3-coder:30b | 105.3W | 一部があふれた |
| RTX 5080 16GB | qwen3.6:35b-a3b | 99.5W | 一部があふれた |
| RTX 5060 Ti 16GB | phi4:14b | 179.5W | VRAM に全部載った |
| RTX 5060 Ti 16GB | qwen3:14b | 166.5W | VRAM に全部載った |
| RTX 5060 Ti 16GB | gemma4:12b | 155.4W | VRAM に全部載った |
| RTX 5060 Ti 16GB | qwen3-coder:30b | 71.6W | 一部があふれた |
| RTX 5060 Ti 16GB | qwen3.6:35b-a3b | 64.3W | 一部があふれた |
RTX 5080 の最大 316.8W と RTX 5060 Ti の 179.5W は、どちらも phi4:14b の行 (5モデル中の最大) だった。公称の消費電力の目安 (360W と 180W) と比べると、RTX 5080 は届かず、RTX 5060 Ti は近くまで上がった。値は、3回生成した各回の出力が終わった直後に、nvidia-smi の power.draw (この世代の GPU では直前1秒の平均) を1回ずつ読み、3つの読み取りのうちの最大を取ったものだ。瞬間の最大電力ではない。カード単体の値で PC 全体の電力でもないので、推奨電源容量より小さい電源を選ぶ根拠にはしない。
VRAM からあふれた2本はカードの電力が下がったが、どちらも MoE で作りも違い、あふれた分を受け持つ CPU の電力も測っていないので、省エネとは読まない。
ワット数の決め方や電源の規格の見方はAI用PCの電源(PSU)選び方に、モデルごとのカードの電力はローカルLLM推論時のGPU電力の実測で比べている。
冷却とケース
冷却とケースは、GPU を長い時間高い負荷で動かす前提で選ぶ。まず、GPU の寸法がケースに収まるかを確かめる。
生成AIは、GPU を長い時間高い負荷で動かすことがある。LLM では RTX 5060 Ti のカードの電力が公称の目安の近くまで上がり、SDXL の短い生成中の GPU 温度は 58〜68°C だった。
ケースは、対応する GPU の長さ・厚み・高さと、選ぶ GPU の寸法を商品ページで見比べ、電源ケーブルを挿す側の余白も見る。冷却とケースの選び方の詳しい話は、AI用PCの冷却とケースの選び方に続く。
よくある質問
メインメモリは32GBと64GBのどちらにするか
画像生成が中心なら 32GB、動画生成まで使うなら 64GB から考える。測定機で画像と動画のモデルを1つずつ測ると、画像1枚を作ったときに使ったメモリの最大は 32GB を下回り、短い動画1本 (864x480・56フレーム) も最大 44.73 GiB (GiB は GB に近い単位) と 64GB を下回った。64GB を超えたのは、長い動画のアップスケールの1回だけだった。LLM は目安を出していない。VRAM 16GB を少し超える大きさの5本で Ollama が使ったメモリは最大で約11GiB、確保量は最大で約25GiB だったが、LLM のために何GB を選べば足りるかは、この記事では決めていない。どれもメインメモリ96GB・VRAM 16GB (RTX 5080) の測定機の値で、OS などが使う分は含まない。32GB・64GB の PC では試していない。ページファイル (メモリが足りないときに SSD などを代わりに使う仕組み) を小さくしている PC では、32GB なら画像生成でも、64GB なら動画生成でも足りないことがある。ページファイルは初期設定のままにし、その置き先のドライブの空きも残しておく。それでもメモリ不足のエラーが出るときは、ページファイルの大きさと置き先の設定を見直す。
SSD は何TB あればよいか
モデルを入れ替えながら使うなら 1TB、モデルも生成物も消さずにためるなら 2TB から選ぶ。入れ替えながら使う場合は、モデルの合計に余裕を足した容量が 1TB に収まる見込みだ。
モデルの合計は、モデルをダウンロードするサイト (配布元) でファイルサイズを確かめて足す。本文の数字を当てはめた仮の例は次のとおりで、合わせて約145〜163GB になる。
- 画像・動画のモデルの本体ファイル3本: 約48GB (1本 16GB 前後として)
- 動画のモデル1式: 約42.5GB
- VRAM 16GB に入りきらない大きさの LLM 3本: 54〜72GB 級
ここにソフト本体・OS・作った画像や動画と、モデルによって別に要る付属のファイルが加わる。LLM 30個と動画約1800本のほか、作業用のファイルや画像・動画のモデルも消さずに残した測定機のデータ用ドライブでは、AI 関連だけで 1326.9 GB になった。
電源は何 W を選ぶか
選んだ GPU の推奨電源容量以上のものを選ぶ。NVIDIA が公表している値では RTX 5060 の 550W から RTX 5090 の 1000W までで、たとえば RTX 5080 は 850W だ。
VRAM が足りないとき、メインメモリを増やせば代わりになるか
メインメモリを増やしても、VRAM の容量は増えない。VRAM 16GB を少し超える大きさの LLM 5本では、載りきらない分 (全体の 22〜42%) がメインメモリ側に置かれて動いたが、どのモデルも、16GB の GPU 2枚に全部載せた構成より遅かった (16GB 1枚の速さは、モデルの作りによって毎秒 55.5〜72.5 トークンと毎秒 7.4〜12.8 トークン。トークンは LLM が文章を区切って数える単位)。1枚と2枚では容量以外も変わるので、遅さの原因があふれた分だけとは言えない。画像・動画生成でメインメモリが VRAM の代わりになるかは確かめていない。
測定の条件と注意点
この記事の実測値は、当サイトの測定機・設定で、2026年8月9日から10月23日に測ったもの。NVIDIA の仕様値と Ollama の FAQ・ライブラリは、本文に確認日を書いた。
測定機は Intel Core i7-14700F・メインメモリ96GB・Windows 11 の1台で、測定日とソフトのバージョンは表ごとに違う。使った GPU は、nvidia-smi のカード別の記録で確かめた。LLM を動かしたときに使ったメモリの表だけは、Ollama の報告とログで確かめた。各表の条件は次のとおり。
- SDXL の生成時間 (3枚の GPU): RTX 5080 と RTX 5060 Ti は2026年9月27日、RTX 4070 SUPER は9月28日に測った。ComfyUI 0.37.1・PyTorch 2.14.0+cu130 で、SDXL Base 1.0 を、拡散モデルとテキストエンコーダを FP8 で持たせて動かした。1280x720・30ステップ、3枚とも同じワークフローとプロンプトで、seed は回ごとに変えた。生成時間は各5回のうち初回の読み込みを除いた4回の中央値。VRAM 増分は nvidia-smi の MiB 表示を GiB に直した値。接続は、RTX 5080 が本体の PCIe 5.0 x16、RTX 5060 Ti と RTX 4070 SUPER が OCuLink の外付け (PCIe 4.0 x4)。
- 画像・動画生成で使ったメモリの最大: GPU は RTX 5080 16GB 単体。ComfyUI 0.31.1 の行は2026年9月11日、0.37.1 の行は9月25日の測定。Krea 2 は Turbo の FP8 で、1024x1024 の画像を1回の生成で1枚ずつ作った。動画生成はどちらのバージョンも各条件3回走らせ、表の値は読み込み直後の初回を除いた2回の最大 (0.31.1 は初回を含めた3回で取っても 44.04〜44.73 GiB の範囲は変わらない)。0.37.1 の行は、表の4条件 (LoRA あり/なし・4/8ステップ) を PyTorch の2通りでそれぞれ測った計8条件で、条件ごとに ComfyUI を起動し直した。13.2〜18.0 GiB は、8条件それぞれの最大値のうち、最も小さい値から最も大きい値までの範囲だ。画像生成とアップスケールは 0.31.1 の値を載せた。
- 16GB 1枚と2枚構成の LLM の比較: Ollama 0.32.3、Q4_K_M、コンテキスト長 8192。16GB 1枚は RTX 5080 16GB、2枚構成は RTX 5080 16GB と RTX 5060 Ti 16GB (OCuLink 接続) に載せた。1枚の測定は2026年8月17日と8月25日、2枚の測定は8月17日と9月8日。速さは各3回の中央値で、文章を出力している間の速さ (モデルの読み込みと入力を読む時間は含まない)。考える過程を出さない設定 (think=false) で seed を固定し、温度などの設定は各モデルの既定値のまま。前のモデルを VRAM から外してから測ったことが記録で確かめられるのは16GB 1枚の dense 3本 (8月25日) だけで、ほかの測定では前のモデルが残っていたとみられる回もある。そのため、速さと VRAM に載った割合は、測定前の状態をそろえた比較ではなく参考値として読む。
- LLM を動かしたときのカードの電力: 2026年8月17日、Ollama 0.32.3・コンテキスト長 8192・think=false・出力512トークン上限・同一プロンプト・同一 seed。各 GPU 1枚だけに推論させた構成で、GPU・モデルごとに3回生成した。値は、3回の生成それぞれで出力が終わった直後に1回ずつ読み、その3つのうちの最大を取ったものだ。モデルの読み込み中や入力を読んでいる間の電力は見ていない。
- LLM を動かしたときに使ったメモリ: 2026年10月23日にこの記事のために測った。Ollama 0.40.9、RTX 5080 16GB 1枚、Q4_K_M、コンテキスト長 8192 (gemma4:31b だけ 32768 でも測った)、think=false、出力512トークン上限、同一プロンプト・同一 seed。Flash Attention 有効・KV キャッシュ f16・並列数1・同時に読み込むモデル1で、GPU は CUDA_VISIBLE_DEVICES=0 で RTX 5080 だけにした。モデルは測る直前に最新のものを取り直した。各モデルの前に、読み込まれているモデルが無いことを確かめ、3回ずつ生成した (1回目はモデルの読み込みを含む)。値は3回を通した最大。gemma4:31b は、生成を速めるための小さな補助のモデルを一緒に読み込んだ。Ollama の報告 (ollama ps) は本体よりずっと小さい 1.5 GiB (ログの補助のモデルの分に近い) しか返さなかったので、本体が VRAM に載りきらなかったことは Ollama のログ (61層のうち38層が GPU) で確かめた。測定中は同じ PC で、別に起動した Ollama のサーバー (0.34.4) が別の LLM を CPU だけで動かしていたので、速さと PC 全体のメモリ使用量は載せていない。メモリの値は、測定に使った Ollama 0.40.9 のサーバー (待ち受けのポート番号で見分けた) と、その子プロセスの値だけを足したもので、別のサーバーのプロセスは含めていない。
- ComfyUI の models フォルダの内訳・Ollama のタグごとの論理サイズ・生成物の大きさ・消さずに残した2TBのドライブの内訳: 2026年9月6日に全ファイルを数えた時点の値。
- MiniMax H3 を動かすのに使ったファイル: 2026年8月9日に取得したファイルの大きさ。
メモリ使用量の最大は、ComfyUI のプロセス木のワーキングセット (RSS) を0.25秒間隔で観測した最大値で、物理メモリに載っていた量の観測値 (観測 RSS) だ。OS やほかのアプリの分は含まない。各プロセスの値を足した合計なので、共有分を重ねて数えることや、OS が物理メモリから外した分を数えないことがある。画像生成の Krea 2 は、ComfyUI の起動オプションの reserve-vram (OS やほかのソフトのために空けておく VRAM の量) を 1.5GB と 12GB の2通りにして測った。設定ごとに ComfyUI を3回起動し、1回の起動で2枚ずつ作った。値は、各起動の1枚目 (モデルの読み込みが入る回) を除いた、2つの設定を合わせて計6枚の最大で、この起動オプションの違いで観測 RSS はほとんど変わらなかった。アップスケールは、読み込んだフレームをまとめて4倍に拡大し、動画に書き戻す処理の流れで測った。アップスケールの回数は、192フレームだけ1回、ほかの条件は各2回で、最大は1回目も含めて取った。
確保量は、ComfyUI のプロセス木の各プロセスのプライベートコミット量 (Windows の PrivateUsage) を足した値を、0.25秒間隔で観測した最大だ。観測 RSS (物理メモリに載っていた量) とも、予約しただけの仮想アドレス空間の大きさとも別の量だ。画像1枚 (Krea 2・ComfyUI 0.31.1) の確保量は 36.19 GiB、LoRA ありでは 36.61 GiB で、どちらも読み込み直後の初回を除いた回の値だ (初回はこれより少し大きい)。動画1本 (MiniMax H3・ComfyUI 0.31.1) の確保量は、4条件それぞれで初回を除いた2回の最大が 59.32〜60.37 GiB で、0.37.1 では 28.2〜33.0 GiB (8条件それぞれの最大の範囲) だった。測定日は、0.31.1 の値が2026年9月11日、0.37.1 の値が9月25日で、どちらも RTX 5080 16GB・メインメモリ96GB の測定機の値だ。物理メモリとの比較には、確保量より観測 RSS のほうが近い。
「LLM を動かしたときに使ったメモリ」の表の2つの値は、Ollama のプロセス木 (Ollama のサーバーと、モデルを動かす子プロセス) について同じように測った。この Ollama 0.40.9 は、ログによると、Windows で CUDA を使う構成では、モデルのファイルをメモリマップ (ファイルの中身をメモリとして直接読む仕組み) で読まない設定が既定で選ばれていた。これと確保量の大きさの関係は確かめていない。
動画生成の 0.31.1 の行は PyTorch 2.9.1+cu128、0.37.1 の行は PyTorch 2.14.0+cu130 と 2.9.1+cu128 の両方で測った範囲で、0.37.1 の LoRA ありの条件では 2.9.1+cu128 が 18.0 GiB、2.14.0+cu130 が 14.2 GiB だった。
表のメモリの値はメインメモリ96GB の測定機1台で使った量で、足りなくなる境界でも確定した必要量でもない。SSD の値は1台に残っていたファイルの合計で、2TB の目安はこの1台の残し方から出した。測定のあとに Ollama や ComfyUI の新しいバージョンが出ていて、qwen3.6:35b-a3b などのタグも中身が更新されている (LLM を動かしたときに使ったメモリの表だけは、更新後のモデルと Ollama 0.40.9 で測った)。
電力は LLM の推論だけで、GPU 1枚の構成のカード単体の値だ。GPU 温度は、SDXL の短い生成中の、計測中の最高値だ。2枚構成は 16GB の GPU 2枚で、RTX 5060・RTX 5070・RTX 5070 Ti・RTX 5090 は公称値だけを載せた。
測っていないのは、32GB・64GB の PC での実走、VRAM が 16GB 以外の GPU でのメモリ使用量、864x480・56フレームより長い・大きい動画生成のメモリ使用量、SSD の読み書きの速度、画像生成・動画生成と2枚構成の電源、何時間も回し続けたときの温度、32GB を1枚で持つ GPU、2枚構成での gemma4:26b と qwen3.5:35b-a3b、RTX 5060・RTX 5070・RTX 5070 Ti・RTX 5090 の実機、生成した画像・動画の出来と LLM の回答の中身だ。LLM を動かしたときの PC 全体のメインメモリ使用量と、今のバージョンでの LLM の速さは、同じ PC で別の LLM が動いていたため載せていない。「16GB 1枚と2枚構成の LLM の比較」の表は、Ollama 0.32.3 で測ったときのままだ。速さやメモリの量の違いから、出来の良し悪しは読めない。
測定機の構成は検証環境のページに詳しく、ほかの GPU やモデルの実測はAIハードウェア実測データベースから探せる。
測ったモデルのライセンス
部品選びとは別に、測ったモデルを使うなら、個人で使う場合もライセンスを配布元で確かめておく。Krea 2 (Turbo) のライセンスは、生成物を含む商用利用を、関連会社を含めた全社・全収入源の直近12か月の売上が100万ドル未満の場合に限って認めていて、それ以上なら別の Enterprise License を求めている。不適切な生成を防ぐ仕組み (コンテンツフィルタ) の用意も求めている。MiniMax H3 に付く Community License は、EU・英国・韓国・米国では、モデルの利用も、生成物の利用・配布・表示も許諾していないので、これらの地域で使うなら別の許諾を確かめる。
参考資料
- NVIDIA GeForce RTX 5060 Family 仕様
- NVIDIA GeForce RTX 5070 Family 仕様
- NVIDIA GeForce RTX 5080 仕様
- NVIDIA GeForce RTX 5090 仕様
- Ollama FAQ
- How to determine the appropriate page file size for 64-bit versions of Windows(Microsoft Learn)
- Krea 2 Turbo モデルカード(Hugging Face)
- MiniMax H3 の ComfyUI 向け配布ページ(Hugging Face)
- MiniMax H3 Community License
当サイトはAmazonアソシエイト・プログラムの参加者です。Amazonのアソシエイトとして、当サイトは適格販売により収入を得ています。本記事には各種アフィリエイトリンク(広告)を含み、リンク経由で購入されると当サイトに紹介料が入る場合があります。実際の販売価格と条件は、購入時にリンク先でご確認ください。