この記事の要点
MOSS-Image は、ComfyUI のテンプレートどおりのファイルのまま、測った GPU のどちらでも最後まで生成できた。配布元の推奨を超える解像度 (2048×2048) でも、生成中に共有 GPU メモリが GiB 単位で増えることは無かった。
推奨の設定に替えると時間が伸び、同じ seed なら構図の大枠はそのままで、光や細部は変わる。どちらで回すかは、時間を取るか配布元に近い設定を取るかの選択になる。
プロンプト拡張が足すのは1枚に数秒で、試した日本語の文字では、拡張なしでも拡張ありでも、ほとんどが指定どおりに描けた。本体はテンプレートの既定のファイルで足りる。本体を bf16 に替えると、時間は数倍に伸び、同じ seed の構図はほぼ同じで細部が変わった。
MOSS-ImageはVRAM 16GBで動くか
結論から言うと、動いた。メインメモリ96GiB の測定機で、ComfyUI のテンプレートどおりの3ファイルを使い、RTX 5080 と RTX 5060 Ti (どちらも VRAM 16GB) の両方で 1024×1024 の画像を最後まで生成できた。テンプレートの設定のまま、プロンプト拡張を通さずに回したときの、2枚目以降の1枚あたりの時間 (中央値) は、RTX 5080 で11.2秒、RTX 5060 Ti で22.9秒だった。RTX 5060 Ti の値は、OCuLink (PCIe 4.0 x4) で外付けした接続で測ったものだ。
数字は2026年10月19日に ComfyUI 0.42.1 で測った。テンプレートの設定は25ステップ・CFG 2.5・er_sde・simple・SLG off だ。秒数は、ComfyUI に生成を送ってから、画像の保存が終わったことを確かめるまでの時間で、この確認と記録の後処理の分 (中央値で0.7秒ほど) も入っている。4つの主題を3周 (周ごとに seed を変えた計12枚) 回し、起動直後の1枚を除いた11枚の中央値を出した。時間と画像の差を測った拡張なしの回には、拡張が先に書いた説明文を固定で与えた。日本語の文字を試した回の拡張なしは条件が違い、日本語の文字の節に書いた。
テンプレートの既定どおりプロンプト拡張 (短い指示を場面全体の説明文に書き直す処理。MOSS-Image ではテキストエンコーダ自身が書く) を通すと、1枚は RTX 5080 で12.8秒、RTX 5060 Ti で26.4秒になった。短いプロンプトから毎回拡張する使い方での値だ。RTX 5080 の拡張ありは上の11.2秒とは別の段 (拡張の有無を比べた対照の段) で測っていて、同じ段の拡張なしは10.6秒だった。増えた時間のうち、拡張の文章を書く TextGenerate の時間は、プロンプト拡張の節に載せた。
2048×2048 で生成したとき、Windows の性能カウンタで1秒ごとに見た共有 GPU メモリは、最大でも RTX 5080 で464MiB、RTX 5060 Ti で270MiB で、生成中に GiB 単位で増える動きは無かった。1024×1024 では記録していない。この解像度での画像の崩れは評価していない。
MOSS-Image は、OpenMOSS が2026年10月16日に公開した画像生成モデルだ。MOSS-Image-Base と、それを追加学習した MOSS-Image-SFT の2つがあり、README と SFT のモデルカードによれば、重みと推論コードは Apache License 2.0 で公開されている。
ComfyUI は 0.42.1 以降を勧める。リリースノートによると、v0.42.0 (2026年10月18日) で MOSS-Image に対応した。ただし MOSS のテンプレートを動かすと一部の環境で落ちる問題があり、v0.42.1 (2026年10月19日) で直った。日付はどちらも UTC で、v0.42.0 は日本時間では19日にあたる。この記事の実測はすべて 0.42.1 で行った。
FLUX.3 Image Klein については、同じ VRAM 16GB の2枚で測った 実測記事 がある。この記事の後半では、FLUX.3 Image Klein と同じ説明文・同じ seed で回して、時間と文字を比べている。
MOSS-Imageの中身: SFTとBase、配布元の推奨設定
OpenMOSS の README が挙げる特徴のうち、この記事に関わるのは4つ。文字や物の配置を指定できること (レイアウト)、画像の中に文字を描き込めること、最大4Kトークンの長いプロンプトを受け付けること、5B のバックボーンで動くこと。いずれも配布元の説明だ。
この記事で「本体」と書くのは、画像を作る拡散モデル (ComfyUI では diffusion_models に置くファイル) のこと。この 5B のバックボーンが本体に当たる。
SFT と Base の違い
README と USERGUIDE によると、SFT は Base を選んだデータで追加学習したモデルで、配布元の例では SFT のほうが文字のまとまりが整っている。Base は CFG の蒸留などの後処理をしておらず、LoRA を作りやすいようにしたモデルだと説明されている。
配布元の推奨の設定
USERGUIDE の Base 向けの節 (README の既定値の表も同じ値) が挙げる設定は、ステップ数50以上・CFG 3 (3〜6)・Shift 5・サンプラーは Euler。あわせて SLG (Skip Layer Guidance) を使う。SLG は、ネガティブ側の計算で一部の層を飛ばすガイダンスで、飛ばす層は22層目 (0から数える) が推奨されている。SLG を切ると写実的になるが、細部が崩れることがある、とも書かれている。SFT のモデルカードの既定値も同じ値 (CFG 3・50ステップ・Euler・Shift 5) だ。
この記事で「推奨の設定」と呼ぶのは、ステップ数50・CFG 3・サンプラー Euler・スケジューラ sgm_uniform・Shift 5・SLG on (22層目) の組み合わせだ。sgm_uniform は OpenMOSS の ComfyUI 向けの README にある値だ。Shift 5 は ComfyUI 0.42.1 の MOSS-Image の既定で、SLG の22層目はテンプレートの SLG ノードの値と同じなので、Shift と SLG の層の2つはテンプレートのまま使った。SLG をかける範囲 (start 0・end 0.5) とネガティブプロンプトも、テンプレートのままにしてある。
ただし OpenMOSS が配る ComfyUI 用のワークフローは、SLG の範囲が 0〜1 でネガティブプロンプトは空なので、推奨の設定は配布元の設定を完全に再現したものではない。
SFT のモデルカードによれば、既定のガイダンスは1ステップにトランスフォーマーを2回通す。
解像度・言語・必要な VRAM
解像度は総画素数 1M・1.5M・2M が推奨で、0.25M (512×512) から 4M までは外挿できるとしている。幅と高さは16の倍数にする。
プロンプトの言語は、学習データの最も多い英語が推奨で、中国語やほかの言語にも対応するとある。2026年10月19日に確認した時点で、日本語を名指しした記載は無い。
必要な VRAM の数字は、配布元からは出ていない。README の Memory and performance の節 (Gradio の設定) は、GPU のメモリが足りなければ Sequential モード (遅くなる) にするか、画像を小さくするよう案内している。
どのファイルを使うか
ComfyUI 用のファイルは、Hugging Face の Comfy-Org/MOSS-Image に役割ごとに分かれて置かれていて、ログインせずに落とせる。本体は SFT と Base の int8 と bf16、テキストエンコーダ (Qwen3.5 9B) は w4a8・int8・bf16、VAE は FLUX.2 の small と標準 (flux2-vae) がある (2026年10月19日に HF API で確認、リビジョン 3284a1db)。
ファイル一覧の表は、そのうちこの記事で使ったファイルと大きさ (API の値を GiB に直したもの) を役割ごとにまとめたもの。Base の bf16 (9.47GiB) は測っていないので外した。
| 役割 | ファイル | サイズ |
|---|---|---|
| 本体 SFT (int8・テンプレートの既定) | moss_image_sft_int8_convrot.safetensors | 5.04GiB |
| 本体 SFT (bf16) | moss_image_sft_bf16.safetensors | 9.47GiB |
| 本体 Base (int8) | moss_image_base_int8_convrot.safetensors | 5.04GiB |
| テキストエンコーダ (w4a8・テンプレートの既定) | qwen3.5_9b_w4a8_gptq.safetensors | 6.84GiB |
| テキストエンコーダ (int8) | qwen3.5_9b_int8_convrot.safetensors | 9.08GiB |
| テキストエンコーダ (bf16) | qwen3.5_9b_bf16.safetensors | 17.98GiB |
| VAE (small・テンプレートの既定) | flux2-vae_small.safetensors | 0.23GiB |
| VAE (標準) | flux2-vae.safetensors | 0.31GiB |
ComfyUI のテンプレート (image_moss_image_t2i) の JSON では、既定のファイルは SFT int8 (moss_image_sft_int8_convrot.safetensors)・テキストエンコーダ w4a8 (qwen3.5_9b_w4a8_gptq.safetensors)・small VAE (flux2-vae_small.safetensors) の3つ。設定は 1024×1024・25ステップ・CFG 2.5・er_sde・simple で、この記事ではこれを「テンプレートの設定」と呼ぶ (Comfy-Org/workflow_templates の commit 69dedd6b の値)。
この3ファイルは合わせて約12.1GiB で、推奨の設定に替えても追加のファイルは要らない。テンプレートの注記によれば、プロンプト拡張も MOSS-Image のテキストエンコーダ自身 (同じ w4a8 のファイル) で動くので、拡張のために別のモデルを落とす必要もない。
テキストエンコーダの bf16 は、ファイル一覧の表のとおりファイルだけで 16GB を超えるが、どちらの GPU でも最後まで生成できた。その時間は、本体とテキストエンコーダの精度の節に載せる。
テンプレートの設定と配布元の推奨: 時間は約1.9倍、構図の大枠は同じ
次の表は、テンプレートの注記にある、テンプレートの設定と「配布元に近い設定」の違いを並べたものだ。
| 項目 | テンプレート | 配布元に近い設定 |
|---|---|---|
| Steps | 25 | 50 |
| CFG | 2.5 | 3 |
| Sampler | er_sde | Euler |
注記によれば、25ステップ・er_sde のテンプレートの設定は、ComfyUI に MOSS-Image を足した PR #17095 の速い設定に合わせたもので、速さとの引き換えであって不具合ではない。配布元に近い結果が欲しければ50ステップ・CFG 3を試すように、とも書かれている。
推奨の設定は1枚が約1.9倍
設定ごとの時間の表は、本体とテンプレートの設定・推奨の設定の組み合わせごとに、1枚と1ステップの時間を並べたもの。テキストエンコーダは w4a8、1024×1024・拡張なしで、同じ説明文と seed を使った。推奨の設定は 50ステップ・CFG 3・euler・sgm_uniform・SLG on。値は起動直後の1枚を除いた11枚の中央値で、1ステップは ComfyUI の進捗表示 (s/it) の値。— は RTX 5060 Ti では測っていない組み合わせ。
| 本体 | 設定 | RTX 5080 (1枚) | RTX 5080 (1ステップ) | RTX 5060 Ti (1枚) | RTX 5060 Ti (1ステップ) |
|---|---|---|---|---|---|
| SFT int8 | テンプレート (SLG off) | 11.2秒 | 0.38秒 | 22.9秒 | 0.83秒 |
| SFT int8 | 推奨 | 19.8秒 | 0.36秒 | 43.4秒 | 0.83秒 |
| SFT int8 | テンプレート (SLG off)・別の起動 | 10.6秒 | 0.36秒 | — | — |
| SFT int8 | テンプレート + SLG on | 10.6秒 | 0.36秒 | — | — |
| Base int8 | テンプレート (SLG on) | 10.6秒 | 0.36秒 | — | — |
| Base int8 | テンプレート + SLG off | 10.6秒 | 0.36秒 | — | — |
| Base int8 | 推奨 | 19.5秒 | 0.36秒 | — | — |
推奨の設定に替えると、1枚の時間はテンプレートの設定の約1.9倍になった (RTX 5080・RTX 5060 Ti とも)。RTX 5080 の推奨の行 (19.8秒) は、ComfyUI を電力スロットリング (省電力のための速度制限。詳しくは測り方の節) の対象から外して測り直した起動の値だ。約1.9倍は、この起動で同じく測ったテンプレートの設定 (10.6秒) と比べた値だ。表のテンプレートの11.2秒は別の起動の値だ。RTX 5060 Ti のテンプレートの行と推奨の行は同じ日に続けて測った。1ステップの時間はほぼ同じなので、時間が伸びた主因はステップ数とみられる。ただし替えたのはステップ数だけでなく、CFG・サンプラー・スケジューラ・SLG も同時だ (Shift と SLG ノードの層と範囲の指定はテンプレートのまま)。ステップ数だけの効果は分けて測っていない。
RTX 5080 では SLG は時間をほぼ足さなかった
テンプレートの SLG の切り替え (サブグラフの入力 switch_1) は、SFT のテンプレートでは off、Base のテンプレート (image_moss_image_base_t2i) では on になっている。SFT で off にしている理由は、テンプレートには書かれていない。
RTX 5080 で SLG を on にしても、1ステップは on 0.357秒・off 0.360秒、1枚は10.6秒と10.6秒で、時間はほぼ変わらなかった (SFT int8 + テキストエンコーダ w4a8・テンプレートの設定・拡張なし)。SLG ノードの範囲はテンプレートの値 (start 0・end 0.5) のままにした。この値はステップ数の割合でなく sigma で見た割合だ。ほかの GPU では測っていない。時間は変わらないが、画像は変わる。
RTX 5080 では Base も SFT と同じ速さ
Base int8 は SFT int8 と同じ速さだった。RTX 5080・テキストエンコーダ w4a8・1024×1024・拡張なしで、テンプレートの設定 (Base のテンプレートは SLG on) が10.6秒、推奨の設定が19.5秒。比べた SFT は、設定ごとの時間の表のうち SLG を揃えた行だ。同じ seed でも、Base の画像は SFT と色味や構図が変わる。
同じ seed で並べた画像
同じ説明文・同じ seed で並べると、テンプレートの設定と推奨の設定で構図の大枠は同じで、光の当たり方や細部が変わった。RTX 5060 Ti で4つの主題 × 3周を並べて目で見た結果で、どちらが良いかは採点していない。
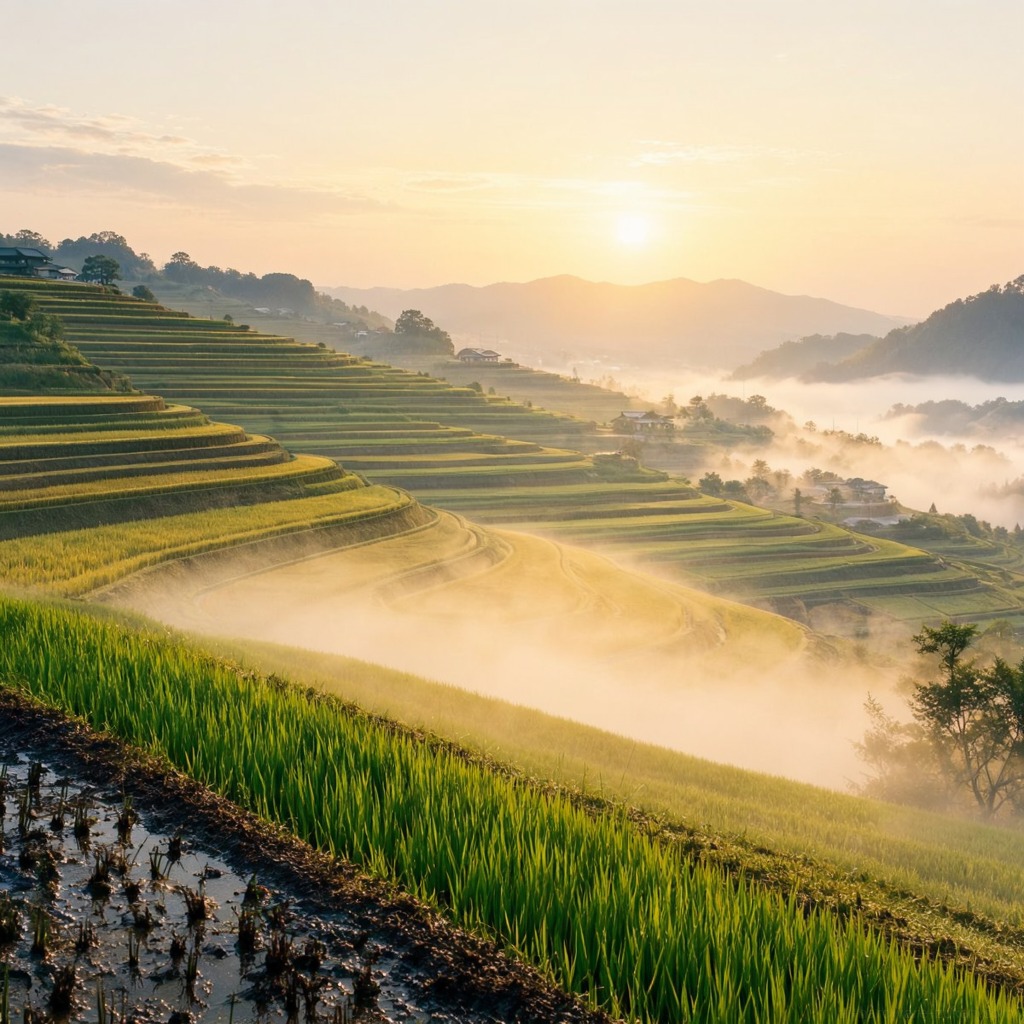
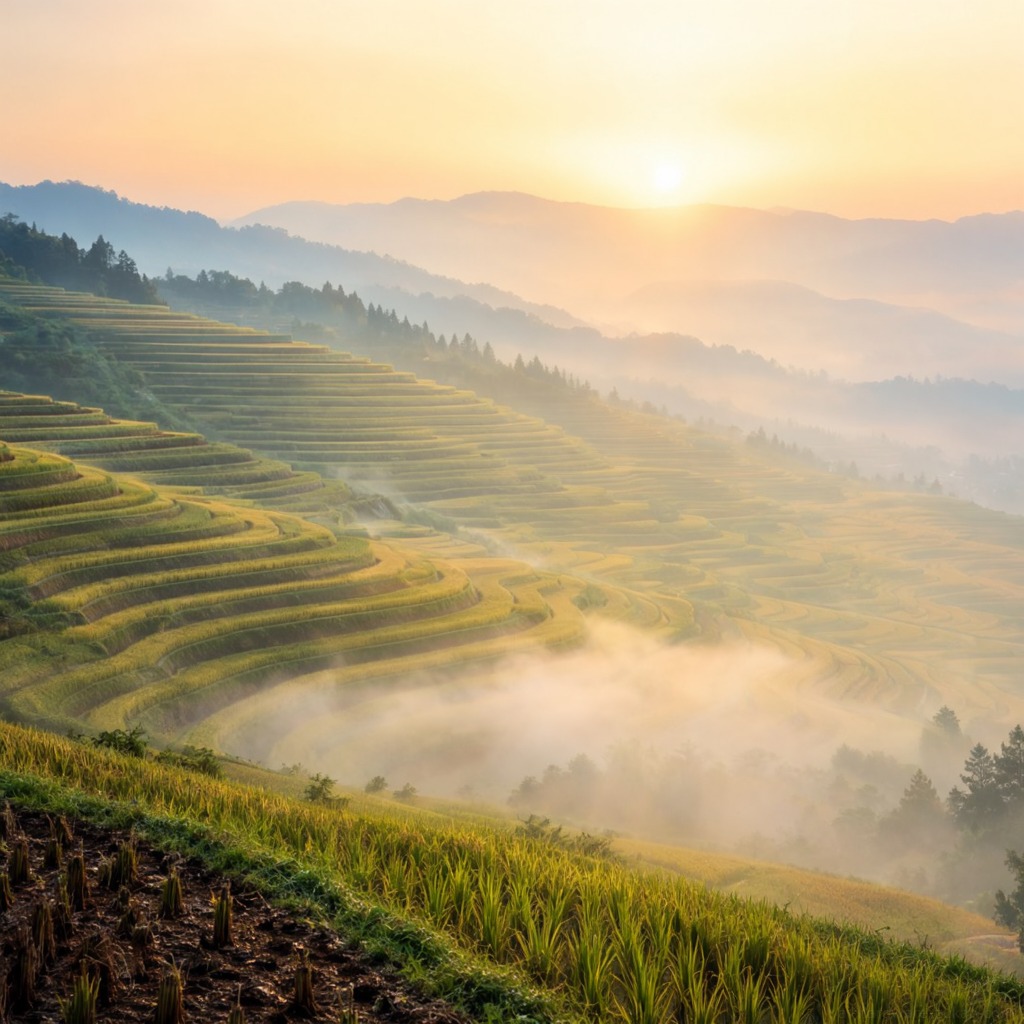
テンプレートの設定 (サンプラーが er_sde) では、同じ説明文・同じ seed でも RTX 5080 と RTX 5060 Ti で別の画像になった。推奨の設定 (Euler) では、2枚の GPU でほぼ同じ画像だった (SFT int8 + テキストエンコーダ w4a8・1024×1024・4つの主題 × 3周。比べた組の数と数値は画素の差の表)。ComfyUI 0.42.1 のソースでは、er_sde がステップの途中で足す乱数を GPU の上で作っている (comfy/k_diffusion/sampling.py の sample_er_sde が default_noise_sampler を呼び、torch.Generator(device=x.device) で作る)。同じ seed で2枚の GPU それぞれの上に乱数を作って比べると、1回目に引いた乱数は約1割しか一致せず、2回目以降に引いた乱数は1つも一致しなかった。途中で乱数を足さない Euler では2枚でほぼ同じ画像だったので、er_sde で画像が分かれるのは主にこの乱数の違いによるとみられる。途中の乱数を揃えて生成し直す確認はしていない。
測ったのは同じ PC の2枚の GPU だけだが、seed を共有しても、テンプレートの設定では GPU が違うと同じ画像が出るとは限らない。
プロンプト拡張を入れると何秒増えるか
テンプレートでは、プロンプト拡張が最初から on になっている。短いプロンプトを場面全体の説明文に書き直してからモデルへ渡す仕組みで、実際に使われた説明文はサブグラフの中の PreviewAny に出る (テンプレートの注記の記載)。
増える時間
拡張の有無ごとの時間の表は、拡張を通したときに1枚がどれだけ伸びるかと、そのうち拡張の文章を書く TextGenerate ノードの所要を並べたもの。SFT int8・テンプレートの設定・1024×1024 で、拡張ありは短いプロンプトから毎回拡張する使い方。起動直後の1枚を除いた11枚の中央値で、RTX 5080 の行は、本体とテキストエンコーダの精度の節の表とは別の起動 (同じ日の対照の段) で測った。
| プロンプト拡張 | テキストエンコーダ | RTX 5080 (1枚) | RTX 5080 (うち拡張) | RTX 5060 Ti (1枚) | RTX 5060 Ti (うち拡張) |
|---|---|---|---|---|---|
| なし | w4a8 | 10.6秒 | — | 22.9秒 | — |
| あり (テンプレートの既定) | w4a8 | 12.8秒 | 2.0秒 | 26.4秒 | 3.3秒 |
| あり | int8 | 13.4秒 | 2.4秒 | 26.6秒 | 3.7秒 |
テンプレートの既定 (w4a8) で拡張を通したときに増えた時間は、ほぼ TextGenerate の時間に当たる。ただし RTX 5060 Ti では、拡張ありの回に画像へ渡った説明文が、拡張なしの回に固定で渡した説明文 (先に書いておいたもの) と違っていた。RTX 5080 では同じ説明文だった。拡張を通すときも、テキストエンコーダを w4a8 から int8 に替えた差は1枚で1秒未満で、TextGenerate どうしの差も1秒未満だった。
起動直後の1枚目
ComfyUI を起動して最初の1枚 (モデルの読み込みを含む) は、テンプレートの組み合わせ・拡張なしで RTX 5080 が14.3秒、RTX 5060 Ti が26.5秒だった。拡張ありでは17.2秒・31.2秒。組み合わせごとに ComfyUI を起動し直した直後の各1回だけの値で、中央値ではない。
拡張は説明文をどう書き直すか
プロンプト拡張は、短い指示を英語の説明文に書き直す。この記事で拡張を通した回では、説明文は730〜1,160字ほどだった。RTX 5080 で、文字を描かせる短いプロンプト5種類 × seed 4つの拡張の出力を、指定の文字列と文字単位で照合した。拡張の出力の照合の表のとおり、描かせる文字列 (日本語・中国語・英語) は20件すべてで引用符の中に入っていた。「午後3時から」の4件は数字の前後に空白が入った (この照合では空白の有無は数えず、文字の並びだけを見た)。
| 指定の文字 | 拡張の出力に残ったか |
|---|---|
| ようこそ | 4件中4件 |
| 本日の会議は/午後3時から | 4件中4件 (『午後 3 時から』と数字の前後に空白が入った) |
| サクラソーダ | 4件中4件 |
| FRESH COFFEE/OPEN 8AM | 4件中4件 |
| 记得买牛奶和鸡蛋!ほか2行 (計3行・中国語・配布元の例) | 4件中4件 |
拡張を通して変わるのは、指定した文字列ではなくそのまわりの描写だ。拡張が足した説明 (例: ラベルは無地のピンクで文字は黒の太字) に沿って、画像の作りも変わる。
日本語の文字は描けるか
配布元の USERGUIDE は英語を推奨し、中国語やほかの言語にも対応するとしているが、日本語を名指しした記載は無い。そこで RTX 5080 で日本語の文字を主題3つ × seed 4つで描かせ、出た画像を目で読んだ。1字でも違えば不一致として数えていて、採点や文字認識の計測ではない。
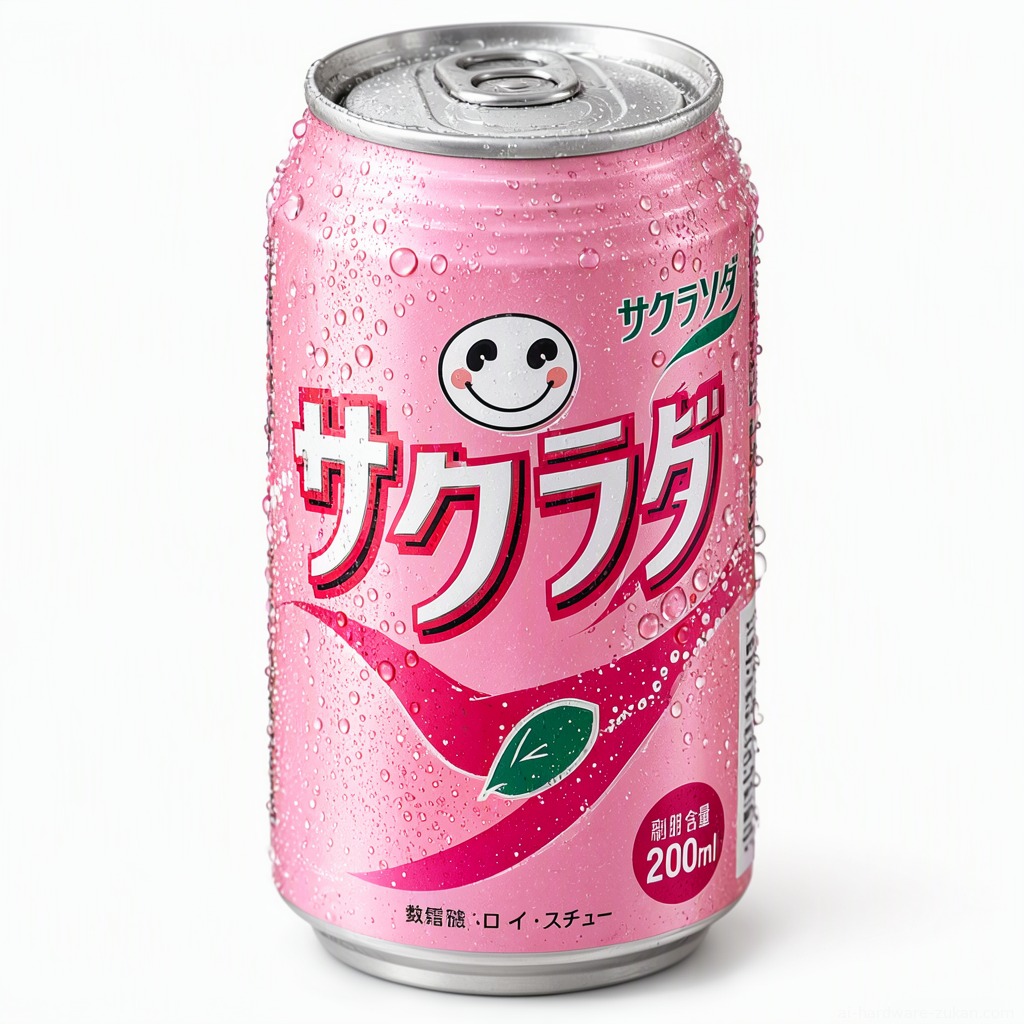
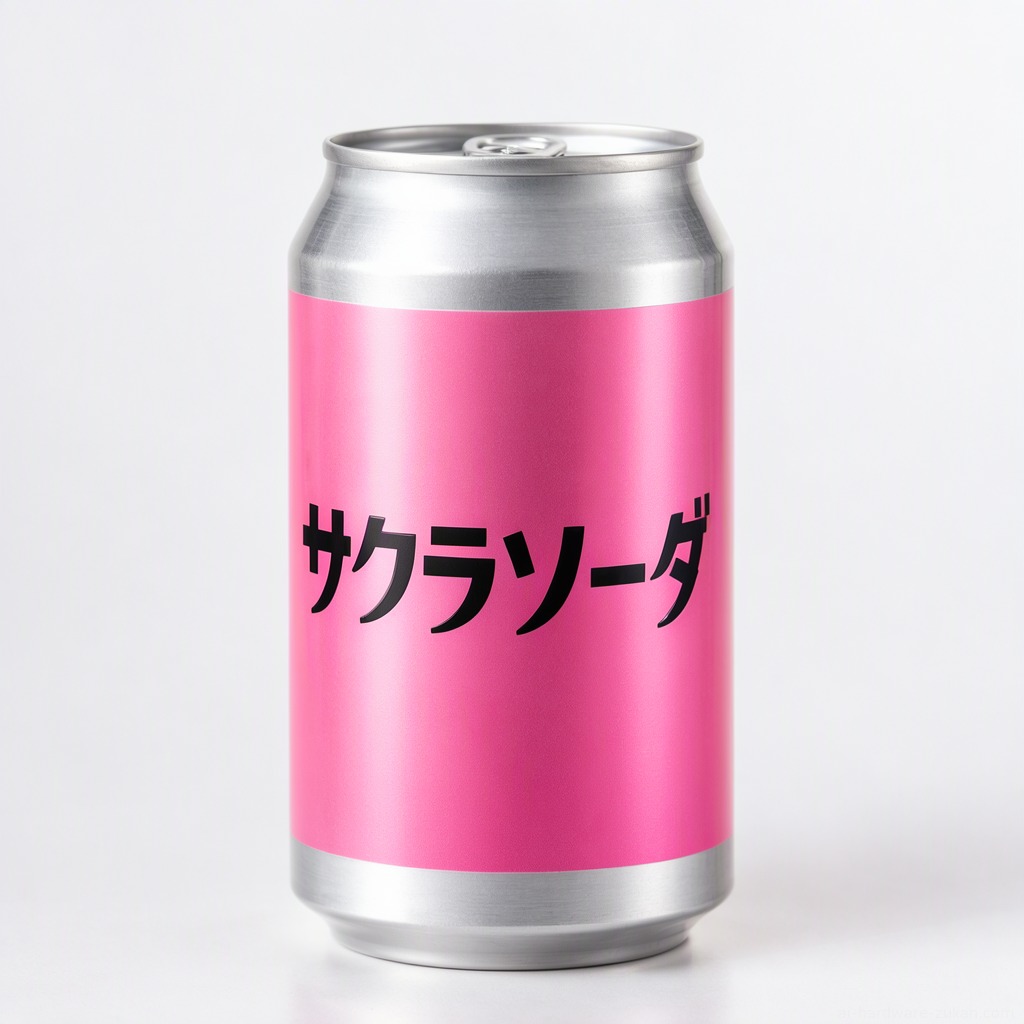
文字の読み取り結果の表は、指定した文字が拡張なし・拡張ありで何枚指定どおりに描けたかをまとめたもの (1024×1024・SFT int8 + テキストエンコーダ w4a8・テンプレートの設定)。看板の行は RTX 5060 Ti、ほかは RTX 5080 で出した。この表の「拡張なし」は、短いプロンプトをそのまま渡した回だ。短いプロンプトは英語の文で、描かせる日本語だけを引用符で入れた (例: A product photo of an aluminum soda can with a pink label printed with the katakana brand name "サクラソーダ")。時間の表の「拡張なし」は、拡張が書いた説明文を固定で渡した回なので、条件が違う。「拡張あり」は、テンプレートの拡張が書いた説明文を渡した回。看板の行だけは、FLUX.3 Image Klein の拡張が書いた説明文を固定で渡している。
| 指定の文字 | 拡張なし | 拡張あり |
|---|---|---|
| ようこそ (かな) | 4枚中4枚 | 4枚中4枚 |
| 本日の会議は/午後3時から (漢字かな混じり2行) | 4枚中4枚 | 4枚中4枚 |
| サクラソーダ (カタカナの商品名) | 4枚中3枚 (1枚は『サクラダ』。周りに崩れた小さな文字) | 4枚中4枚 (ラベルは無地に近い作り) |
| FRESH COFFEE/OPEN 8AM (英語) | 4枚中4枚 | 4枚中4枚 |
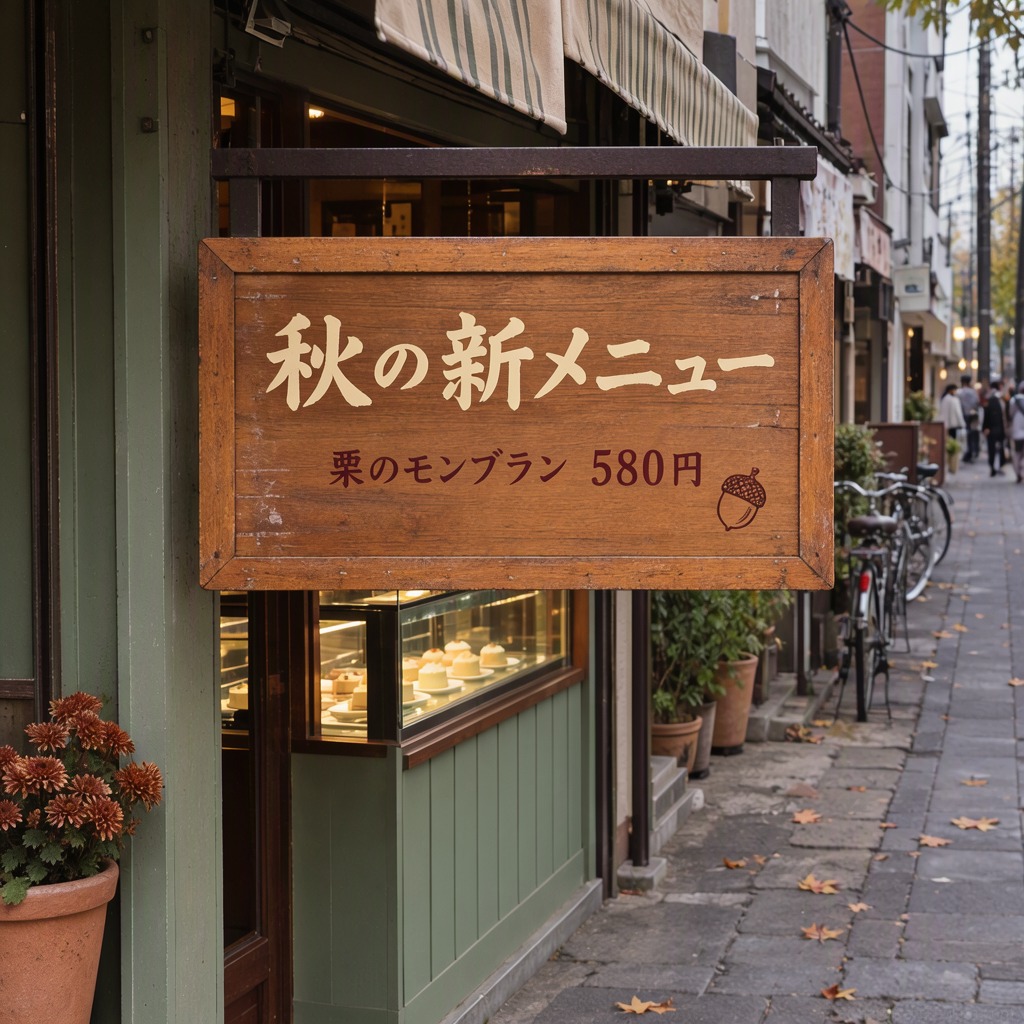
| 秋の新メニュー/栗のモンブラン 580円 (看板・FLUX.3 Image Klein との比較。説明文は FLUX.3 Image Klein の拡張が書いたものを固定) | MOSS-Image テンプレートの設定 3枚中3枚・推奨の設定 3枚中3枚・FLUX.3 Image Klein 3枚中3枚 | — |
拡張なしで、指定した文字列が違う字になったのは、カタカナの商品名「サクラソーダ」の4枚中1枚 (「サクラダ」) だけだった。拡張を通すとサクラソーダも4枚とも指定どおりで、拡張の有無の差はこの1枚になる。指定していない背景の小さな文字は、拡張なしの缶の周りで崩れていたほか、拡張なしの「ようこそ」でも4枚中少なくとも3枚 (seed 222・333・444) で、背景の看板や札の小さな文字が崩れていた。拡張ありで背景の文字が崩れるかどうかは確かめていない。
ただし拡張ありは、缶のラベルが無地に近い作りになっていた。拡張が書いた説明文に沿った結果で、同じ画像のまま文字だけを比べたわけではない。日本語の文字一般についての結果でもなく、試した主題3つ・各4枚の範囲の結果だ。
本体とテキストエンコーダの精度: int8とbf16の速さと画像
ここから先は、ファイルの精度を替えたときの細かい実測になる。差がはっきり出たのは本体で、テキストエンコーダは w4a8 と int8 の差が小さく、bf16 にすると時間が少し伸びた。
精度ごとの時間
精度の組み合わせごとの時間の表は、本体2種類とテキストエンコーダ3種類の6通りを、1024×1024 で回した1枚あたりの時間。テンプレートの設定 (25ステップ・CFG 2.5・er_sde・SLG off)・プロンプト拡張なし (拡張済みの説明文を固定) で、起動直後の1枚を除いた11枚の中央値。ComfyUI に送ってから完了を確かめるまでの秒数で、RTX 5060 Ti は OCuLink (PCIe 4.0 x4) 接続。
| 本体 | テキストエンコーダ | RTX 5080 | RTX 5060 Ti |
|---|---|---|---|
| SFT int8 | w4a8 | 11.2秒 | 22.9秒 |
| SFT int8 | int8 | 10.7秒 | 22.7秒 |
| SFT int8 | bf16 | 12.2秒 | 24.9秒 |
| SFT bf16 | w4a8 | 28.7秒 | 63.5秒 |
| SFT bf16 | int8 | 29.1秒 | 63.9秒 |
| SFT bf16 | bf16 | 33.3秒 | 66.7秒 |
6通りとも、どちらの GPU でも最後まで生成できた。テンプレートの組み合わせ (SFT int8 + テキストエンコーダ w4a8) の 1024×1024 から見ると、テキストエンコーダを int8 に替えても時間はほとんど変わらない。ファイルだけで 16GB を超える bf16 (17.98GiB) に替えても最後まで生成できた。w4a8 から bf16 にすると、本体 int8 との組では、時間がどちらの GPU でも約9%伸びた。本体 bf16 との組では、RTX 5080 で約16%、RTX 5060 Ti で約5% 伸びた。
差が大きいのは本体で、bf16 (9.47GiB) にすると、テキストエンコーダ w4a8 との組で int8 の約2.6倍 (RTX 5080)・約2.8倍 (RTX 5060 Ti) かかった。ComfyUI の進捗表示 (s/it) で見たサンプラーの1ステップが、int8 の0.38秒・0.83秒に対して、bf16 では1.06秒・2.43秒と長い。なぜ1ステップが長くなるのか、原因は切り分けていない。
精度を替えたときの画像の差
画素の差の表は、同じ説明文・同じ seed の画像どうしが画素の上でどれだけ違うかを、比べた組み合わせごとにまとめたもの。PSNR は大きいほど似ている (同じ画像なら無限大)。平均の差は 0〜255 の画素値の平均絶対差。どちらも、4つの主題 × 3周のうち起動直後の1枚と、元画像が残っていない1組を除いた10〜11組 (組数の列) の中央値で、画像の良し悪しの指標ではない。
| 比べた2つ | 組数 | PSNR (中央値) | 平均の差 (中央値) |
|---|---|---|---|
| 本体 int8 と bf16 (テキストエンコーダ w4a8・RTX 5060 Ti) | 10 | 28.7dB | 4.4 |
| テキストエンコーダ w4a8 と int8 (本体 int8・RTX 5060 Ti) | 10 | 27.1dB | 5.0 |
| テキストエンコーダ int8 と bf16 (本体 int8・RTX 5060 Ti) | 11 | 33.0dB | 2.4 |
| VAE 標準と small (RTX 5080) | 11 | 37.3dB | 2.0 |
| SLG on と off (RTX 5080) | 11 | 22.4dB | 11.1 |
| テンプレートの設定 (er_sde) の RTX 5080 と RTX 5060 Ti | 10 | 12.3dB | 42.9 |
| 推奨の設定 (Euler) の RTX 5080 と RTX 5060 Ti | 10 | 34.4dB | 1.7 |
本体を int8 と bf16 で替えても、テキストエンコーダを w4a8・int8・bf16 で替えても、同じ seed なら構図はほぼ同じで、顔がどちらを見ているか、文字の並び、背景の小物といった細部が変わった (RTX 5060 Ti・4つの主題 × 3周を画素の差と目視で確かめた)。精度の違いによる差は、SLG の on と off や、テンプレートの設定で GPU を替えたときの差より小さく出ている。
VAE を small から標準の flux2-vae に替えても、RTX 5080 (SFT int8 + テキストエンコーダ w4a8・テンプレートの設定・拡張なし) で1枚の時間は10.6秒と10.6秒で、画像もほとんど変わらなかった。
FLUX.3 Image Kleinと比べる
FLUX.3 Image Klein との比較の表は、同じ ComfyUI 0.42.1・同じ説明文・同じ seed で、MOSS-Image と FLUX.3 Image Klein (蒸留モデル int8 + テキストエンコーダ int8・16ステップ) を回した1枚あたりの時間。1024×1024 で、どちらもプロンプト拡張なし。説明文は、ほかの表と違い、FLUX.3 Image Klein のプロンプト拡張が書いた4つ (人物・商品・風景・日本語の看板) を両方に渡した。起動直後の1枚を除いた11枚の中央値で、うちサンプラーは KSampler ノードの所要。
| モデル | RTX 5080 (1枚) | RTX 5080 (うちサンプラー) | RTX 5060 Ti (1枚) | RTX 5060 Ti (うちサンプラー) |
|---|---|---|---|---|
| MOSS-Image SFT int8 + w4a8 (テンプレートの設定・25ステップ) | 10.6秒 | 9.1秒 | 23.3秒 | 21.1秒 |
| MOSS-Image SFT int8 + w4a8 (推奨の設定・50ステップ) | 19.9秒 | 18.4秒 | 43.8秒 | 41.7秒 |
| FLUX.3 Image Klein 蒸留モデル int8 + テキストエンコーダ int8 (16ステップ) | 3.7秒 | 2.6秒 | 7.3秒 | 5.7秒 |
同じ説明文・拡張なしの条件では、1枚は FLUX.3 Image Klein のほうが短かった。ただし FLUX.3 Image Klein は16ステップの蒸留モデルで、量子化の方式もテキストエンコーダも MOSS-Image と違う。差をモデルの構造だけによるものとは読めない。
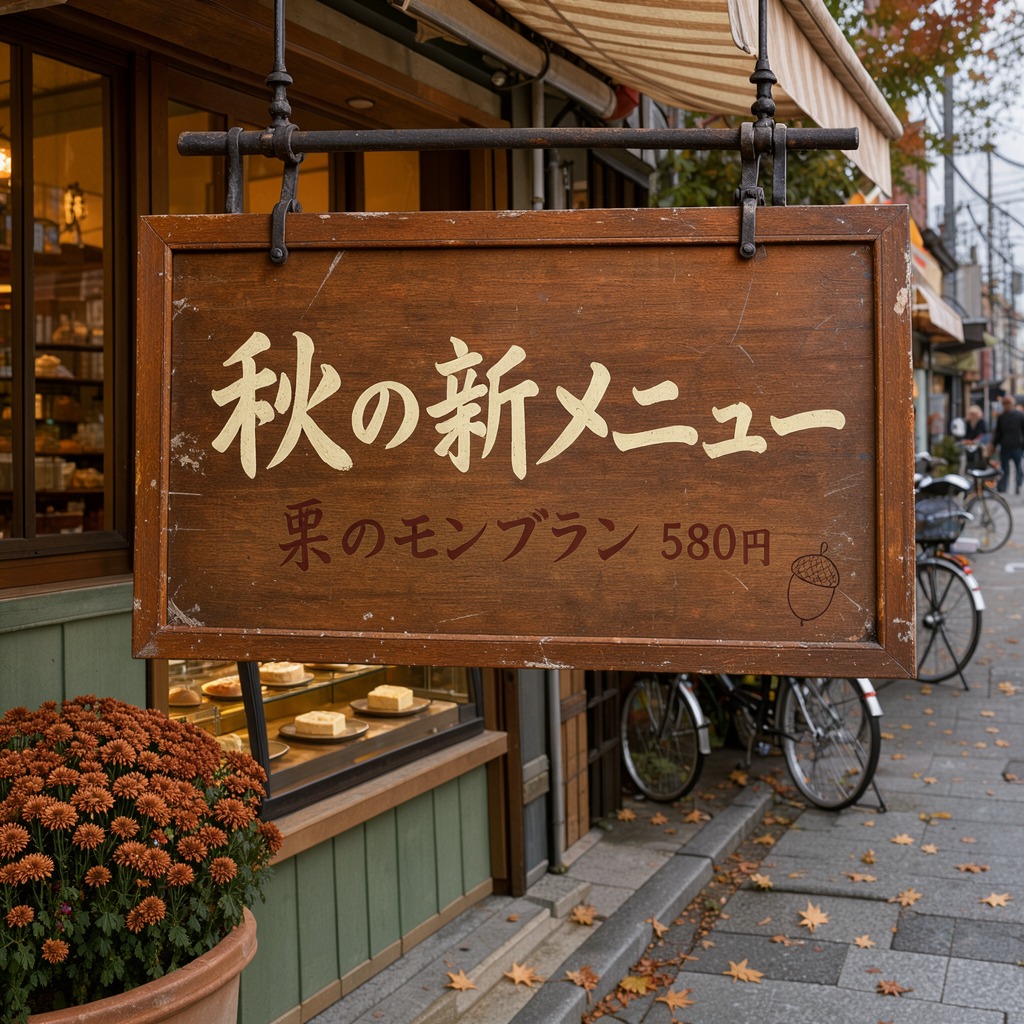
日本語の看板 (「秋の新メニュー」「栗のモンブラン 580円」) は、MOSS-Image のテンプレートの設定・推奨の設定も、FLUX.3 Image Klein も、3枚ずつすべて2行とも指定どおりに描いた。RTX 5060 Ti で出した主題1つ・各3枚を目で読んだ結果で、採点や文字認識の計測ではない。
文字の描き込みを売りにする画像モデルでは、同じ VRAM 16GB の環境で Qwen-Image-2.1 を動かした記録 もある。デザイン向けのモデルなら Ming-Image-0.1-Design の実測 が同じ VRAM 16GB での比較先になる。
解像度とVRAM: 2048×2048と12GB・8GB相当
解像度を上げたときの時間と共有 GPU メモリ
解像度ごとの時間の表は、SFT int8 + テキストエンコーダ w4a8・テンプレートの設定・拡張なしで、解像度を上げたときの1枚と1ステップの時間、共有 GPU メモリの量を並べたもの。1024×1024 の行は、設定ごとの時間の表の「テンプレート (SLG off)・別の起動」の行 (4つの主題 × 3周から起動直後の1枚を除いた11枚の中央値) と同じ値だ。ほかの行は、4つの主題に seed 12345・222・333・444 を1つずつ割り当てて各1回回し、起動直後の1枚を除いた3枚の中央値だ。共有 GPU メモリは、typeperf の GPU Adapter Memory を1秒ごとに記録した。表の最後の列は「開始時の値 → 回の途中の最大値」の形で、どちらも2回目以降のすべての回のうち最大のものを並べている (1回の値ではない)。1024×1024 では記録していない。
| 解像度 | GPU | 1枚 | 1ステップ | 共有 GPU メモリ (各回の開始時の最大→各回の最大) |
|---|---|---|---|---|
| 1024×1024 (約1M) | RTX 5080 | 10.6秒 | 0.36秒 | — |
| 1216×1216 (約1.5M) | RTX 5080 | 15.0秒 | 0.53秒 | — |
| 1456×1456 (約2M) | RTX 5080 | 22.9秒 | 0.83秒 | — |
| 2048×2048 (約4M) | RTX 5080 | 54.2秒 | 2.05秒 | 464MiB→464MiB |
| 2048×2048 (約4M) | RTX 5060 Ti | 127.0秒 | 4.91秒 | 270MiB→270MiB |
解像度を上げるほど、1ステップも1枚も長くなった。2048×2048 でも、1秒ごとに記録した共有 GPU メモリは、2回目以降の各回の最大が RTX 5080 で464MiB、RTX 5060 Ti で270MiB で、生成中に GiB 単位で増える動きは無かった (RTX 5080 では1回の中で約140MiB 増えた回があった)。ただし、ComfyUI の dynamic VRAM が重みをメインメモリから取り込む動きは、この指標には出ない。2048×2048 の nvidia-smi のピークは、RTX 5080 で最大15,337MiB、RTX 5060 Ti で14,790MiB だった (4回の最大、GPU 全体の値)。
配布元が推奨する総画素数は 2M までで、2048×2048 (約4M) は、外挿できるとされる 4M までの範囲には入るが推奨の外になる。この解像度で画像が崩れるかどうかは評価していない。
VRAM 12GB・8GB 相当に絞った模擬
VRAM を絞った模擬の表は、RTX 5060 Ti (VRAM 16GB) で ComfyUI が使える VRAM を起動オプションで絞り、テンプレートの組み合わせを回した結果。SFT int8 + テキストエンコーダ w4a8・テンプレートの設定・拡張なしで、絞った行は4つの主題に seed を1つずつ割り当てて各1回回し、起動直後の1枚を除いた3枚の中央値。絞らない行は、4つの主題 × 3周から起動直後の1枚を除いた11枚の中央値。ピークは nvidia-smi で見た GPU 全体の値。
| 使える VRAM | 起動オプション | 1枚 | nvidia-smi のピーク |
|---|---|---|---|
| 16GB (絞らない) | なし | 22.9秒 | 12,614MiB |
| 約12GB (模擬) | --reserve-vram 4 |
23.1秒 | 12,230MiB |
| 約8GB (模擬) | --reserve-vram 8 |
23.9秒 | 8,190MiB |
--reserve-vram 4 と --reserve-vram 8 は、ComfyUI が自分では使わずに残しておく VRAM を4GiB・8GiB にする指定で、既定の予約量の代わりになる。これで ComfyUI が使う VRAM を約12GB・約8GB に抑えたことになる。この絞り方でも、テンプレートの組み合わせは最後まで生成できた。RTX 5060 Ti で比べた範囲では、絞っても1枚の時間はほとんど変わらなかった。
12GB・8GB 相当の行は、VRAM 16GB の GPU で ComfyUI が使う量を抑えた模擬で、VRAM 12GB・8GB の GPU で測ったわけではない。--reserve-vram は物理的な VRAM の容量を変える機能ではない。VRAM の小さい GPU は演算の速さもメモリの帯域も違うので、模擬の時間はその GPU の速さを表さない。
dynamic VRAM や --reserve-vram がどう働くかは、ComfyUIの起動オプションを実測したガイド で詳しく扱っている。
nvidia-smi のピークを必要量として読まない理由
ComfyUI 0.42.1 は、起動時に dynamic VRAM を有効にしていた (起動ログに「DynamicVRAM support detected and enabled」)。空いている VRAM と予約量に応じて GPU に置く重みの量を変える動き方なので、nvidia-smi のピークは「それだけ要る量」を表さない。ピークは GPU 全体の値で、RTX 5080 で測った値には画面出力の分も含まれる。
レイアウト指定のテンプレート
レイアウト指定のテンプレート (image_moss_image_t2i_bboxes) も、既定のレイアウトと設定のまま (拡張 on・SLG on) 最後まで生成できた。RTX 5080 で起動直後に1回だけ回し、読み込みを含めて17.8秒だった。2枚目以降の時間は測っていない。
検証環境と測り方
測定環境の表は、この記事の実測に使った機材とソフトウェアをまとめたもの。RTX 5080 は画面出力を兼ねていて、RTX 5060 Ti は外付け (OCuLink) で画面出力には使っていない。
| 項目 | 内容 |
|---|---|
| GPU | RTX 5080 (VRAM 16GB、PCIe 5.0 x16) / RTX 5060 Ti (VRAM 16GB、OCuLink で PCIe 4.0 x4) |
| メインメモリ | 96GiB |
| OS / ドライバ | Windows 11 / NVIDIA 610.88 |
| ComfyUI | 0.42.1 (comfy-aimdo 0.5.6・comfy-kitchen 0.2.39) |
| PyTorch / Python | 2.14.0+cu130 / 3.12.10 |
| モデル | Comfy-Org/MOSS-Image (リビジョン 3284a1db、2026年10月19日に取得し sha256 を照合)。比べた FLUX.3 Image Klein は black-forest-labs/flux-3-image-klein-comfy (リビジョン 5c9b7148) の flux3_image_klein_sd_int8_convrot.safetensors・qwen3vl_4b_int8_convrot.safetensors・flux2-vae.safetensors |
| テンプレート | Comfy-Org/workflow_templates の image_moss_image_t2i / image_moss_image_base_t2i (commit 69dedd6b) |
| 回し方 | 1つの組み合わせごとに ComfyUI を起動し直し、1枚目 (読み込みを含む) と2枚目以降を分けて数えた。GPU は1枚ずつ順に使った |
本記事の実測値は2026年10月19日に、上記の測定機・設定で計測したもの。ファイルの大きさは Hugging Face の API の値を GiB に直したもの、VRAM の容量は GPU の表記 (16GB)、ピークは nvidia-smi の表示 (MiB) のままで書いている。測定機の詳細は 検証環境のページ にまとめてある。
測り方
GPU は CUDA_VISIBLE_DEVICES で1枚ずつ指定して順に使い、2枚を同時には回していない。各回の記録で、PyTorch が使った GPU と nvidia-smi で見た GPU が、指定した GPU と一致したことを確かめた。
短いプロンプトは4種類 (人物・商品・風景・英語の看板) で、seed 12345・222・333・444 を1つずつ割り当て、2周目以降は周ごとに1000ずつ足した。時間と画像の差を測った拡張なしの回には、拡張が先に書いた説明文を固定で与えた。日本語の文字を試した回の拡張なしは、短いプロンプトをそのまま渡した。FLUX.3 Image Klein と比べた表と、文字の読み取り結果の表の看板の行は、プロンプトの組がほかの表と違う。FLUX.3 Image Klein の拡張が書いた説明文 (人物・商品・風景・日本語の看板) を MOSS-Image にも固定で渡したためだ。
拡張の文章を書く TextGenerate の seed (画像の seed とは別) は、テンプレートの値の0から、同じ主題の2回目以降は1ずつ変えた (文字を試した回は0〜3)。拡張のほかの設定はテンプレートのまま。ネガティブプロンプトはどの回もテンプレートのまま (「nsfw, worst quality, bad anatomy, watermark, jpeg artifact」) で、USERGUIDE が推奨する文字列と同じだ。
計測中に、構成に関係なく1ステップが遅くなる時間帯が2回あった。Windows がバックグラウンドで動く ComfyUI のプロセスに電力スロットリング (省電力のための速度制限) をかけていたためで、その時間帯の値は使っていない。ComfyUI のプロセスだけをこの制限 (実行速度とタイマーの精度の両方) の対象から外して測り直した (OS の電源設定は変えていない)。どちらの制限が時間に影響していたかは分けて調べていない。
遅い時間帯は、同時に動かした別のプロセス (メモリの記録係) が1秒あたりに取れた記録の数で見分けた。制限の対象から外した ComfyUI は、記録係が遅い状態の間も、1枚の時間が速い時間帯と同じだった。どの起動のしかたでこの制限がかかるかは確かめていない。
測り直した後でも、RTX 5080 は起動し直すごとに1枚の時間が5%ほど揺れた (テンプレートの組み合わせ・拡張なしで10.6秒と11.2秒)。RTX 5060 Ti の揺れは1%ほどだった。記事の中で RTX 5080 の同じ組み合わせに2つの値が出てくるのは、この起動ごとの揺れによる。
測っていないこと
- 画質全般の優劣 (テンプレートの設定と推奨の設定、SFT と Base、MOSS-Image と FLUX.3 Image Klein のどれが良い画像か。作例は並べただけで採点していない)
- Linux での動作と速さ
- RTX 5080 と RTX 5060 Ti 以外の GPU
- VRAM 12GB・8GB の GPU の実機 (12GB・8GB 相当は VRAM 16GB の GPU での模擬)
- RTX 5060 Ti を OCuLink ではなく PCIe x16 のスロットにつないだ場合
- メインメモリが96GiB より少ない PC
- ComfyUI 以外の動かし方 (Diffusers や Gradio)
- LoRA
- ネガティブプロンプトを空にした場合 (SFT のモデルカードと配布元の ComfyUI 用ワークフローの既定) との比較
- 2048×2048 での画像の崩れ
ほかの GPU や画像モデルの数字は、AIハードウェア実測データベース から探せる。
まとめ
VRAM 16GB の GPU で試すなら、ファイルはテンプレートの既定の3つで足りる。測った範囲では、テキストエンコーダの w4a8 と int8、VAE の small と標準の違いは、時間にほとんど出なかった (テキストエンコーダの bf16 では少し伸びた)。本体を bf16 にすると、同じ seed の構図はほぼ同じで細部が変わり、時間は数倍に伸びた。この結果はメインメモリ96GiB の測定機でのもので、メモリの少ない PC で同じように動くかは確かめていない。
テンプレートの設定と推奨の設定は、構図の大枠は同じで、時間が約1.9倍違う。どちらの画像が良いかは採点していないので、迷ったらテンプレートの設定のまま回し、配布元の設定に近づけたくなったら推奨の設定を試せばよい。RTX 5080 では SLG は時間をほぼ足さなかったので、同じ seed で on と off を見比べやすい。同じ seed で、GPU が違う環境でも同じ画像を出したい場面では、測った2枚の GPU でほぼ同じ画像になったのは推奨の設定 (Euler) のほうだった。
プロンプト拡張は1枚に数秒を足す程度で、試した日本語の主題では、カタカナの商品名が拡張なしで4枚中1枚だけ指定と違う字になり、拡張ありでは4枚とも指定どおりだった。ただし差はその1枚で、画像の中身も拡張の説明文に沿って変わる。FLUX.3 Image Klein は、同じ説明文・拡張なしで1枚が短く、看板の日本語はどちらも描けた。ただしステップ数も量子化も違う比較だ。RTX 5060 Ti の値は OCuLink 接続での値になる。
参考資料
- MOSS-Image (OpenMOSS, GitHub)
- MOSS-Image User Guide (OpenMOSS)
- MOSS-Image-SFT (OpenMOSS-Team, Hugging Face)
- MOSS-Image Technical Report (arXiv 2610.23374)
- Comfy-Org/MOSS-Image (Hugging Face)
- ComfyUI v0.42.0 リリース
- ComfyUI v0.42.1 リリース
- ComfyUI PR #17095 (MOSS-Image の追加)
- MOSS-Image のテンプレート (Comfy-Org/workflow_templates)
- MOSS-Image ComfyUI README (OpenMOSS)
- ComfyUI v0.42.1 comfy/supported_models.py