この記事の要点
MiniMax-H3-Image は、VRAM 16GB の RTX 5080 と RTX 5060 Ti のどちらでも、配布元がネイティブとする解像度を超える大きさまで止まらずに生成できた。ComfyUI は H3-Image に対応したバージョンが要る。
本体のファイルは、Comfy-Org が配っている量子化済みの 2 種類のうち、時間とメモリで見ると w4a8 から始めやすい。RTX 5080 では int8 と時間がほぼ同じで、OCuLink 接続の RTX 5060 Ti ではテキストからの生成で int8 のほうが遅かった。int8 はメインメモリを多く使い、ダウンロードも大きい。同じ seed でも 2 つの本体の画像は一致しない。
ライセンスは日本を対象地域に含め、EU・英国・韓国・米国を除外地域としている。モデルだけでなく生成した画像も、除外地域での使用や表示は認められていない。
初めて動かす場合は「用意するファイルとComfyUIのバージョン」まで読めば、ライセンスの地域の条件と、必要なファイルとバージョンが分かる。使ったソフトのバージョン、起動オプション、試行回数は「検証環境と測り方」にまとめた。
MiniMax-H3-ImageをVRAM 16GBのRTX 5080とRTX 5060 Tiで動かした結果
MiniMax-H3-Image は、MiniMax が 2026年11月に重みを公開した画像生成モデルだ。2026年11月11日に、VRAM 16GB の RTX 5080 と RTX 5060 Ti で、ComfyUI 0.45.0 を使って動かした。本体(拡散モデル)は Comfy-Org が配っている w4a8(重みを 4 ビットで持つ量子化)と int8(重みを 8 ビットの整数で持つ量子化)の 2 種類を使い、テキストからの生成を 2048×2048(約 4 MP)から 4480×4480(約 20 MP)まで、画像編集を参照 1 枚で試した。
どちらのカードでも、どちらの本体でも、試した大きさはすべて最後まで生成できた。4096×4096(約 16 MP)の生成時間は、プロンプトを毎回変えた場合の中央値で、RTX 5080 では w4a8 が 28.01 秒、int8 が 27.91 秒、RTX 5060 Ti では w4a8 が 55.61 秒、int8 が 64.91 秒だった。計測の間にメモリ不足などで失敗した生成は無い。
計測は 2026年11月11日、メインメモリ 96GB の Windows 11 の PC で行った。2 枚のカードは同じ PC に付いていて、1 枚ずつ使って測った。RTX 5080 は画面をつないだカードで、接続は PCIe 5.0 の 16 レーン。RTX 5060 Ti は OCuLink 接続(PCIe 4.0 の 4 レーン)で、画面はつないでいない。RTX 5060 Ti の値には、GPU のちがいと接続のちがいの両方が入っている。本体とカードの組み合わせごとに ComfyUI を 3 回起動し直し、1 回の起動のなかで、読み込みを含む最初の 1 本のあと、大きさなどの条件を変えながら 5 本ずつ続けて生成している(条件の順番は「検証環境と測り方」)。
同じ MiniMax の動画モデルを 16GB で動かした結果は「MiniMax H3をVRAM 16GBで動かす|ComfyUIでの導入手順とRTX 5080・5060 Ti実測」にある。
MiniMax-H3 を元に作られた別の画像モデル P-H3-Image を、VRAM 16GB の RTX 5080 と RTX 5060 Ti で動かした結果は「P-H3-ImageをVRAM 16GBで動かす|ComfyUIで8MP生成、RTX 5080・5060 Tiの実測とw4a8・int8の選び方」にある。
MiniMax-H3-Imageとは
MiniMax-H3-Image は、テキストからの画像生成と、参照画像を使った画像編集を 1 つのチェックポイントで行うモデルだ。配布元のモデルカードには次のように書かれている。
- 拡散トランスフォーマー(DiT)は 33.1B パラメータで、動画モデル MiniMax-H3 の設計から音声の層を除いたもの
- 6 ステップに蒸留されていて、classifier-free guidance を使わない。ネガティブプロンプトには対応しない
- 出力は約 16 MP で、4096×4096(1:1)から 6272×2688(21:9)まで。有効な範囲は約 4 MP から 20 MP で、16 MP 前後がいちばん良いとされる
- 画像編集では、参照画像を 16 枚まで渡せる
- テキストエンコーダーは MiniMax-H3 の Qwen3-VL をそのまま使う
モデルカードによると、公式の重みは DiT が BF16 で 66.28GB あり、テキストエンコーダー(66.7GB)は MiniMax-H3 のリポジトリから読む。モデルカードが動作環境の例に挙げるのは NVIDIA H200 や RTX PRO 6000 Blackwell などで、VRAM の目安は書かれていない。この記事で 16GB のカードに使ったのは、「用意するファイルとComfyUIのバージョン」に挙げる、Comfy-Org が配っている量子化済みのファイルだ。
ライセンスで決まっていること
重みは「MiniMax-H3-Image Community License Agreement」で配られている。オープンソースのライセンスではなく、地域と用途に条件がある。2026年11月11日に読んだ本文(License date は November 10, 2026)から、使う前に知っておく条項を挙げる。2 つに分けたのは読むときの目安で、法律上の区分ではない。
個人で動かして画像を使うときにも関わる条項:
- 対象地域: 第I条3項は対象地域(Applicable Territory)を「worldwide, excluding the Excluded Territories」と定め、第I条5項は除外地域を「the European Union, the United Kingdom, the Republic of Korea and the United States of America」としている。日本は対象地域に入る
- 生成した画像にも地域の条件がかかる: 第V条4項は「You may not use, reproduce, modify, distribute, or display the MiniMax-H3-Image Works or any of their Outputs or results outside the Applicable Territory.」と定める。Outputs は、モデルを動かして得た結果を指す(第I条12項)。モデルを日本で動かしても、生成した画像を除外地域で使うことや表示することは、このライセンスでは認められていない
- ほかのモデルの改善に使わない: 第V条3項は、モデルと生成物を、MiniMax-H3-Image とその派生モデル以外の AI モデルの改善に使うことを禁じている
- 公開の場に出すとき: 付属の利用規定(Exhibit A)の 12 は、生成物を公開の場に出すときに、機械が生成したものだと明確に示すよう求めている
売上やサービスの提供で決まる条項と、商用で出すとき、再配布するときに関わる条項:
- 売上の条件: 第IV条1項は、本人と関連会社の Annualized Revenue が 100 万米ドルを超える場合と、第三者に Hosted Service(このモデルやその派生モデルを自分の側で動かし、API やウェブなどを通じて第三者に使わせるサービス)を提供する場合に、MiniMax から事前に書面で別の許可を得るよう求めている。動画モデルの MiniMax H3 のライセンスとは別の文書で、金額もちがう
- 商用の製品での表示: 第IV条2項は、モデルを使う商用の製品やサービスの画面に「MiniMax-H3-Image」と目立つように表示するよう求めている
- 再配布: 第III条は、対象地域の中で第三者に渡すときに、ライセンスの写しを付けることと、変更したファイルに変更した旨を示すことを求めている。決められた文面の NOTICE ファイルを付けることも求めている。Hosted Service を通じて渡す場合は、この NOTICE ファイルの要件の対象外になる
除外地域で使いたい場合は、MiniMax に連絡してライセンスを求めることができると、第II条に書かれている。プロンプト拡張用のモデル MiniMax-H3-Image-PE も、同じライセンスの対象だ。
ここに挙げたのは条項の一部で、法律上の助言ではない。商用で使うときや画像を公開するときは、ライセンスの本文を自分で読んで判断する。
用意するファイルとComfyUIのバージョン
ComfyUIは0.45.0以降
ComfyUI の公式チュートリアルは、H3-Image のテンプレートに ComfyUI 0.45.0 以上とテンプレートパック 0.11.104 以上が要ると書いている。H3-Image への対応は、v0.45.0 に入った変更(Support MiniMax-H3-image)で加わった。それより前のバージョンには H3-Image 用の条件付けノード(MiniMax H3 Image Conditioning)が無い。動画の MiniMax H3 を動かせている環境でも、ComfyUI が古ければ H3-Image は動かない。PyTorch にも条件がある。ComfyUI v0.45.0 の README は、NVIDIA の 20 シリーズ以降の GPU では、cu130(CUDA 13.0 向けのビルド)以上の PyTorch が必要だと書いている。前から使っている環境を更新するときは、ComfyUI だけでなく PyTorch の版も確かめる。
ComfyUI v0.45.0 は GitHub の Releases で配られていて、Windows 向けのポータブル一式もある。この記事の計測は、同じバージョンのソースから作った専用の環境で行った(使ったバージョンは「検証環境と測り方」)。
この記事で使ったファイル
Comfy-Org は、ComfyUI 用に詰め直したファイルを Hugging Face の Comfy-Org/MiniMax-H3-Image で配っている。本体のファイルには pruned という名前が付いていて、同じ場所にある bf16 の本体も 40.23GB と、公式の DiT(66.28GB)より小さい。何を削ったファイルなのかの説明は、2026年11月11日に確認した範囲では、このリポジトリの説明文に見つけられなかった。この記事で使ったのは次の 4 つだ。
| 役割 | ファイル名 | 大きさ | 置き場所 |
|---|---|---|---|
| 本体(w4a8) | minimax_h3_image_pruned_w4a8.safetensors |
12.55GB(11.69GiB) | ComfyUI/models/diffusion_models |
| 本体(int8) | minimax_h3_image_pruned_int8_convrot.safetensors |
20.98GB(19.54GiB) | ComfyUI/models/diffusion_models |
| テキストエンコーダー(nvfp4) | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
15.69GB(14.61GiB) | ComfyUI/models/text_encoders |
| VAE(fp16) | minimax_h3_image_vae_fp16.safetensors |
1.17GB(1.09GiB) | ComfyUI/models/vae |
大きさはファイルのバイト数を GB(10 の 9 乗)で表し、かっこ内に GiB を添えた。VRAM は RTX 5080 が 16,303MiB、RTX 5060 Ti が 16,311MiB(どちらも 15.9GiB)なので、int8 の本体はそれだけで VRAM より大きい。本体は w4a8 か int8 のどちらか 1 つがあれば動く。どちらにするか迷うなら w4a8 から始める。生成時間は、RTX 5080 では int8 とほぼ同じで、RTX 5060 Ti ではテキストからの生成で w4a8 のほうが短かった。ファイルとメインメモリの負担は、どちらのカードでも w4a8 のほうが小さかった(比較は「w4a8とint8はどちらを選ぶか」)。
テキストエンコーダーは nvfp4(NVIDIA の 4 ビット浮動小数点の形式)のファイルで、動画の MiniMax H3 と同じものだ。MiniMax H3 を ComfyUI で動かしたことがあれば、同じ名前のファイルがそのまま使える(この記事でも、以前から手元にあったファイルを使った)。VAE は H3-Image 専用で、動画用の VAE とは別のファイルになる。
チュートリアルが挙げるのは、int8 の本体、int8 のテキストエンコーダー(27.14GB。チュートリアルの表記は 25.28 GB で、同じファイルを GiB で表した値)、プロンプト拡張用の Qwen3.5 9B(7.34GB)、VAE の 4 つだ。w4a8 の本体と nvfp4 のテキストエンコーダーは、同じリポジトリに置かれている。この記事は int8 のテキストエンコーダーとプロンプト拡張を使っていない。
テンプレートと設定
ComfyUI のテンプレートは 2 つある。テキストからの生成(MiniMax-H3-Image: Text to Image)と、画像編集(MiniMax-H3-Image: Image Edit)だ。どちらもサンプラーは euler、スケジューラーは simple、6 ステップ、CFG は 1 になっている。ネガティブプロンプトの欄は無いので、避けたいものもプロンプトの中に書く。
テキストからの生成のテンプレートは、1:1 の 4 MP で開く。チュートリアルは、VRAM の少ない PC でメモリが足りなくならないよう、ネイティブの解像度よりわざと下げてあると説明している。幅と高さは 32 の倍数なら任意に指定できる。
プロンプト拡張(短い依頼文を、モデルが読みやすい詳しい英語の説明に書き直す処理)について、チュートリアルは、テキストからの生成のテンプレートは初めからオフ、画像編集のテンプレートはオンと説明している。この記事の計測で元にしたテキストからの生成のテンプレートのファイルでは、拡張を切り替えるスイッチがオンの値で保存されていた。開いたときにどちらになっているかは、自分の画面で確かめる。
テンプレートは、初めの状態で int8 の本体、int8 のテキストエンコーダー、プロンプト拡張用の Qwen3.5 9B を指している。この記事で使った w4a8 の本体や nvfp4 のテキストエンコーダーを使うには、読み込みのノードでファイル名を選び直す。
この記事の計測は、テンプレートを API 用の形に直し、プロンプト拡張のノードを外したグラフで行った。プロンプト拡張はテキストからの生成でも画像編集でも使わず、同じ文面のプロンプトをそのまま本体に渡している。テンプレートをそのまま開いて実行したときの時間とメモリは測っていない。プロンプト拡張のファイルが無い状態でテンプレートをそのまま実行できるかも確かめていない。テンプレートから始めるなら、チュートリアルが挙げる Qwen3.5 9B(7.34GB)も置いておく。
RTX 5080での生成時間
テキストからの生成は、4 つの大きさで測った。生成時間の表に、プロンプトを毎回変えた場合の時間をまとめる。
| 大きさ | w4a8 | int8 |
|---|---|---|
| 2048×2048(約 4 MP) | 8.98 秒 [8.59〜9.39] | 8.68 秒 [8.43〜9.25] |
| 2880×2880(約 8 MP) | 14.08 秒 [13.74〜15.94] | 13.91 秒 [13.50〜14.32] |
| 4096×4096(約 16 MP) | 28.01 秒 [27.44〜30.18] | 27.91 秒 [27.43〜32.83] |
| 4480×4480(約 20 MP) | 34.14 秒 [33.44〜38.59] | 34.35 秒 [33.72〜37.72] |
値は、3 回の起動それぞれで 5 本の中央値を取り、その 3 つの中央値を取ったもの。かっこ内は 15 本全部の最小と最大。時間は ComfyUI が 1 件の実行にかけた時間で、テキストエンコーダーの処理、モデルの入れ替え、サンプリング、VAE のデコード、PNG の保存を含む。モデルの読み込みを含む起動後の最初の 1 本は入れていない。プロンプト拡張は使っていない。秒数は RTX 5080 の値で、同じ表の w4a8 と int8 は同じカード・同じ条件の値どうしになる。
RTX 5080では、16 MPは4 MPの約3倍の時間
4096×4096 は 2048×2048 の 4 倍の画素数がある。RTX 5080 での時間は w4a8 で 3.1 倍、int8 で 3.2 倍だった。画素数に比例するよりは短い。プロンプトを毎回変える回には、大きさによらずテキストエンコーダーの処理が入り、モデルの入れ替えの時間も加わる。比例しないのは、サンプリング以外のこうした時間が全体の一部を占めるためと考えられる。ただし、処理ごとの内訳は測っていない。
サンプリング(6 ステップ)の進捗表示の経過は、4 MP で 3〜4 秒、8 MP で 8〜9 秒、16 MP で 20〜21 秒、20 MP で 26〜27 秒だった。この表示は 1 秒単位なので、目安として読む。
同じプロンプトでseedだけ変えると短い
RTX 5080 で同じプロンプトのまま seed だけを変えた回は、4 MP で w4a8 が 5.30 秒 [5.11〜5.92]、int8 が 5.53 秒 [5.28〜6.07] だった。プロンプトを変えた回より 3 秒あまり短い。
ComfyUI は、入力が変わらないノードの結果を使い回す。seed だけを変えた回のログには、テキストエンコーダーを読み込む行が出なかった。同じ依頼文で何枚も作って選ぶ使い方に近い条件で、今回の RTX 5080 の計測では、4 MP の 1 枚がこの時間だった。入力が変わらない部分を使い回せたときの値で、ほかの環境でも同じ時間になるとは限らない。ほかの大きさで seed だけを変えた回は測っていない。
起動後の最初の1本
RTX 5080 で ComfyUI を起動した直後の 1 本(4 MP)は、モデルの読み込みを含めて w4a8 が 11.0〜13.6 秒(3 起動)、int8 が 11.3〜16.3 秒(4 起動)だった。
この値は、OS のファイルキャッシュを消さずに測ったものだ。ファイルは計測の約 18〜100 分前にダウンロードするか読み込んでいた。その分がキャッシュに残っていたかどうかは確かめていない。PC を起動して最初に読む場合の時間は測っていない。
RTX 5080でのメモリ
メモリの表に、RTX 5080 でプロンプトを変えた回のピークを並べる。
| 大きさ | 本体 | GPU の使用量 | 共有 GPU メモリ | メインメモリ(作業セット) |
|---|---|---|---|---|
| 4 MP | w4a8 | 15,444MiB | 351MiB | 8.1GiB |
| 4 MP | int8 | 15,457MiB | 7,343MiB | 12.6GiB |
| 16 MP | w4a8 | 15,370MiB | 388MiB | 8.5GiB |
| 16 MP | int8 | 15,450MiB | 8,285MiB | 14.2GiB |
| 20 MP | w4a8 | 15,363MiB | 2,438MiB | 10.8GiB |
| 20 MP | int8 | 15,376MiB | 10,100MiB | 16.1GiB |
値は約 1 秒間隔で取った値の最大を、生成 1 本ごとに求め、生成時間の表と同じ方法で中央値にしたもの。1 秒より短いあいだだけ増えた分は取れていないことがある。表の 3 つの大きさは、1 回の起動のなかで 4 MP、16 MP、20 MP の順に測っていて(あいだにほかの条件が入る)、共有 GPU メモリとメインメモリは、あとの行ほど、前の条件で増えた分を含みうる。GPU の使用量は nvidia-smi の値で、画面表示などほかのソフトの分を含むカード全体の量。共有 GPU メモリは Windows のカウンタ(GPU Adapter Memory の Shared Usage)の値で、これもそのカードを使っているソフト全体の量。メインメモリは、ComfyUI のプロセスと、そこから起動された子プロセスの作業セット(プロセスが実際にメインメモリ上に置いている量)の合計。
RTX 5060 Tiでの生成時間
同じ PC に付いている RTX 5060 Ti(VRAM 16GB)でも、同じファイル、同じプロンプトと seed、同じ起動オプションで測った。ソフトの側で変えたのは、使う GPU の番号と ComfyUI のポート番号だけだ。カードの側は、GPU の種類のほかに、PC との接続と画面出力の有無もちがう。この RTX 5060 Ti は OCuLink でつないでいて、画面をつないでいない。接続のちがいが時間にどれだけ出ているかは分けていない。
| 条件 | w4a8 | int8 |
|---|---|---|
| 2048×2048(約 4 MP) | 15.01 秒 [14.71〜15.55] | 16.15 秒 [15.78〜17.06] |
| 2880×2880(約 8 MP) | 25.88 秒 [25.43〜26.45] | 27.92 秒 [27.40〜28.93] |
| 4096×4096(約 16 MP) | 55.61 秒 [54.51〜56.80] | 64.91 秒 [63.64〜94.58] |
| 4480×4480(約 20 MP) | 68.59 秒 [67.96〜68.94] | 78.62 秒 [78.03〜104.93] |
| 4 MP で seed だけ変えた回 | 10.32 秒 [10.16〜10.53] | 10.56 秒 [10.36〜10.78] |
| 画像編集(参照 1 枚、2720×1536) | 45.03 秒 [44.79〜46.29] | 47.28 秒 [46.16〜54.07] |
値の取り方は RTX 5080 の表と同じで、起動ごとの中央値を取り、その中央値を取ったもの。かっこ内は集計に使った全部の本の最小と最大。ほかの負荷と重なった回を外して測り直したので、本数は条件によって 13〜18 本になる(内訳は「検証環境と測り方」)。
このPCでは、テキストからの生成がw4a8でRTX 5080の1.7〜2.0倍の時間
テキストからの生成の w4a8 の中央値を RTX 5080 と比べると、4 MP で 1.67 倍、8 MP で 1.84 倍、16 MP で 1.99 倍、20 MP で 2.01 倍だった。画像編集は 2.21 倍、int8 は条件によって 1.86〜2.33 倍になる。16 MP の 1 枚には w4a8 で 1 分弱かかり、4 MP の 3.70 倍の時間になった(int8 は 4.02 倍)。seed だけを変えた回は、プロンプトを変えた回より w4a8 で 4.69 秒、int8 で 5.59 秒短い。起動後の最初の 1 本(4 MP、モデルの読み込みを含む)は、w4a8 が 18.7〜21.2 秒、int8 が 19.0〜20.9 秒だった(どちらも 4 起動)。この値も OS のファイルキャッシュを消さずに測っていて、前にファイルを読んでからの時間は記録していない。
この 2 枚は、GPU そのもののほかにも条件がちがう。RTX 5060 Ti は OCuLink でつないでいて、接続は PCIe 4.0 の 4 レーンだ(RTX 5080 は PCIe 5.0 の 16 レーン。どちらも nvidia-smi の表示)。画面もつないでいない。時間の差のうち、どれだけが接続のちがいによるものかは分けていない。
このPCのRTX 5060 Tiでは、テキストからの生成でint8のほうが遅い
RTX 5080 では w4a8 と int8 の時間に差が見えなかったが、RTX 5060 Ti では差が出た。int8 の中央値は w4a8 より、4 MP で 1.14 秒、8 MP で 2.04 秒、16 MP で 9.30 秒、20 MP で 10.03 秒長い。この 4 つの大きさでは、集計に使った全部の本の幅も重ならなかった。seed だけを変えた回(差 0.24 秒)と画像編集(差 2.25 秒)は、幅が重なった。この差が GPU のちがいによるのか、PCIe 4.0 の 4 レーンという接続や画面出力の有無によるのかは分けていない。
中央値どうしの差がどこで出ているかは、大きさによってちがった。サンプリングの 1 ステップの時間(進捗表示の値。w4a8 と int8 の 2 回ずつの起動で見た)は、16 MP で w4a8 が 7.60〜7.64 秒、int8 が 9.03〜9.10 秒、20 MP で 9.70〜9.74 秒と 11.45 秒だった。6 ステップ分にすると、16 MP と 20 MP の差のほとんどになる。4 MP は 1.48 秒と 1.44〜1.45 秒で、int8 のほうが長いわけではない。4 MP の 1.14 秒の差は、サンプリング以外の部分で出ている。
int8 は、時間のばらつきも大きかった。16 MP の 15 本のうち 3 本(75.91・78.22・94.58 秒)と、20 MP の 13 本のうち 3 本(90.31・90.64・104.93 秒)は、中央値より 10% を超えて長い。6 本のうち 5 本は 1 回目の起動に集まっていて、サンプリングの時間はほかの回と変わらず、その前後で時間がかかっていた。残る 1 本(94.58 秒)は、GPU の使用量が 16,029MiB まで上がった回で、サンプリングの 1 ステップあたりの平均が 14.24 秒に延びていた(ステップごとでは 9〜21 秒)。画像編集にも 54.07 秒かかった回が 1 本ある(中央値は 47.28 秒)。もう 1 枚の GPU の使用量、別のソフトのプロセス、PC 全体の CPU 使用率の記録には、この 6 本に重なる負荷は残っていない。20 MP は起動ごとの中央値も 90.31・78.62・78.11 秒と開いた。w4a8 は、どの条件でも全部の本が中央値の ±4% に収まった。
int8 が RTX 5060 Ti でだけ遅くなる理由と、数本だけ長くなる理由は、この計測からは特定できない。
RTX 5060 Tiでのメモリ
GPU の使用量のピークは、ほとんどの回で 14,780〜15,238MiB だった。RTX 5060 Ti の VRAM(16,311MiB)から、起動オプションで空けた分(1.5 の指定は、ComfyUI の中で 1,536MiB として扱われる)を引いた 14,775MiB に近い。例外は int8 の 1 回の起動で、続けて生成した 6 本が 15,539〜16,029MiB だった。
| 大きさ | 本体 | GPU の使用量 | 共有 GPU メモリ | メインメモリ(作業セット) |
|---|---|---|---|---|
| 4 MP | w4a8 | 14,852MiB | 272MiB | 7.9GiB |
| 4 MP | int8 | 14,812MiB | 6,665MiB | 12.0GiB |
| 16 MP | w4a8 | 14,876MiB | 272MiB | 8.3GiB |
| 16 MP | int8 | 14,828MiB | 7,364MiB [7,364〜25,405] | 13.1GiB [13.1〜28.9] |
| 20 MP | w4a8 | 14,886MiB | 960MiB | 9.3GiB |
| 20 MP | int8 | 14,830MiB | 18,574MiB [8,836〜25,998] | 24.2GiB [14.8〜31.7] |
値の取り方は RTX 5080 のメモリの表と同じ。int8 の 16 MP と 20 MP だけ、かっこ内に全部の本の最小と最大を添えた。
w4a8 は、起動し直しても同じ値になった。作業セットは 7.9〜9.3GiB で、RTX 5080 のとき(8.1〜10.8GiB)に近い。
int8 は、3 回の起動のうち 2 回で、途中から作業セットが増えたまま戻らなくなった。1 回は 16 MP の途中(94.58 秒かかった回)から 22.3〜31.7GiB に増えた。この回に、ほかのソフトが重なった記録は無い。もう 1 回は、別のソフトが同じ GPU とメインメモリを使い始めた時間帯に 24.2GiB まで増え、そのソフトが消えたあとも戻らなかった。残る 1 回は、12.0〜14.8GiB のまま最後まで進んだ。増えたあとの生成時間は延びていない(16 MP で 63.64〜64.53 秒)。増える理由は調べていない。
表の 20 MP の int8 の値(78.62 秒、24.2GiB)は、この 2 つ目の起動のものだ。別のソフトが消えた直後の 3 本で、外す基準には当たらないので集計に入れた。この 3 本を外すと、残る 2 回の起動の中央値は 90.31 秒と 78.11 秒になる。どちらの場合も、w4a8 の 20 MP(全部の本が 67.96〜68.94 秒)より長い。
w4a8とint8はどちらを選ぶか
測った 2 枚のどちらでも、時間とメモリの面では w4a8 が同じか有利だった。この 2 枚以外のカードでは測っていない。
RTX 5080では時間がほぼ同じで、int8はメインメモリを多く使う
RTX 5080 での生成時間の中央値の差は、テキストからの生成の 4 つの大きさ、seed だけを変えた回、画像編集のどれでも 0.5 秒以内だった。15 本の幅も重なっていて、RTX 5080 については、どちらが速いとは言えない。RTX 5060 Ti では、テキストからの生成の 4 つの大きさすべてで int8 のほうが遅かった(「RTX 5060 Tiでの生成時間」)。
RTX 5080 で違いが出たのはメモリの使い方だ(表は「RTX 5080でのメモリ」)。int8 は w4a8 より、作業セットが 4.5〜5.7GiB 多かった。ファイルも 7.85GiB(8.43GB)大きい。時間は RTX 5080 で変わらず、RTX 5060 Ti ではテキストからの生成で w4a8 のほうが短かった。
時間とメモリで見たこの判断に、画像の質は入っていない。次の項のとおり 2 つの本体の画像は一致せず、どちらが量子化する前の本体(bf16)の出力に近いかは測っていない。作例と、目で見た範囲の確認(16 MP の 5 枚ずつでは、崩れた手や顔のような破綻は w4a8 にも int8 にも無かった)は「生成した画像」に載せた。
同じseedでも画像は一致しなかった
RTX 5080 で、同じプロンプトと seed の w4a8 と int8 の出力を比べると、PSNR(値が大きいほど 2 枚が近い)は 11.7〜31.8dB(31 組、中央値 16.7dB)だった。RTX 5060 Ti でも 11.7〜28.0dB(31 組、中央値 16.8dB)で、どちらのカードでも同じ画像にはならなかった。目で見た範囲では、構図や被写体は近く、小物の形や位置がちがう。
PSNR は 2 枚の画像がどれだけ近いかを dB で表す指標で、値が大きいほど近く、画素が完全に一致すると無限大になる。画像の良し悪しを表すものではない。bf16 の本体(Comfy-Org の pruned のものも、公式の重みも)では生成していないので、w4a8 と int8 のどちらが量子化する前の出力に近いかは分からない。
同じカードと同じ本体なら、ComfyUI を起動し直しても出力はほぼ再現した。RTX 5080 では、同じ seed の 31 枚のうち、w4a8 は 24 枚、int8 は 22 枚で画素が完全に一致し、残りも PSNR は 63.8dB 以上だった。RTX 5060 Ti では、w4a8 も int8 も 31 枚すべてが一致した。
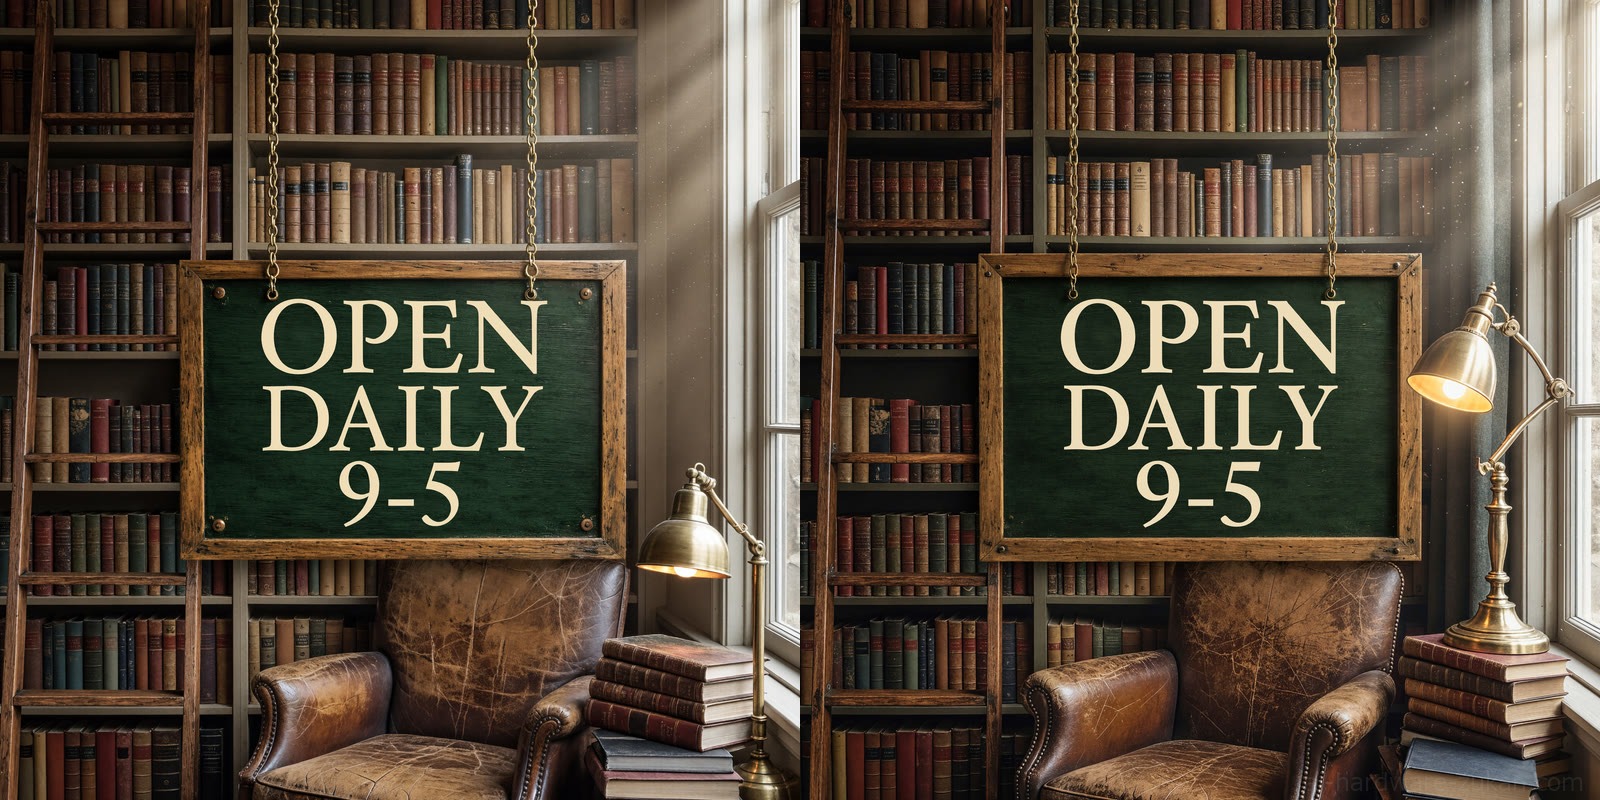
カードを替えると、同じファイル、同じプロンプト、同じ seed でも画像は一致しなかった。RTX 5080 と RTX 5060 Ti の出力を、それぞれ 1 回の起動どうしで比べた PSNR は、w4a8 が 12.8〜35.8dB(31 組、中央値 20.9dB)、int8 が 15.1〜40.2dB(中央値 21.4dB)だった。同じカードで起動し直したとき(一致しなかった組でも 63.8dB 以上)より値がはっきり低く、2 枚のちがいはカードを替えたときのほうが大きい。書店の 16 MP の 1 組(w4a8)を目で比べると、構図と被写体、看板の文字は同じで、本の背の並びやランプの形がちがう。この 2 枚の間では、seed を同じにしても同じ画像にはならなかった。カードによって出力が変わる理由は調べていない。
VRAMとメインメモリの使われ方
GPUの使用量は、大きさを変えてもほぼ横並びだった
RTX 5080 の GPU の使用量のピークは、どの条件でも 15,265〜15,707MiB(14.9〜15.3GiB)だった。4 MP でも 20 MP でも、w4a8 でも int8 でも、ほぼ同じ量になる。この値はカード全体の使用量で、H3-Image を動かすのに要る VRAM の最小量を表すものではない。RTX 5060 Ti でも、int8 の 1 回の起動の 6 本を除いて、大きさや本体を変えても増えなかった(「RTX 5060 Tiでのメモリ」)。
RTX 5080 で、4 MP、16 MP、20 MP の順に値が上がったのは、メインメモリの作業セットと共有 GPU メモリのほうだ(「RTX 5080でのメモリ」の表)。w4a8 では、4 MP から 20 MP で作業セットが 8.1GiB から 10.8GiB に、共有 GPU メモリが 351MiB から 2,438MiB に増えた(int8 は 12.6GiB から 16.1GiB、7,343MiB から 10,100MiB)。ただし、この上がり方には、大きさによる分と、測った順番による分が混ざっている。1 回の起動のなかで 4 MP から順に測っていて、16 MP と 20 MP のあいだには画像編集が入る。前の条件で増えた分は、次の条件に残りうる。int8 の 20 MP を読み込みの直後に測った 1 回の起動(測り直しの回)では、作業セットが 13.8GiB、共有 GPU メモリが 8,103MiB で、順番どおりに測った 2 回の起動(16.1〜16.2GiB、10,100〜10,291MiB)より低かった。VRAM に載りきらなくなった分がそちらへ移ったのかは確かめていない。
計測に使った ComfyUI では、DynamicVRAM(VRAM の空きに合わせて、モデルの重みを VRAM に載せる量を動的に決める ComfyUI の仕組み)が有効だった。有効にするための起動オプションは付けていない。起動ログに「DynamicVRAM support detected and enabled」の行が出るので、自分の環境でも同じ行で確かめられる。モデルを読み込む行は「dynamic VRAM loading」と表示され、本体のファイルをまるごと VRAM に載せる動きではなかった。dynamic VRAM を有効にする、無効にする起動オプションと、--reserve-vram の実測は「ComfyUIの起動オプション実測ガイド|dynamic VRAM時代のVRAM設定」で扱っている。
この記事のほかの計測は、起動オプションで VRAM を 1.5GiB(1,536MiB)空けておく指定(--reserve-vram 1.5)を付けて行った。この指定を外した場合も、RTX 5080 で、1 回の起動で 4 MP と 16 MP を測った。指定がないときに空けておく量は、ComfyUI のソース(comfy/model_management.py)では、Windows で VRAM が 15GiB を超えるカード(今回のカードはどちらもこれに当たる)で 700MiB になる。ただし、今回の計測で有効だった DynamicVRAM の側(ComfyUI が使う comfy-aimdo というライブラリ)には別の既定値(0.6.0 のソースで 256MiB)があり、指定なしの起動で実際に空いていた量は確かめていない。4 MP は w4a8 が 8.85 秒、int8 が 8.96 秒、16 MP は 27.94 秒と 28.04 秒で、指定ありの 15 本の幅の中に入った。
共有GPUメモリが増えても、VRAMからあふれたとは限らない
Windows のタスクマネージャーに出る「共有 GPU メモリ」は、VRAM に載りきらない分がメインメモリへ逃げた量として読まれることが多い。RTX 5080 の int8 の本体では、この値のピークが、4 MP から 20 MP の条件で 7,343〜10,100MiB になった(w4a8 は 351〜2,438MiB)。
ただし、このカウンタは別の理由でも増える。同じ PC の RTX 5080 で、PyTorch から次の 2 つを試した(RTX 5060 Ti では試していない)。
- ピン留めしたホストメモリ(GPU への転送を速くするために固定したメインメモリ)を 3GiB 確保すると、共有 GPU メモリが 155MiB から 4,251MiB に増え、専用 GPU メモリ(VRAM の使用量にあたる値)は 1,821MiB から 1,832MiB でほとんど変わらなかった。共有 GPU メモリの増えた量は 4,096MiB(4GiB)で、確保した 3GiB より大きい
- GPU の上に 3GiB のテンソルを置くと、専用 GPU メモリが 1,830MiB から 4,885MiB に増え、共有 GPU メモリは変わらなかった
計測に使った ComfyUI は、起動ログにピン留めメモリが有効と出ていた。共有 GPU メモリの値には、ピン留めした分が入りうる。生成中に実際にどれだけピン留めされていたかは測っていない。カウンタの値をそのまま「あふれた量」とは読めず、int8 でこの値が大きい理由も、この計測からは特定できない。
時間で見ると、RTX 5080 では、int8 の本体(19.54GiB)は VRAM より大きいのに、w4a8 より遅くならなかった。RTX 5060 Ti では int8 のほうが遅かったが、16 MP の共有 GPU メモリは 7,364MiB で、RTX 5080 のとき(8,285MiB)より多くはなかった。RTX 5060 Ti の int8 でこの値が約 25,000MiB に増えた起動でも、増えたあとの時間は延びなかった。このカウンタの大きさだけでは、時間が延びるかどうかは分からない。
メインメモリが少ないとき
メインメモリが 32GB や 64GB の PC での動作は、この記事では確かめていない。計測に使った PC はメインメモリが 96GB で、各起動の直前の空きは 72〜76GiB、RTX 5080 での H3-Image の生成中の空きの最小は条件ごとの中央値で 56〜64GiB だった。手がかりになる値を挙げる。
- ComfyUI のプロセスのコミット量(確保を約束されたメモリの量)のピークは、RTX 5080 での条件ごとの中央値で、w4a8 が 22.1〜24.5GiB、int8 が 27.4〜30.8GiB だった。RTX 5060 Ti の int8 では、作業セットが 31.7GiB、コミット量が 46.9GiB まで増えた回があった。作業セットもコミット量も、PC に要るメインメモリの量そのものではない
- 計測の途中で、別のソフトがメインメモリを使い始め、空きが 5.1〜9.5GiB まで減った時間帯があった。その間の 20 MP の生成は 36.8〜41.2 秒かかったが、失敗はしなかった。偶然重なっただけで、メインメモリの少ない PC を再現した計測ではない。w4a8 の回は PC 全体の CPU 使用率が高かった起動とも重なっていて、時間が延びた原因は分けられない。この時間帯の値は、ここまでの表に入れていない
- RTX 5060 Ti の計測中にも、別のソフトが同じ GPU とメインメモリを使い始めた時間帯が 1 度あり、空きが 1.0GiB まで減った。重なった int8 の画像編集の 1 本は 119.14 秒かかったが、失敗はしなかった。これも偶然重なった回で、表には入れていない
作業セットとコミット量は、測ったどの条件でも w4a8 のほうが小さかった。メインメモリに余裕が無い PC で試すなら、w4a8 からにする。
画像編集(参照1枚)の時間と結果
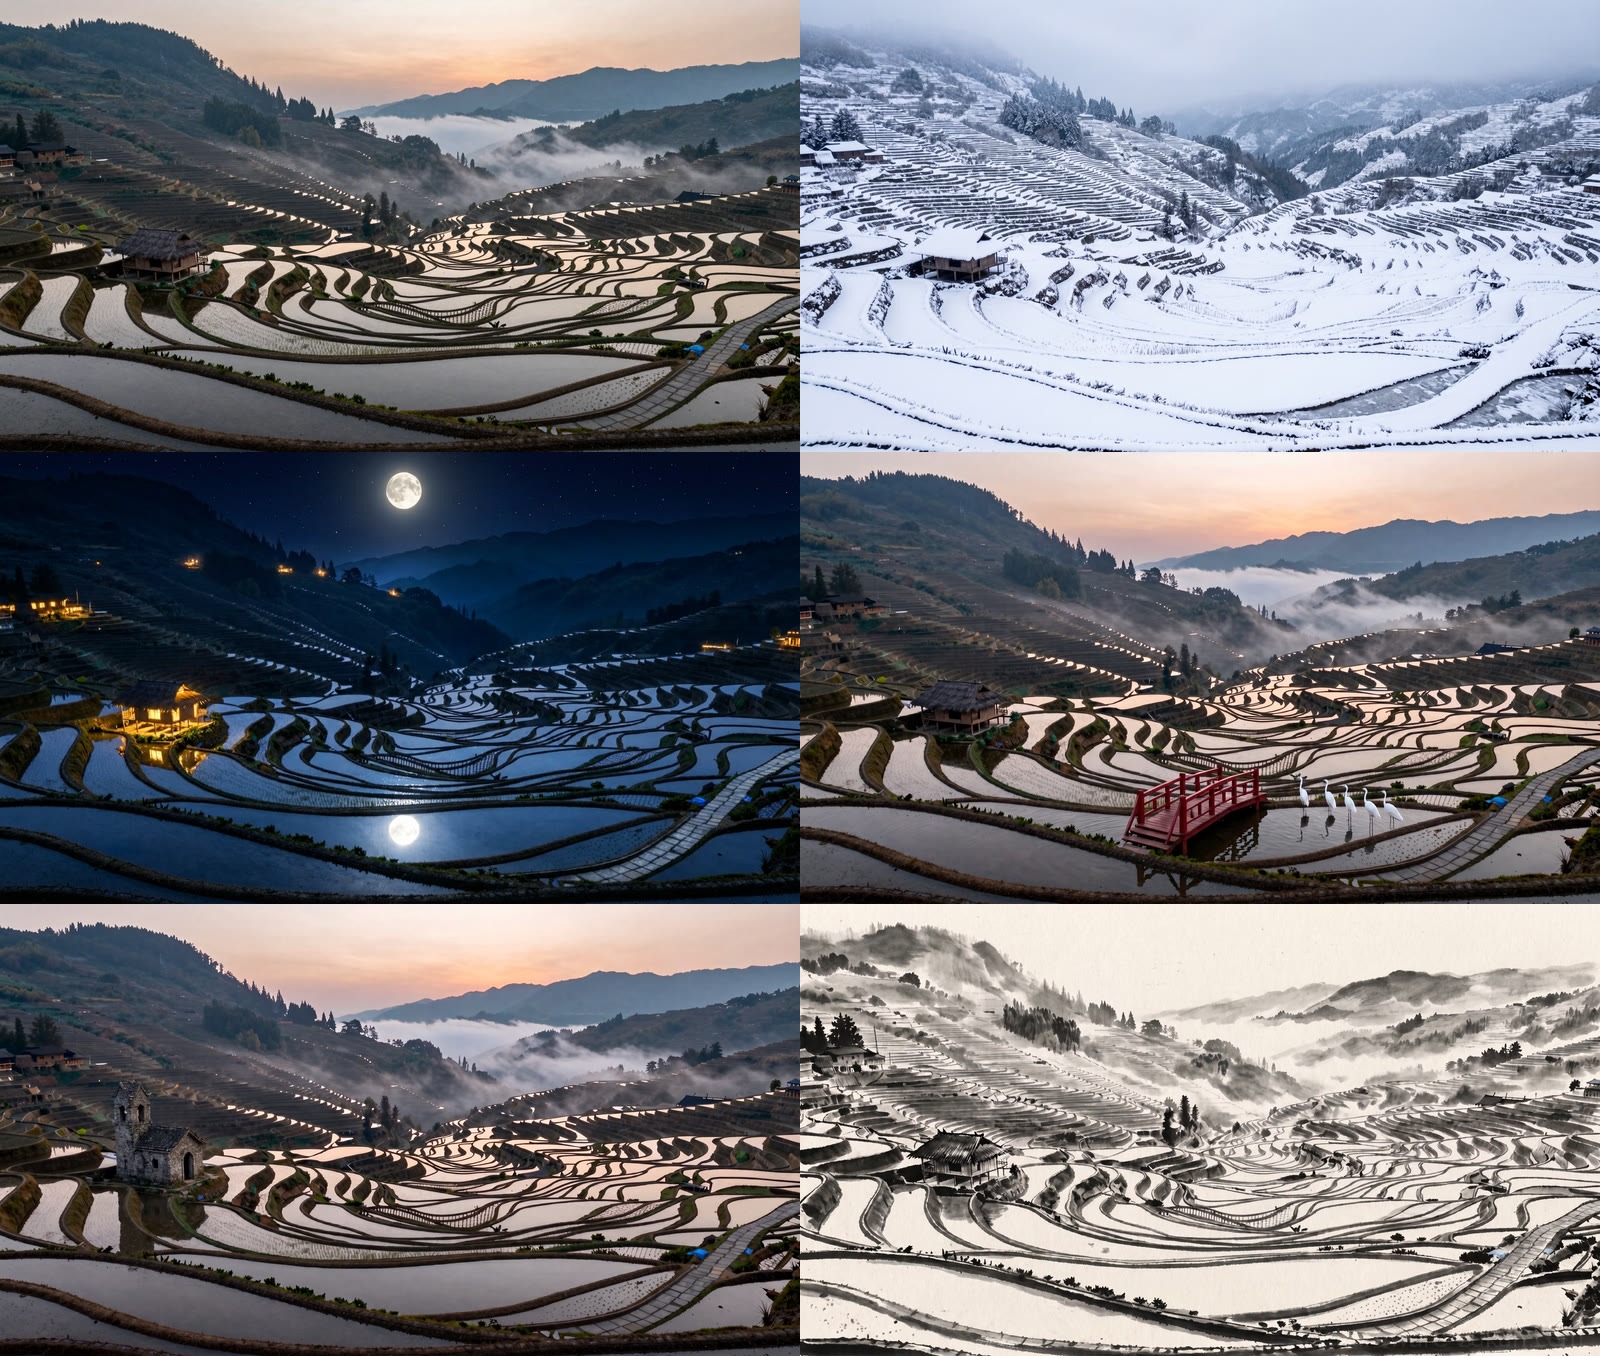
画像編集は、1536×864 の風景の画像を 1 枚参照にして、5 つの指示で試した。テンプレートは参照画像を約 4 MP に拡大してから渡すので、出力は 2720×1536 になった。
RTX 5080 での時間は w4a8 が 20.36 秒 [19.62〜21.96]、int8 が 20.81 秒 [20.39〜21.60] だった(3 起動 × 5 本、指示は毎回変えた)。同じ約 4 MP でも、テキストからの生成の 2 倍あまりかかる。サンプリングの経過も 10〜12 秒で、テキストからの生成の 3〜4 秒より長かった。RTX 5060 Ti では w4a8 が 45.03 秒 [44.79〜46.29]、int8 が 47.28 秒 [46.16〜54.07] で、こちらはテキストからの生成(4 MP)の約 3 倍になった。
RTX 5080 でのメモリは、w4a8 で作業セット 10.3GiB・共有 GPU メモリ 2,346MiB、int8 で 15.8GiB・10,071MiB と、同じ大きさのテキストからの生成より多かった。画像編集は 16 MP のあとに測っているので、この差には、測った順番による分も入りうる。GPU の使用量は 15,441〜15,452MiB で変わらない。
試した指示は、季節を雪景色に変える、月夜に変える、手前に赤い橋と鷺を足す、家を石造りの礼拝堂に置き換える、水墨画風に描き直す、の 5 つだ。w4a8 の 5 枚を目で確かめた範囲では、どれも棚田の並びと道の位置を保ったまま、指示した部分が変わっていた。
プロンプト拡張は使わず、短い指示をそのまま渡している。テンプレートの初期設定(拡張オン)での時間と結果は測っていない。
Z-Image-Turboと並べる
比べる目安として、同じ PC の RTX 5080 で Z-Image-Turbo(bf16)にも同じ 5 本のプロンプトを生成させた。この節の値は、すべて RTX 5080 のものだ。大きさも設定もちがうので、速さの優劣を決める比較ではない。1 枚にかかる時間の感覚をつかむための並べ方で、表の値では、H3-Image の約 4 MP は 9 秒前後、Z-Image-Turbo の約 1.3 MP は 12 秒前後、H3-Image を 16 MP にすると 28 秒前後になる。
| モデル | 大きさ | ステップ | プロンプトを変えた回 | seed だけ変えた回 |
|---|---|---|---|---|
| Z-Image-Turbo bf16 | 1536×864(約 1.3 MP) | 9 | 11.76 秒 [11.04〜12.47] | 8.29 秒 [7.95〜8.57] |
| MiniMax-H3-Image w4a8 | 2048×2048(約 4 MP) | 6 | 8.98 秒 [8.59〜9.39] | 5.30 秒 [5.11〜5.92] |
| MiniMax-H3-Image w4a8 | 4096×4096(約 16 MP) | 6 | 28.01 秒 [27.44〜30.18] | 測っていない |
Z-Image-Turbo は ComfyUI 0.31.1 と PyTorch 2.9.1+cu128、res_multistep / simple、CFG 1.0 で、テキストエンコーダーを CPU で動かす設定(2 起動 × 5 本)。H3-Image は生成時間の表と同じ条件。
この並べ方では、ComfyUI のバージョンも、テキストエンコーダーを動かす場所もそろっていない。Z-Image-Turbo を H3-Image と同じ ComfyUI 0.45.0 で動かすと、プロンプトを変えた回は 11.38 秒、seed だけ変えた回は 7.24 秒だった(1 起動 × 5 本。テキストエンコーダーは同じく CPU)。
Z-Image-Turbo の本体の選び方は「Z-Image-TurboをVRAM 16GBで動かす|nvfp4・int8・bf16はどれを選ぶか、生成時間と画像の違いをRTX 5080・5060 Tiで比較」で扱っている。
生成した画像
計測で出た画像の一部を載せる。どれも AI(MiniMax-H3-Image)が生成した画像で、RTX 5080 で、w4a8 の本体、4096×4096(約 16 MP)、6 ステップ、プロンプト拡張なしで出力した。最後の画像(縮小せずに切り出した一部)を除いて、幅 1600 ピクセルに縮小している。プロンプトは英語で書いていて、説明はその要旨になる。
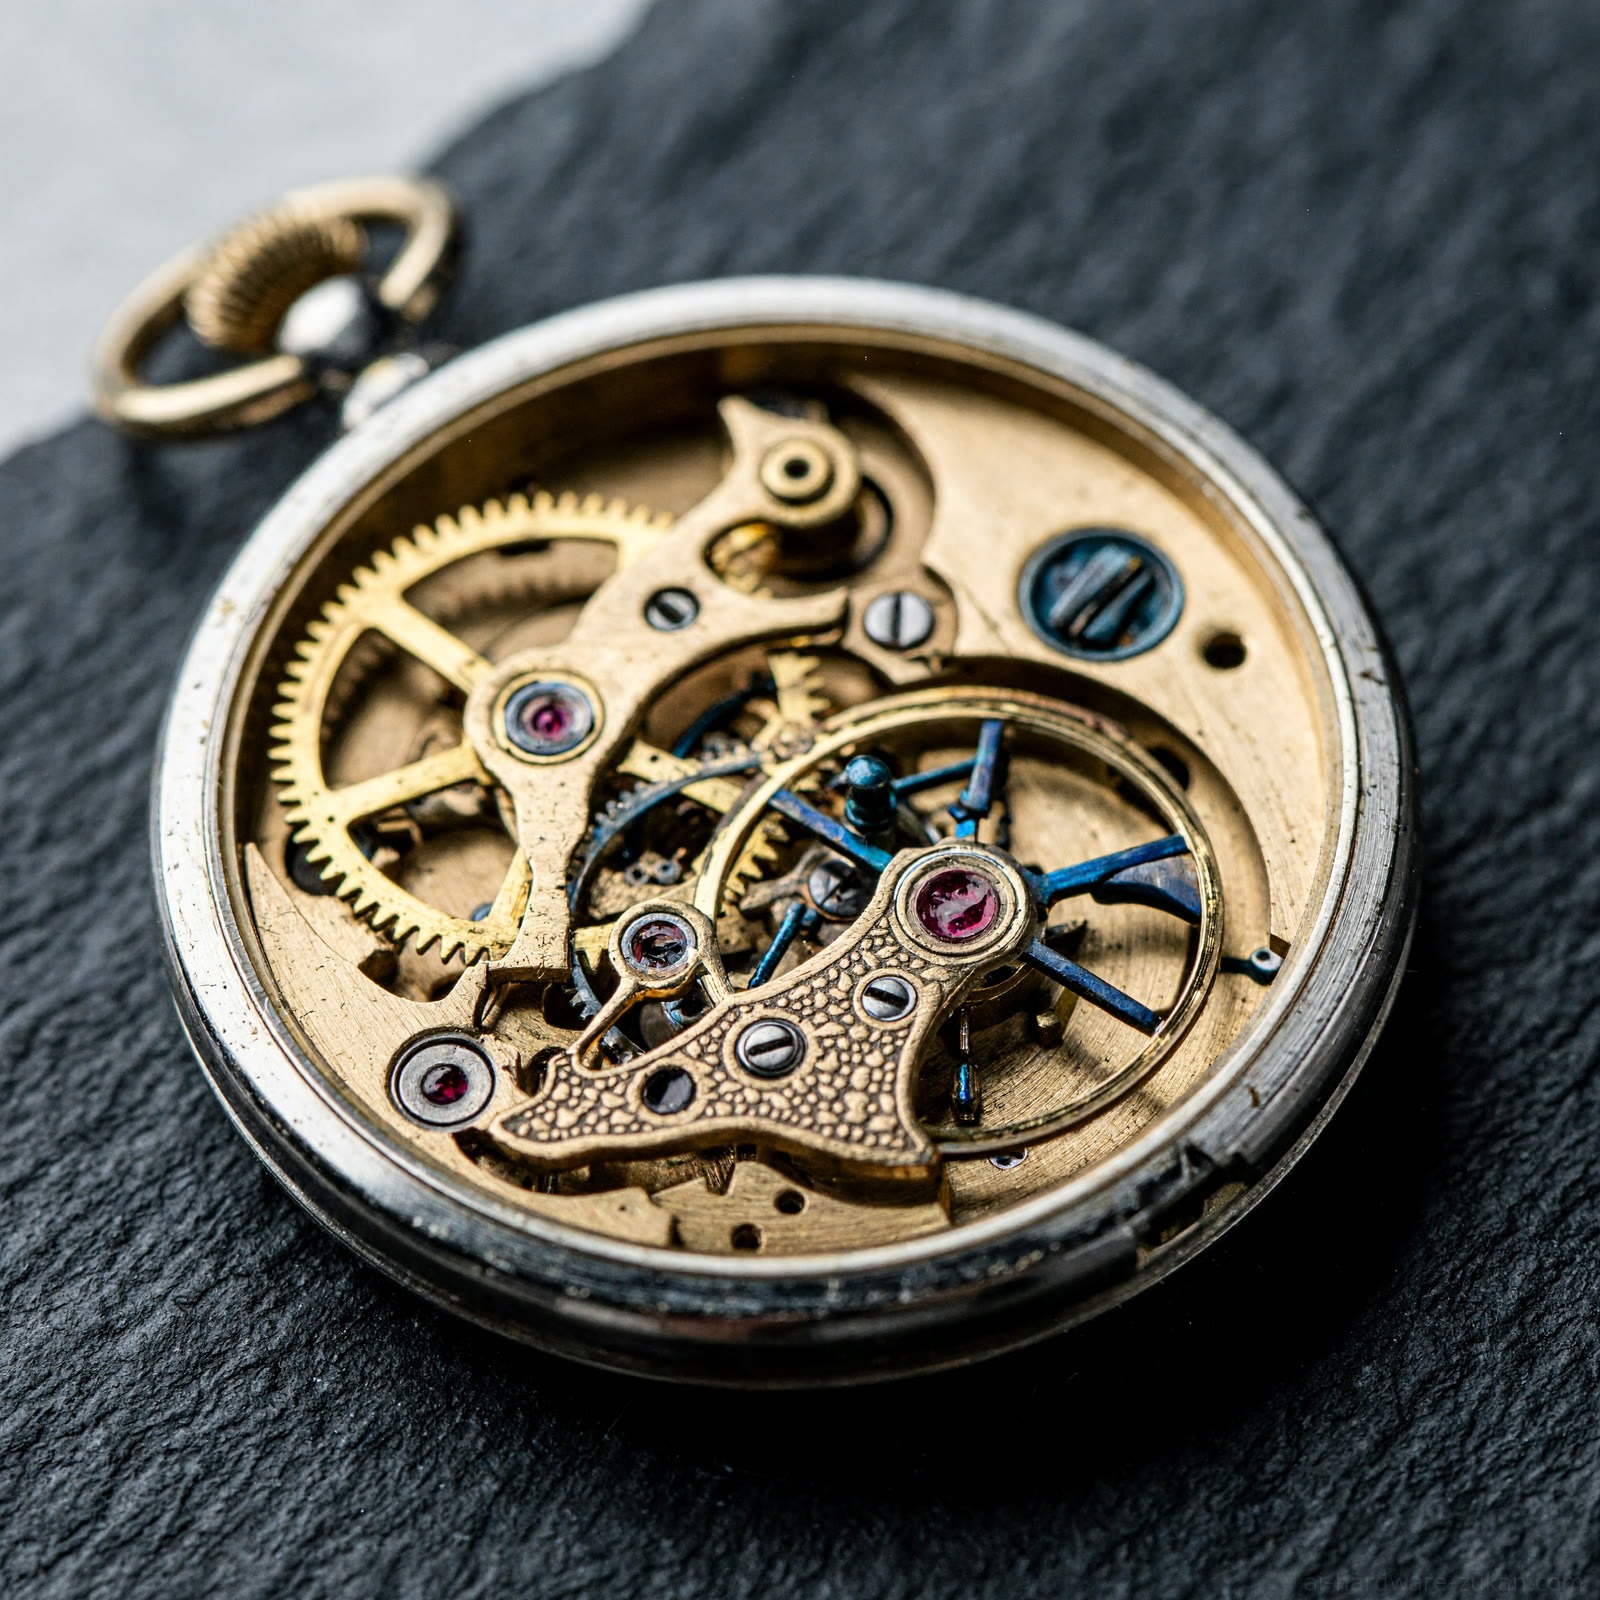
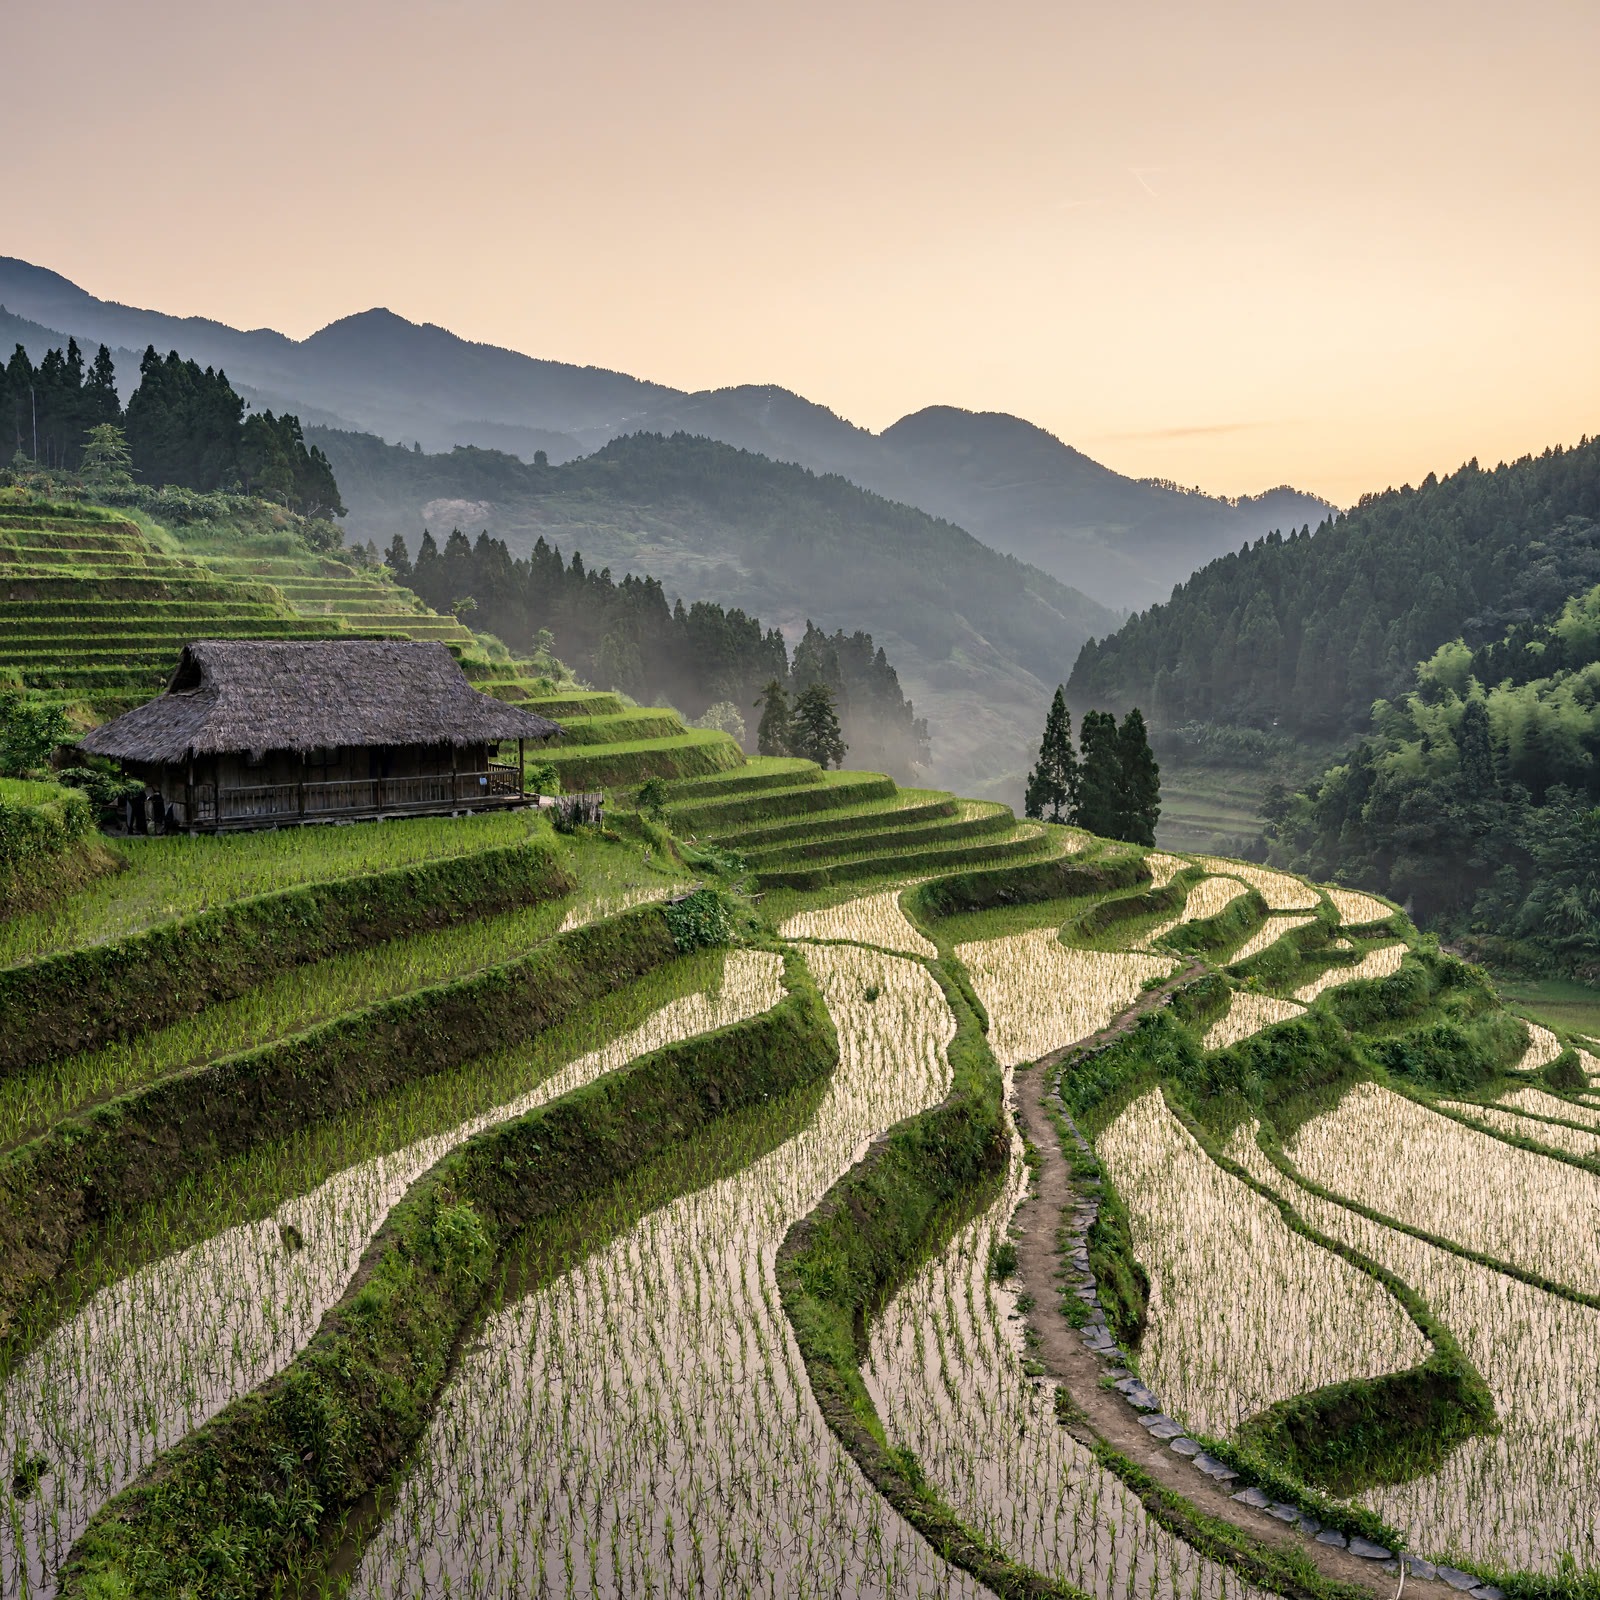
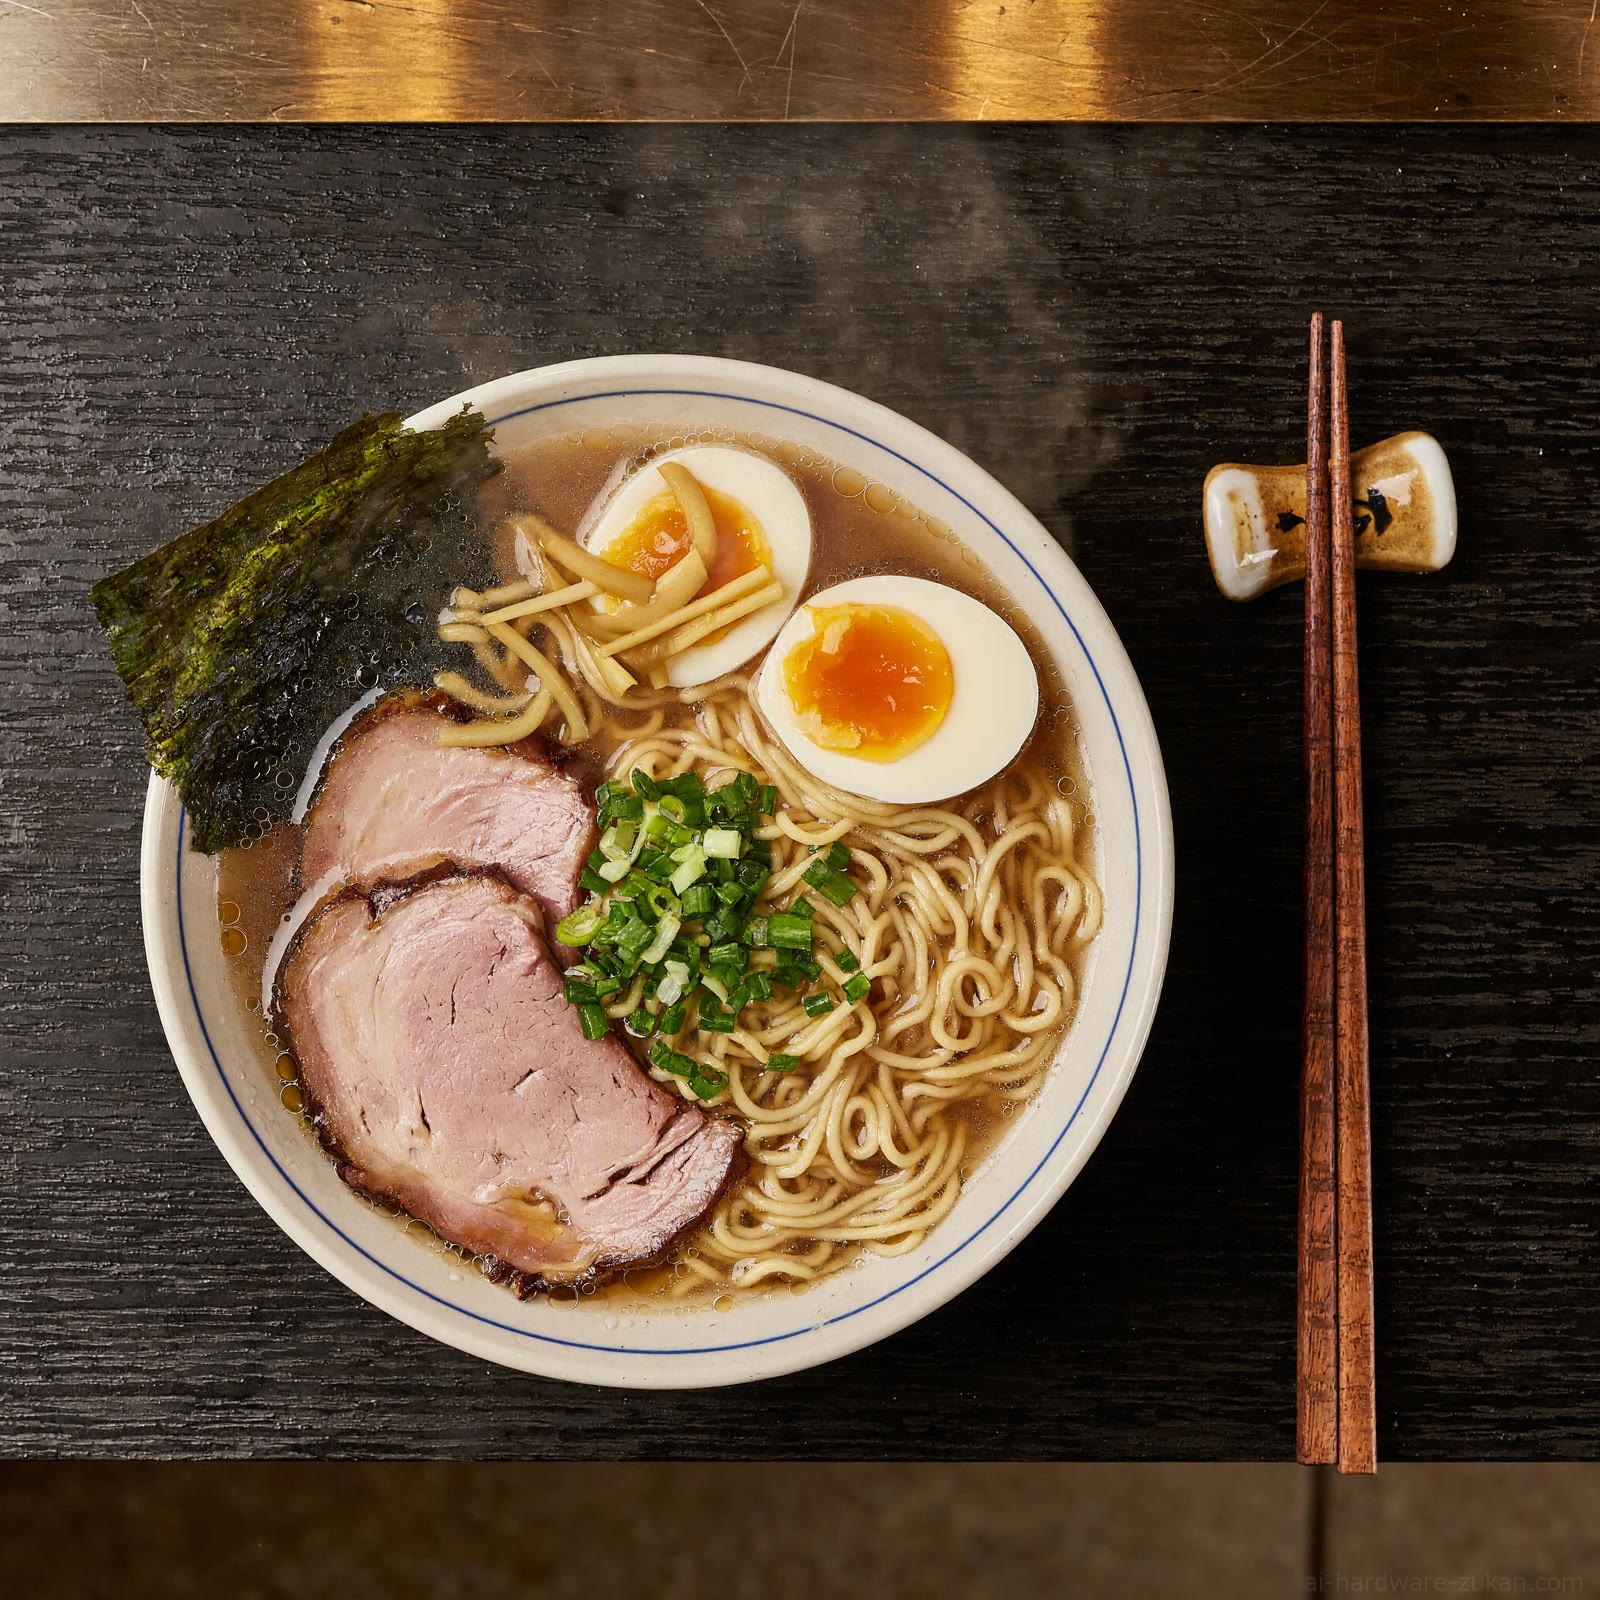
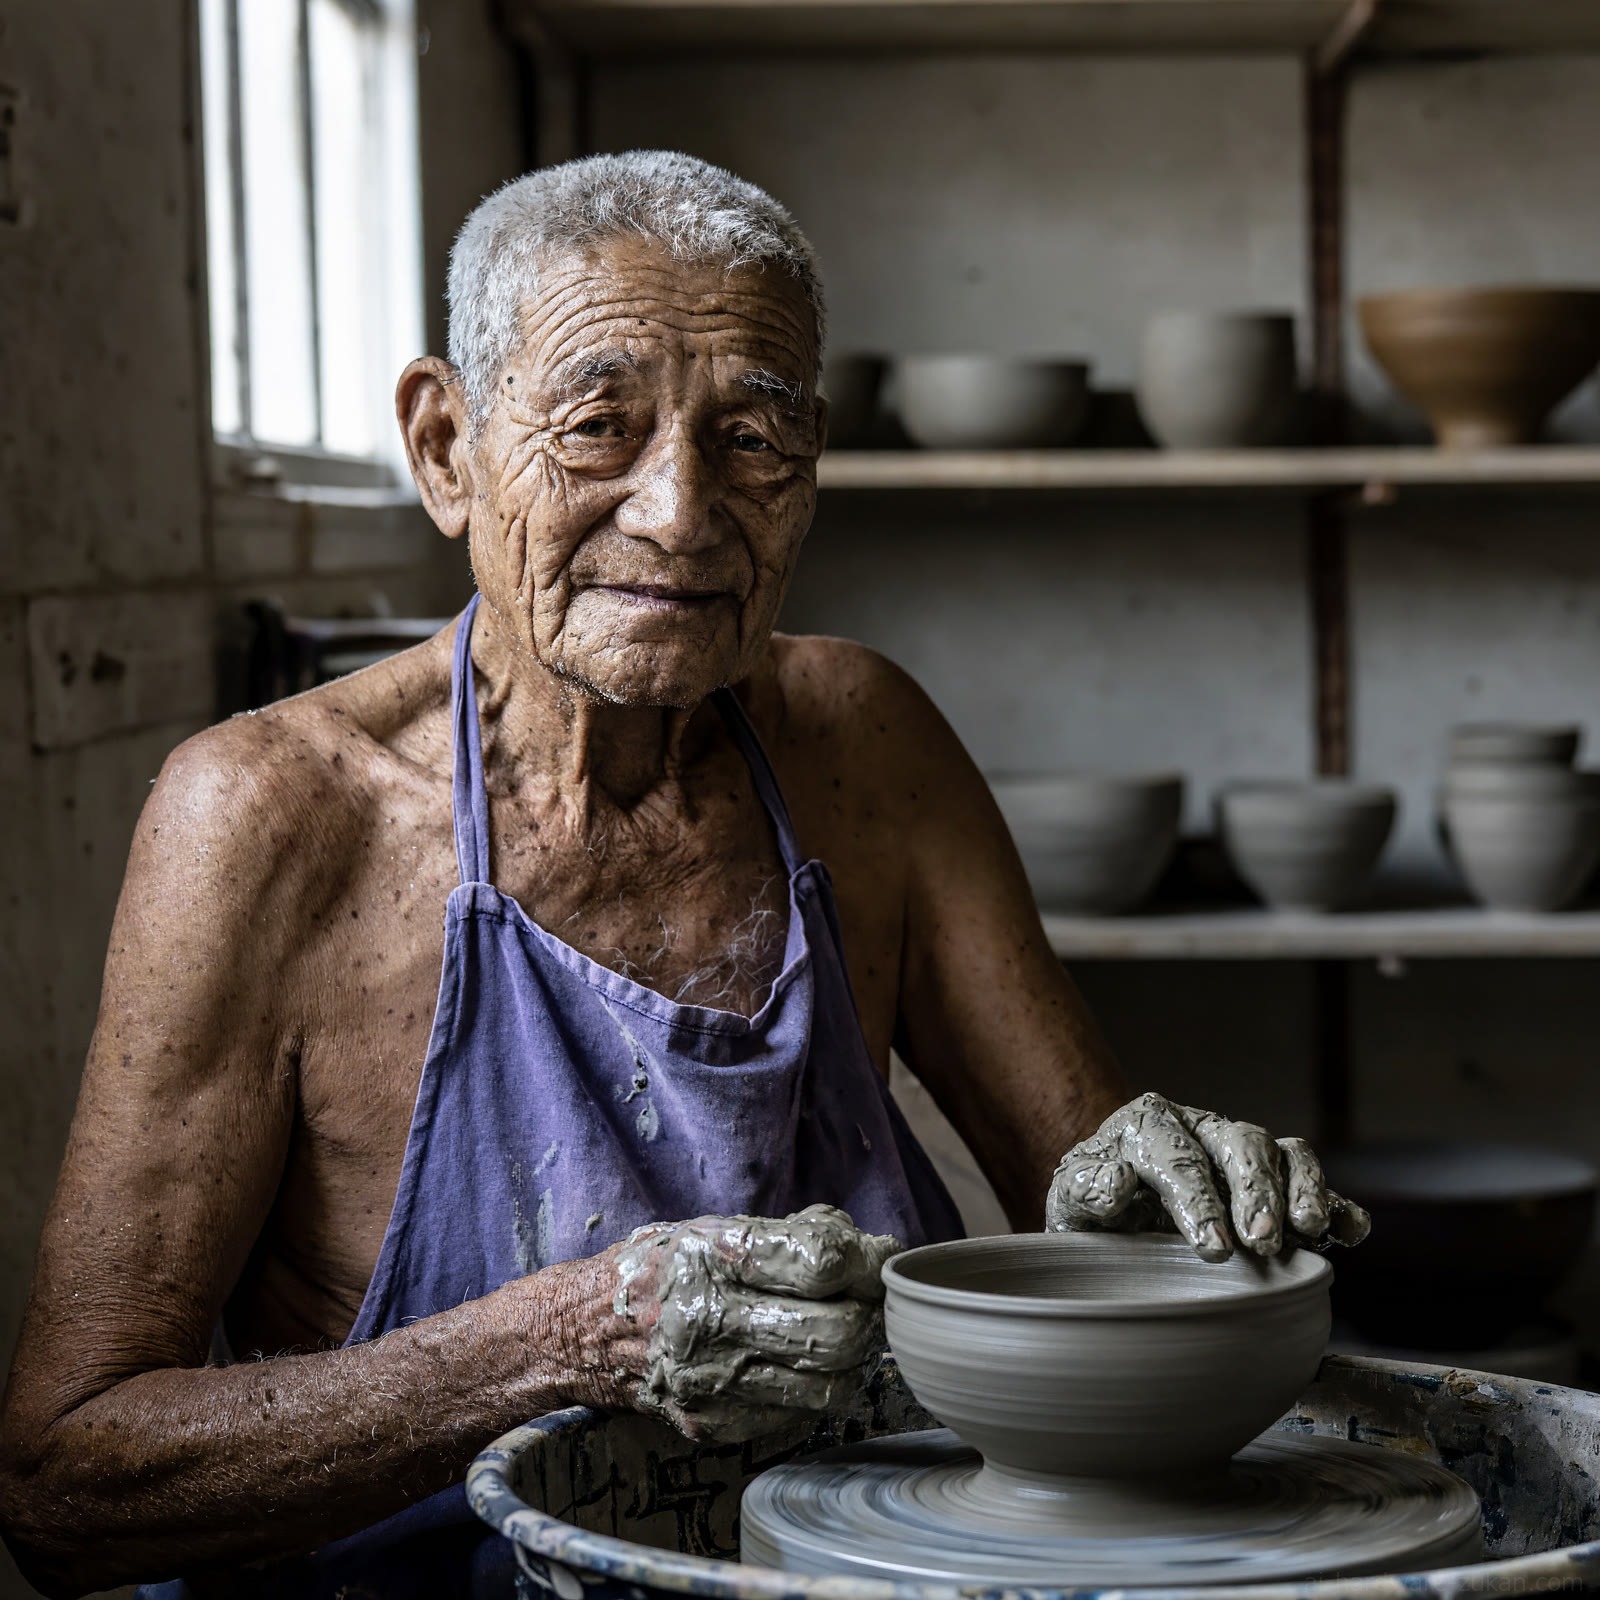
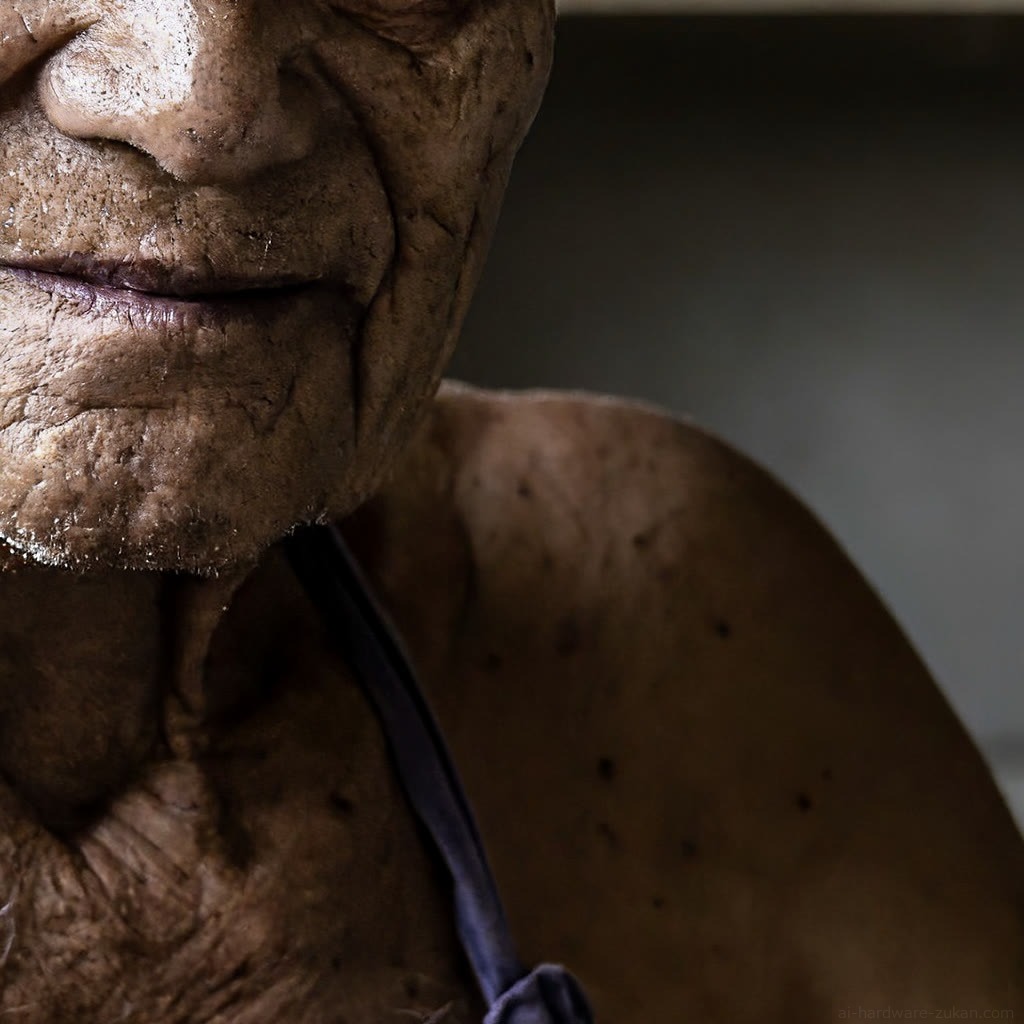
目で確かめたのは、RTX 5080 で生成した w4a8 と int8 の 16 MP の 5 枚ずつと、w4a8 の編集の 5 枚で、縮小した全体と、一部の等倍の切り出しを見た。RTX 5060 Ti で生成した画像は、書店の 1 枚を RTX 5080 のものと並べて見ただけだ。
- 破綻した画像(崩れた手や顔、意味の通らない物体)は、見た範囲には無かった
- 看板のある書店(緑の板に、クリーム色のセリフ体で「OPEN DAILY 9-5」と書いた木の看板が、真ちゅうの鎖で下がっている): w4a8 と int8 のどちらも、指定した文字が 3 行で正しく出た。Z-Image-Turbo も同じ文字を正しく出した
- 懐中時計の機構: 指定した歯車、青いねじ、赤い石の軸受け、彫りのある受けが描き分けられていた。機構として正しいかは見ていない
- 年配の陶芸家: 等倍で見ると顔のしわや肌のきめが描かれていた。エプロンの下に着る服は指定していない。w4a8 と int8 の 2 枚は上半身に直接エプロンを着けた姿になり、Z-Image-Turbo の 1 枚はシャツの上にエプロンを着けていた
これは計測で出た画像を確かめた記録で、画質をほかのモデルと比べた評価ではない。
測っていないこと
- bf16 の本体(Comfy-Org の pruned のものと、公式の重み)、int8 のテキストエンコーダー、プロンプト拡張(Qwen3.5 9B と公式の MiniMax-H3-Image-PE)を使った場合
- ComfyUI のテンプレートをそのまま開いて実行した場合
- 画像の質の評価。画質を測る指標での比較も、人が並べて選ぶ比較もしていない(PSNR は 2 枚の差を見るために使っただけで、質の評価ではない)
- 16:9 などの縦横比でのテキストからの生成(テキストからの生成はすべて正方形)、4 MP 未満、20 MP を超える大きさ
- 参照画像が 2 枚以上の編集
- RTX 5080 と RTX 5060 Ti 以外の GPU、VRAM が 16GB 未満のカード
- RTX 5060 Ti をマザーボードの PCIe スロットに直接挿した場合と、画面をつないだ場合(計測は OCuLink 接続で、PCIe 4.0 の 4 レーン、画面なし)
- RTX 5060 Ti で int8 が遅くなる理由と、int8 の数本だけが長くなる理由
- RTX 5060 Ti の int8 で、作業セットが途中から増える条件と理由
- RTX 5060 Ti での
--reserve-vramを外した場合と、Z-Image-Turbo - メインメモリが 96GB より少ない PC
- ディスクから初めて読み込むときの時間(OS のファイルキャッシュを消していない)
- NVMe SSD 以外のディスクにモデルを置いた場合
- 時間の内訳(テキストエンコーダー、モデルの入れ替え、VAE のデコード)
- カスタムノードを入れた ComfyUI や、生成中のプレビューを出す設定での時間
検証環境と測り方
- PC: Intel Core i7-14700F、メインメモリ 96GB、Windows 11(10.0.26200)、NVIDIA ドライバ 610.88。モデルのファイルは NVMe SSD に置いた
- GPU: RTX 5080(VRAM 16GB、16,303MiB)と RTX 5060 Ti(VRAM 16GB、16,311MiB)。同じ PC に付いていて、1 枚ずつ使って測った。RTX 5080 は画面をつないでいるカードで、接続は PCIe 5.0 の 16 レーン、各起動の直前の空き VRAM は 14,446〜15,355MiB だった。RTX 5060 Ti は OCuLink でつないでいて、接続は PCIe 4.0 の 4 レーン(nvidia-smi の表示)、画面はつないでおらず、各起動の直前の空き VRAM は 16,050MiB だった
- ソフトのバージョン: ComfyUI 0.45.0、Python 3.11.9、PyTorch 2.14.1+cu130、comfy-kitchen 0.2.41、comfy-aimdo 0.6.0。Z-Image-Turbo の基準だけ ComfyUI 0.31.1 と PyTorch 2.9.1+cu128。ComfyUI は v0.45.0 のタグのソースを取得し、専用の Python 仮想環境に依存パッケージを入れた。GitHub の Releases で配られているポータブル一式では測っておらず、それに入っている PyTorch で同じ時間になるかは分からない。PyTorch の公式の最新リリースは、2026 年 11 月 11 日の時点で 2.15.0 だが、2.15.0 では測っていない
- ComfyUI 0.45.0 の起動ログに出ていた設定: DynamicVRAM が有効、モデルの読み込み方は fast_disk=True(起動オプションでは指定していない)、ピン留めメモリの上限は 39,229MiB(メインメモリ 98,075MiB の約 4 割。ログの表示は MB)
- 起動オプション:
--cuda-device 0(使う GPU の番号。RTX 5060 Ti の回は 1)、--reserve-vram 1.5(OS やほかのソフトのために空けておく VRAM。単位は GiB で、1.5 は 1,536MiB)、--preview-method none(生成中のプレビューを出さない)、--disable-all-custom-nodes(カスタムノードを読み込まない)、--disable-api-nodes、--disable-auto-launch(ブラウザーを自動で開かない)。--disable-api-nodesは、0.45.0 では--offlineと同じ動作の古い名前だと起動時に表示された - モデル: 本体は w4a8(12.55GB)と int8(20.98GB)、テキストエンコーダーは nvfp4(15.69GB)、VAE は fp16(1.17GB)。Comfy-Org/MiniMax-H3-Image から取得し、配布元のハッシュと一致することを確かめた
- 生成の設定: euler、simple、6 ステップ、CFG 1.0、denoise 1.0。プロンプト拡張のノードは外した。プロンプトは英語の詳しい説明文 5 本(懐中時計の機構、棚田の風景、看板のある書店、ラーメン、陶芸家)。seed は生成 1 本ごとに決めた値で、起動し直しても、本体を替えても同じ値を使った
- 測り方: ComfyUI の API にグラフを 1 件ずつ送り、ComfyUI の実行履歴に残る開始と終了の時刻の差を時間とした。メモリの使用量(GPU の使用量、共有 GPU メモリ、メインメモリ)は、約 1 秒間隔で取った
- 試行回数: 本体ごとに ComfyUI を 3 回起動し直し、1 回の起動のなかで、読み込みを含む最初の 1 本のあと、4 MP、同じ大きさで seed だけを変えた回、8 MP、16 MP、画像編集、20 MP の順に 5 本ずつ続けて生成した。条件の間で、ComfyUI の再起動も、モデルをメモリから外す操作もしていないので、あとの条件の時間とメモリには、前の条件から残った状態の影響が入りうる。表の値は起動ごとの中央値 3 つの中央値で、かっこ内は 15 本の最小と最大。RTX 5060 Ti も同じ手順で、w4a8 と int8 を交互に 3 回ずつ起動した。測り直しのために追加した起動には、この順番の一部だけを生成したものがある(下の「外した回」と「RTX 5060 Ti で外した回」)
- 起動後の最初の 1 本の扱い: モデルの読み込みを含むので、ほかの回と分けて書いた。OS のファイルキャッシュは消していない
- 外した回: w4a8 の最初の起動(31 本)は、生成中の PC 全体の CPU 使用率の中央値が 62.3% で、ほかの起動(12.1〜36.9%)と離れていたので、集計から外して起動を 1 回追加した。この起動の 4 MP は 10.96 秒、16 MP は 34.52 秒だった。int8 の最初の起動の 20 MP(5 本)は、3 本が別のソフトがメインメモリを使い始めた時間と重なり、残りの 2 本だけでは集計に使える本数が足りないので、5 本とも外した。測り直しでは起動を 1 回追加し、読み込みを含む最初の 1 本のあと、20 MP の 5 本だけを生成した(4 MP から画像編集までの条件は挟んでいない)。外した回を含めて、RTX 5080 で生成した 278 本(H3-Image が 245 本、比較用の Z-Image-Turbo が 33 本。手順を確かめるための試しの生成 9 本は数に入れていない)に失敗は無かった
- RTX 5060 Ti で外した回: 外す基準は、もう 1 枚の GPU(RTX 5080)の使用量が 4,000MiB を超えた本と、別のソフト(ローカル LLM のエンジン)のプロセスが動いていた本。基準に届かない重なり(RTX 5080 の使用量が最大 3,658MiB)は集計に入れた。w4a8 は 12 本を外した。RTX 5080 で別の生成が動いていた時間と重なったのが 10 本(4 MP の 5 本、seed だけを変えた回の 2 本、8 MP の 3 本)で、8 MP の残りの 2 本は本数が足りないので一緒に外した。int8 の 7 本(画像編集の 5 本、20 MP の 2 本)は、計測中の RTX 5060 Ti に別のソフトが読み込まれた時間と重なった。足りなくなった条件は、起動を 1 回ずつ追加して測り直した。w4a8 の追加の起動では、最初の 1 本のあと、4 MP・seed だけを変えた回・8 MP を元の順番で生成した。int8 の追加の起動では、最初の 1 本のあと、画像編集の 5 本だけを生成した(16 MP のあとではなく、読み込みの直後になる)。集計に使った本数は、w4a8 の seed だけを変えた回が 18 本(4 起動)、int8 の 20 MP が 13 本(3 起動)、ほかは 15 本(3 起動)。int8 の 20 MP のうち 3 本は、別のソフトが消えた直後の値で、外す基準には当たらないので集計に入れてある。外した回を含めて、RTX 5060 Ti で生成した 208 本に失敗は無かった
- ばらつき: 起動ごとの中央値は、w4a8 の 4 MP で 9.24・8.98・8.73 秒、int8 の 4 MP で 8.68・8.67・8.74 秒、w4a8 の 16 MP で 29.37・28.01・27.61 秒、int8 の 16 MP で 27.91・27.84・28.06 秒だった。RTX 5060 Ti は、w4a8 の 4 MP で 14.81・15.01・15.41 秒、16 MP で 54.75・55.61・56.05 秒、int8 の 4 MP で 15.81・16.15・16.57 秒、16 MP で 64.91・65.02・64.53 秒、20 MP で 90.31・78.62・78.11 秒だった
計測した数値(生成時間、メモリの使用量、PSNR、画素が一致した枚数)は、すべて当サイトの実測(上の環境、2026年11月11日)。モデルの仕様、ファイルの大きさ、ライセンスの条件、ComfyUI のバージョンの条件は、参考資料の公式ページから引いた。
まとめ
MiniMax-H3-Image は、ComfyUI 0.45.0 と量子化済みのファイルを使うと、メインメモリ 96GB の PC で、VRAM 16GB の RTX 5080 でも RTX 5060 Ti でも、正方形の 20 MP まで生成できた。ネイティブとされる 16 MP は、プロンプトを変えるたびに、中央値で RTX 5080 が 28 秒前後、RTX 5060 Ti(OCuLink 接続、PCIe 4.0 の 4 レーン)が w4a8 で 56 秒前後かかった。接続のちがいの影響は分けていない。
本体は w4a8 から試す。RTX 5080 では int8 との時間の中央値の差が 0.5 秒以内で、この PC の RTX 5060 Ti(OCuLink 接続)では int8 のほうが 16 MP で 9.30 秒長く、ばらつきも大きかった。ダウンロードとメインメモリの負担も w4a8 のほうが小さい。画像の質は測っていないので、質でどちらが良いかは決められない。2 つの画像は同じ seed でも一致しないので、気になるときは同じプロンプトで両方の本体から何枚か作って見比べる。
使う前に、ライセンスの地域の条件を確かめる。モデルを動かす場所だけでなく、生成した画像を使う場所と見せる場所にも条件がかかる。