ベンチマーク

LLM量子化・軽量化

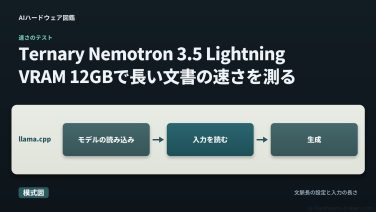
Ternary Nemotron 3.5 LightningをVRAM 12GBで動かす|長い文書でも速さは保てるか

RTX 4070 SUPER(VRAM 12GB)1枚でTernary Nemotron 3.5 Lightningを実測。文脈長368,640の設定でも全層をGPUに置く指定のまま動いた。29万トークンの入力は読み込みに約2分かかり、そのあとの生成は短い入力の約3割に落ちた。
LLM量子化・軽量化

Gemma 4 26B-A4BのQATをVRAM 16GBで動かす|Ollamaとllama.cppのどちらを使うか

Ollama の qat タグ ( gemma4:26b-a4b-it-qat ) は RTX 5080 1 枚で 8K から 256K まで動いたが、この記事の Ollama の設定では、どの文脈長でも 16GB の GPU に全部は載らず、一部が CPU 側に回った。
AI動画生成

FastH3 OmniをVRAM 16GBで動かす|元のMiniMax H3のTurbo LoRAとどちらを使うか

FastH3 OmniをRTX 5080とRTX 5060 Ti(VRAM 16GB)のComfyUI v0.43.0で実測。元のMiniMax H3・Turbo LoRAとの時間、INT8・NVFP4・FP8の違い、15秒の動画や参照を足したときの時間とメモリを比べた。
AI動画生成

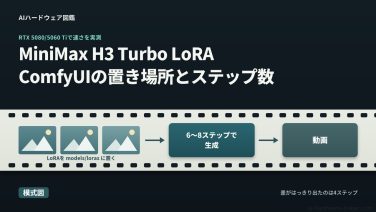
MiniMax H3 Turbo LoRA(step600 EMA)とは|ComfyUIの置き場所・推奨ステップ数と速さをRTX 5080/5060 Tiで実測

MiniMax H3のTurbo LoRA(ComfyUI変換版 v4 step600 EMA)の置き場所と推奨ステップ数を整理し、RTX 5080・5060 Tiで総時間と画質を実測。配布元の約5倍はサンプリング部分の話で、RTX 5080の総時間では条件しだいで1.47〜4.18倍。ライセンスの地域制限も確認する。