この記事の要点
メインメモリを多く積んだ測定機では、Z-Image-Turbo の画像モデル本体 (bf16 / int8_convrot / nvfp4) とテキストエンコーダ (bf16 / fp8_mixed / fp4_mixed) のどの組み合わせも RTX 5080 と RTX 5060 Ti で最後まで生成できた。ファイル合計が VRAM を超える組み合わせも ComfyUI の既定のまま動いた。メモリの少ない PC は測っていない。
速さはほぼ画像モデル本体で決まり、測った2つの GPU (RTX 50 シリーズ) では nvfp4 が最も速く、続けて出す1枚あたりは bf16 の半分以下で済んだ (高解像度では届かなかった)。テキストエンコーダによる所要時間の差は小さかった。
同じ seed では、画像モデル本体 int8_convrot+テキストエンコーダ bf16 が、両方とも bf16 の組み合わせに最も近かった。テキストエンコーダを fp8_mixed・fp4_mixed にすると離れ、nvfp4 は背景や小物まで変わった。画像の良し悪しは決めていない。
VRAM 16GBで動くか、どのファイルを選ぶか
メインメモリ96GB・Windows 11 の測定機で、配布されている画像モデル本体3種 (bf16 / int8_convrot / nvfp4) とテキストエンコーダ3種 (bf16 / fp8_mixed / fp4_mixed) の9通りは、RTX 5080 でも RTX 5060 Ti でも 1024×1024 で最後まで生成できた。測った条件は、1024×1024 が9通り×2つの GPU×プロンプトの出し方2種 (毎回書き換える / 同じプロンプトのまま seed だけ変える)、2048×2048 が3通り×2つの GPU で、合わせて42条件。1条件につき4枚ずつ、計168枚を生成し、VRAM 不足などで止まった枚は無かった。ComfyUI v0.38.0 を既定の起動 (dynamic VRAM) のまま使い、RTX 5060 Ti は OCuLink の外付け接続で測っている。
画像モデル本体もテキストエンコーダも bf16 にした組み合わせは、ファイル合計 (VAE込み) が19.27GiB で VRAM 16GB を超える。それでも RTX 5080 と RTX 5060 Ti のどちらでも、1024×1024 と 2048×2048 の両方で最後まで生成できた。ここでの「動いた」は、dynamic VRAM (モデルを必要に応じて VRAM に載せる、ComfyUI の既定の読み込み方) で動かした結果で、ファイル全体が同時に VRAM に収まったという意味ではない。載りきらなかった分がどこに置かれていたかは切り分けていない。
どのファイルを選ぶかに関わる結果は次の3点だった。
- 速さはほぼ画像モデル本体のファイルで決まった。測った2つの GPU (どちらも RTX 50 シリーズ) では速い順に
nvfp4、int8_convrot、bf16で、1024×1024 の2枚目以降の1枚あたりではnvfp4がbf16の半分以下の時間で済んだ (2048×2048 ではbf16の約0.6倍の時間で、半分以下にはならなかった。1枚目はモデルの読み込みを含むため、差は小さくなる)。 - テキストエンコーダの違いは、プロンプトを書き換えながら出すと2枚目以降の所要時間に表れたが、差は1枚あたり最大で、RTX 5080 で約0.8秒、RTX 5060 Ti で約1.4秒だった。同じプロンプトのまま seed だけ変えて続けて出すと、テキストエンコーダを変えてもほとんど差が出なかった。
- 出てくる画像は、画像モデル本体を
int8_convrotにしてテキストエンコーダをbf16のままにした組み合わせがbf16同士の組み合わせに最も近かった。nvfp4は同じ seed でも背景や小物まで変わった。どちらの画像が良いかは決めていない。
目的別に、当てはまる組み合わせと測った値を並べる。秒数は RTX 5080 でプロンプトを毎回書き換えて出したときの2枚目以降の1枚あたり、PSNR は後の節で説明する基準 (bf16 同士) からの離れ具合で、大きいほど近い。
- 画像を
bf16同士に近づけたい:int8_convrot+bf16。ファイル合計13.58GiB、3.2秒、PSNR 29.7〜35.1dB - 公式の int8 テンプレートのまま使う:
int8_convrot+fp8_mixed。11.33GiB、2.7秒、PSNR 24.4〜27.5dB - 速さとディスク容量を優先する (RTX 50 シリーズで測った値):
nvfp4+fp4_mixed。7.75GiB、2.3秒、PSNR 17.5〜20.9dB で、背景や小物まで変わる - 公式の既定のテンプレートのまま使う:
bf16+bf16。19.27GiB、6.4秒 (RTX 5060 Ti は13.2秒)
Z-Image-Turbo は、配布元の Tongyi-MAI のモデルカードによると、6B パラメータの画像生成モデルのファミリー Z-Image の蒸留版。8ステップ (モデルカードの表記は 8 NFE) で動き、16GB の VRAM の一般向け機器に余裕をもって収まるとしている。写実的な画像、英語と中国語の文字の描画、指示への追従を強みに挙げているが、本記事では文字の描画も指示への追従も測っていない。
「16GB に収まる」は配布元の説明で、本記事の結果はそれとは別に、ComfyUI 用に再配布されたファイルを ComfyUI で動かして得たものだ。bf16 / int8_convrot / nvfp4 / fp8_mixed / fp4_mixed は重みの精度・量子化形式の違いを表す名前で、画像モデル本体もテキストエンコーダも bf16 のファイルが最も大きい。
配布されているファイルと置き場所
ComfyUI で使うファイルは、Comfy-Org/z_image_turbo に「ComfyUI 用に再配布されたモデルファイル」としてまとまっている。README の案内では、置き場所は次のとおり。
- 画像モデル本体 (
bf16/int8_convrot/nvfp4):ComfyUI/models/diffusion_models - テキストエンコーダ (
qwen_3_4bのbf16/fp8_mixed/fp4_mixed):ComfyUI/models/text_encoders - VAE (
ae.safetensors):ComfyUI/models/vae - LoRA:
ComfyUI/models/loras
測定に使ったファイルの大きさを下にまとめた (revision 6fc90a3b から取得)。大きさはバイト数から GiB (1024³ バイト) で計算し、括弧内に10進の GB (10⁹ バイト) を併記している。
| 役割 | ファイル名 | 大きさ | 既定で使うテンプレート |
|---|---|---|---|
| 画像モデル本体 | z_image_turbo_bf16.safetensors | 11.46GiB (12.31GB) | image_z_image_turbo |
| 画像モデル本体 | z_image_turbo_int8_convrot.safetensors | 5.78GiB (6.20GB) | image_z_image_turbo_int8 |
| 画像モデル本体 | z_image_turbo_nvfp4.safetensors | 4.20GiB (4.51GB) | — |
| テキストエンコーダ | qwen_3_4b.safetensors | 7.49GiB (8.04GB) | image_z_image_turbo |
| テキストエンコーダ | qwen_3_4b_fp8_mixed.safetensors | 5.25GiB (5.63GB) | image_z_image_turbo_int8 |
| テキストエンコーダ | qwen_3_4b_fp4_mixed.safetensors | 3.24GiB (3.48GB) | — |
| VAE | ae.safetensors | 0.31GiB (0.34GB) | 両方 |
同じリポジトリには LoRA (z_image_turbo_distill_patch_lora_bf16.safetensors) もあるが、本記事では取得も測定もしていない。
テキストから画像を作る Z-Image-Turbo 向けの ComfyUI の公式テンプレートは2つある。テンプレート一覧での表示名は「Z-Image-Turbo: Text to Image」と「Z-Image-Turbo Int8: Text to Image」で、ほかに ControlNet 用や 2K 拡大用もあるが、本記事では使っていない。image_z_image_turbo は画像モデル本体に z_image_turbo_bf16.safetensors、テキストエンコーダに qwen_3_4b.safetensors を既定で使い、image_z_image_turbo_int8 は z_image_turbo_int8_convrot.safetensors と qwen_3_4b_fp8_mixed.safetensors を使う。VAE はどちらも ae.safetensors。それ以外の設定は2つで共通で、1024×1024・8ステップ・CFG 1・サンプラー res_multistep・スケジューラ simple・ModelSamplingAuraFlow の shift 3、CLIPLoader の type は lumina2 になっている (workflow_templates の commit 9fac9ca2 で確認)。
nvfp4 と fp4_mixed はどちらのテンプレートの既定にも入っていない。使うときは、テンプレートを開いてからローダーのファイル名を差し替える。
ライセンスは、元のモデル (Tongyi-MAI/Z-Image-Turbo) も Comfy-Org の再配布も Apache-2.0。組み合わせを全部試すとファイルは表の合計ぶん置くことになるので、ストレージの空きは先に確かめておきたい。容量の見積もり方はローカルAIでSSDは何TB要るかで扱っている。
導入の手順
- ComfyUI を用意する。この記事の測定は v0.38.0 で行った。測定後の2026年10月5日に v0.39.0 が出ているが、そちらでは測り直していない。v0.38.0 より古い版で同じ結果になるかも確かめていない。
int8_convrotの画像モデル本体は v0.27.0 のリリースノートで対応が入ったもので、それより古い版では読めない可能性がある。 - 使う組み合わせのファイルを、
ComfyUI/models以下の置き場所 (diffusion_models/text_encoders/vae) へ置く。 - テンプレート「Z-Image-Turbo: Text to Image」(
image_z_image_turbo) か「Z-Image-Turbo Int8: Text to Image」(image_z_image_turbo_int8) を開く。 - テンプレートの既定と違う組み合わせにするなら、
UNETLoaderとCLIPLoaderのファイル名だけを差し替える。ステップ数・CFG・サンプラーなどはテンプレートのままにする。この記事の測定もそうしている。 - 生成する。
配布元のモデルカードにある diffusers の例は、num_inference_steps を 9 にし、これは DiT の順伝播8回に当たると注記している。Turbo のモデルではガイダンス (guidance_scale) を 0 にするよう書かれている。ComfyUI のテンプレートは8ステップ・CFG 1 と指定の仕方が違うが、順伝播8回・ガイダンスなしという点で対応していると読める。
nvfp4 の画像モデル本体を使う場合の注意。ComfyUI v0.38.0 は、NVIDIA の GPU の compute capability のメジャー番号が10未満 (RTX 40 シリーズ以前が当たる) だと nvfp4 の計算に対応しないと判定する。その場合は nvfp4 をネイティブの量子化演算の対象から外し、エミュレーションで動かす扱いにする (comfy/model_management.py の supports_nvfp4_compute と comfy/ops.py の get_disabled_quant_formats)。今回測った RTX 5080 と RTX 5060 Ti の compute capability は、NVIDIA の一覧で 12.0。RTX 40 シリーズ以前の GPU で nvfp4 を使ったときの速さは測っていない。
1024×1024の速さ
表の「1枚目」はモデルの読み込みを含む所要時間。「2枚目以降」は同じ起動のまま続けて出した3枚の中央値で、括弧内はその3枚の範囲。どちらも ComfyUI がワークフローの実行を始めてから終えるまでの時間を測った。RTX 5060 Ti の列は OCuLink の外付け接続での値で、内蔵スロットにつないだときとの差の向きと大きさは測っていない。
まず、プロンプトを毎回書き換えて出した場合。3種の題材を1枚ごとに順に割り当てたので、テキストエンコーダは毎回動いている。
| 組み合わせ (画像モデル本体+テキストエンコーダ) | ファイル合計 (VAE込み) | RTX 5080 1枚目 | RTX 5080 2枚目以降 (中央値と範囲) | RTX 5060 Ti 1枚目 | RTX 5060 Ti 2枚目以降 (中央値と範囲) |
|---|---|---|---|---|---|
| bf16+bf16 | 19.27GiB | 7.8秒 | 6.4秒 (6.2〜6.6秒) | 14.9秒 | 13.2秒 (13.2〜13.2秒) |
| bf16+fp8_mixed | 17.02GiB | 7.8秒 | 6.1秒 (6.0〜6.3秒) | 14.6秒 | 12.6秒 (12.5〜12.9秒) |
| bf16+fp4_mixed | 15.02GiB | 7.7秒 | 5.6秒 (5.5〜5.9秒) | 14.4秒 | 11.8秒 (11.8〜11.9秒) |
| int8_convrot+bf16 | 13.58GiB | 5.3秒 | 3.2秒 (3.2〜3.4秒) | 9.0秒 | 6.2秒 (6.1〜6.2秒) |
| int8_convrot+fp8_mixed | 11.33GiB | 5.2秒 | 2.7秒 (2.7〜2.8秒) | 8.6秒 | 5.7秒 (5.6〜5.7秒) |
| int8_convrot+fp4_mixed | 9.33GiB | 5.1秒 | 2.7秒 (2.7〜2.8秒) | 8.5秒 | 5.7秒 (5.6〜5.7秒) |
| nvfp4+bf16 | 12.00GiB | 4.9秒 | 2.5秒 (2.5〜2.5秒) | 8.2秒 | 5.1秒 (5.1〜5.2秒) |
| nvfp4+fp8_mixed | 9.76GiB | 4.8秒 | 2.4秒 (2.2〜2.4秒) | 7.9秒 | 5.0秒 (5.0〜5.1秒) |
| nvfp4+fp4_mixed | 7.75GiB | 4.8秒 | 2.3秒 (2.2〜2.4秒) | 7.9秒 | 5.0秒 (4.9〜7.0秒) |
この出し方では、画像モデル本体が同じ行同士で比べると、テキストエンコーダを bf16 にした行が最も時間がかかった。差が最も大きかったのは画像モデル本体が bf16 のときで、テキストエンコーダを fp4_mixed にした行と比べて RTX 5080 で約0.8秒、RTX 5060 Ti で約1.4秒だった。
RTX 5060 Ti の nvfp4+fp4_mixed の範囲の上端 (約7.0秒) は3枚のうち1枚だけの値で、なぜその1枚だけ長かったのかは分かっていない。
次に、同じプロンプト (image_z_image_turbo の既定の題材) のまま seed だけを変えて続けて出した場合。
| 組み合わせ (画像モデル本体+テキストエンコーダ) | RTX 5080 2枚目以降 (中央値と範囲) | RTX 5060 Ti 2枚目以降 (中央値と範囲) |
|---|---|---|
| bf16+bf16 | 5.0秒 (4.8〜5.6秒) | 10.9秒 (10.9〜10.9秒) |
| bf16+fp8_mixed | 4.9秒 (4.8〜4.9秒) | 10.9秒 (10.9〜10.9秒) |
| bf16+fp4_mixed | 4.8秒 (4.8〜4.8秒) | 10.9秒 (10.9〜11.0秒) |
| int8_convrot+bf16 | 2.6秒 (2.6〜2.7秒) | 5.6秒 (5.6〜5.6秒) |
| int8_convrot+fp8_mixed | 2.6秒 (2.5〜2.6秒) | 5.6秒 (5.6〜5.6秒) |
| int8_convrot+fp4_mixed | 2.7秒 (2.6〜2.7秒) | 5.6秒 (5.6〜5.7秒) |
| nvfp4+bf16 | 2.2秒 (2.2〜2.3秒) | 4.9秒 (4.8〜4.9秒) |
| nvfp4+fp8_mixed | 2.2秒 (2.2〜2.3秒) | 4.8秒 (4.8〜4.8秒) |
| nvfp4+fp4_mixed | 2.2秒 (2.2〜2.3秒) | 4.9秒 (4.8〜4.9秒) |
この出し方では、2枚目以降はテキストエンコーダの出力が ComfyUI のキャッシュから再利用された (実行記録で CLIPTextEncode が cached と記録されていた)。そのため画像モデル本体が同じなら、テキストエンコーダを変えても1枚あたりの差は0.2秒以内に収まった。再利用が確かめられたのは、この同じプロンプトで続けて出した測定での話だ。
画像モデル本体による差は、同じプロンプトで続けて出した表の、テキストエンコーダを bf16 にした行で比べると分かりやすい。bf16 から int8_convrot にすると2枚目以降の1枚あたりは約1.9倍速く、nvfp4 にすると約2.2倍速かった。nvfp4 は bf16 の半分以下の時間で済み、int8_convrot と比べても1割強速い。この傾向は RTX 5080 でも RTX 5060 Ti でも同じだった。どちらも compute capability 12.0 の GPU で、nvfp4 がネイティブの量子化演算の対象から外れる RTX 40 シリーズ以前では、この順位は測っていない。
GPU 間では、同じプロンプトで続けて出した表の同じ行で比べると、RTX 5060 Ti の2枚目以降の1枚あたりは、どの画像モデル本体でも RTX 5080 の約2.1〜2.2倍の時間がかかった。
どちらの表も単一の測定機での値で、1つ目の表は3種の題材、2つ目の表は1つの題材 (港の前の人物) だけで測った。測定機のメインメモリは96GB。32GB や 64GB の PC で同じ組み合わせが動くか、同じ速さになるかは測っていない。1枚目はモデルの読み込みを含む値だが、PC の起動直後など、ファイルキャッシュにモデルが載っていない状態から読み込んだときの時間とは限らない。読み込みのときに OS のファイルキャッシュにどれだけ載っていたかは確かめておらず、その状態での1枚目は測っていない (2026年10月2日〜3日測定)。
2048×2048にすると
2048×2048 で測ったのは3つの組み合わせだけで、2つのテンプレートの既定 (bf16+bf16 と int8_convrot+fp8_mixed) と、ファイル合計が最も小さい nvfp4+fp4_mixed を選んだ。出し方はプロンプトを毎回書き換えるほうで、EmptySD3LatentImage の幅と高さだけを変えている。
| 組み合わせ (画像モデル本体+テキストエンコーダ) | GPU | 1枚目 (モデル読み込み込み) | 2枚目以降 (中央値と範囲) |
|---|---|---|---|
| bf16+bf16 | RTX 5080 | 29.0秒 | 27.7秒 (27.5〜27.7秒) |
| int8_convrot+fp8_mixed | RTX 5080 | 19.4秒 | 18.2秒 (18.1〜18.2秒) |
| nvfp4+fp4_mixed | RTX 5080 | 18.5秒 | 16.8秒 (16.7〜16.9秒) |
| bf16+bf16 | RTX 5060 Ti | 62.7秒 | 61.1秒 (61.1〜61.3秒) |
| int8_convrot+fp8_mixed | RTX 5060 Ti | 44.7秒 | 44.4秒 (44.0〜44.4秒) |
| nvfp4+fp4_mixed | RTX 5060 Ti | 38.9秒 | 37.5秒 (37.5〜37.5秒) |
2048×2048 の2枚目以降の1枚あたりは、nvfp4+fp4_mixed が bf16 同士より約1.6倍速かった。RTX 5080 でも RTX 5060 Ti でも同じくらいの比で、プロンプトを書き換えた 1024×1024 のときより倍率は縮まっているが、秒の差はむしろ広がっている。
1024×1024 でプロンプトを毎回書き換えたときの RTX 5080 の2枚目以降は、bf16 同士が6.4秒、nvfp4+fp4_mixed が2.3秒だった。画素数が4倍の 2048×2048 では、それぞれ約4.3倍 (27.7秒) と約7.3倍 (16.8秒) になった。bf16 同士は画素数の比 (4倍) にほぼ沿い、nvfp4+fp4_mixed は比を大きく上回った。違いが出た理由は調べておらず、測ったのは3つの組み合わせだけなので、伸び方の一般則とも言えない。
2048×2048 では、カード全体の使用量のピーク (nvidia-smi) が 14,784〜15,314MiB と、16GB のカードのほぼ上限まで使われた (止まった枚は無い)。これより大きい解像度は測っていない。2048×2048 の画像同士の比較もしていない。測定機と接続の条件は 1024×1024 と同じで、96GB の測定機以外での結果は分からない。
VRAMとメインメモリの使用量はどう読むか
先に結論を書くと、どの組み合わせも VRAM 16GB で止まらなかった。ただし、この節で読む VRAM とメインメモリの使用量の値は、どれもその組み合わせを動かすのに最低限要る VRAM の量を示すものではない。
NVIDIA の GPU など対応する環境の ComfyUI v0.38.0 は、--disable-dynamic-vram などの起動オプションを付けない限り dynamic VRAM を使う。モデルを最初から全部 VRAM に置くのではなく、必要に応じて VRAM に載せる読み込み方だ (--highvram・--gpu-only・--novram・--cpu を付けたときも dynamic VRAM は使われない)。本測定では全条件で、ComfyUI のログに dynamic VRAM で読み込む旨の行が出ていた。
VRAM について読んだ値は2種類ある。1つは nvidia-smi で生成中に繰り返し読んだカード全体の使用量の最大値で、画面表示など他のプロセスのぶんも含む (画面をつないでいたのは RTX 5080 側)。もう1つは ComfyUI のプロセス内で torch.cuda.max_memory_reserved を読んだ、PyTorch のメモリプールとして確保された量のピークだ。こちらは1枚ごとに、生成の直前に torch.cuda.reset_peak_memory_stats でピークを戻してから読んだ。下の表は全168枚の実行ごとの値の範囲を、GPU と解像度ごとにまとめたもの (1024×1024 は72枚ずつ、2048×2048 は12枚ずつ)。生成を始める前の値は、各組み合わせの1枚目の直前に読んだ。
| GPU と解像度 | カード全体の使用量のピーク (nvidia-smi) | PyTorch のメモリプールとして確保された量のピーク | 生成を始める前のカード全体の使用量 |
|---|---|---|---|
| RTX 5080・1024×1024 | 9,199〜15,452MiB | 3,186〜3,232MiB | 589〜748MiB |
| RTX 5080・2048×2048 | 14,987〜15,314MiB | 12,566〜12,666MiB | 555〜729MiB |
| RTX 5060 Ti・1024×1024 | 8,822〜14,932MiB | 3,186〜3,232MiB | 114〜124MiB |
| RTX 5060 Ti・2048×2048 | 14,784〜14,916MiB | 12,566〜12,666MiB | 114MiB |
nvidia-smi で読んだカード全体のピークは、1024×1024 で 8,822〜15,452MiB と、組み合わせや実行ごとに大きくばらついた。ファイル合計が小さい組み合わせでは低めに出やすく、大きい組み合わせはカードの容量の近くで頭打ちになった。同じ組み合わせでも、出し方や実行によって大きくずれたものがある。一方、PyTorch のメモリプールとして確保された量のピークは、1024×1024 で 3,186〜3,232MiB、2048×2048 で 12,566〜12,666MiB と、組み合わせによらずほぼ一定だった。2つの値は同じ時刻のピークとは限らず、PyTorch の値には PyTorch の外で確保されたメモリが入らない。この値は組み合わせによらず一定で、モデルのファイルの大きさを反映していないので、これも動かすのに要る VRAM の量ではない。dynamic VRAM のもとでは、nvidia-smi のピーク値はその組み合わせを動かすのに最低限要る VRAM の量を示すものではなく、カードにどれだけ載っていたかの記録として読むのが妥当だ。
dynamic VRAM の仕組みや、起動オプションを変えたときの挙動はComfyUIの起動オプション実測ガイドで詳しく測っている。
メインメモリは、ComfyUI のプロセスが OS から確保したメモリ (Windows のコミット。以下、確保量) と、プロセスのアドレス空間のうち物理メモリに載っていたページの量 (ワーキングセット) を分けて読んだ。確保量は0.25秒ごとに読んだ最大値、ワーキングセットは OS が記録する起動後のピーク (ComfyUI のプロセスごとの値の合計) で、2つは別々の時刻のピークにあたる。下の表は RTX 5080 でプロンプトを毎回書き換えた条件の、組み合わせごとの4枚を通した最大値。
| 組み合わせ (画像モデル本体+テキストエンコーダ) | 解像度 | メインメモリの確保量 (ピーク) | 物理メモリに載っていた量 (ワーキングセットのピーク) |
|---|---|---|---|
| bf16+bf16 | 1024×1024 | 19.55GiB | 2.88GiB |
| bf16+fp8_mixed | 1024×1024 | 19.46GiB | 2.80GiB |
| bf16+fp4_mixed | 1024×1024 | 19.59GiB | 3.07GiB |
| int8_convrot+bf16 | 1024×1024 | 19.12GiB | 2.94GiB |
| int8_convrot+fp8_mixed | 1024×1024 | 19.06GiB | 2.62GiB |
| int8_convrot+fp4_mixed | 1024×1024 | 17.46GiB | 2.89GiB |
| nvfp4+bf16 | 1024×1024 | 19.30GiB | 3.22GiB |
| nvfp4+fp8_mixed | 1024×1024 | 18.08GiB | 3.16GiB |
| nvfp4+fp4_mixed | 1024×1024 | 16.23GiB | 3.43GiB |
| bf16+bf16 | 2048×2048 | 20.40GiB | 3.92GiB |
| int8_convrot+fp8_mixed | 2048×2048 | 19.17GiB | 2.96GiB |
| nvfp4+fp4_mixed | 2048×2048 | 19.59GiB | 3.65GiB |
RTX 5060 Ti を含む42条件を通すと、確保量のピークは16.1〜20.4GiB、ワーキングセットのピークは2.5〜3.9GiB の範囲に収まった。どちらもメインメモリ96GB の測定機での値で、32GB や 64GB の PC で同じ組み合わせが動くかは測っていないが、手元の空きメモリとこの2つの値を見比べる材料にはなる。メインメモリの量をどう見積もるかは画像・動画生成でシステムRAMは何GB要るかで整理している。
出てくる画像はどれだけ変わるか
比べ方は次のとおり。同じ GPU・同じプロンプト・同じ seed で、bf16 同士の組み合わせの画像を基準にし、ほかの8通りの画像との差を PSNR で測った。PSNR は基準の画像からどれだけ離れたかの指標で、単位は dB、数字が大きいほど基準に近い。あわせて平均絶対差 (0〜255 の画素値の差の平均。小さいほど基準に近い) も出した。どちらも「基準からの離れ具合」を表すだけで、画質の良し悪しや好みは表さない。
使った画像は 1024×1024 の3組 (港の前の人物 seed 0・夕暮れの灯台 seed 1・雨の窓辺の急須 seed 2) で、RTX 5080 と RTX 5060 Ti でそれぞれ比べた。表の範囲は、この計6つの比較の最小〜最大。右端の列は、同じ組み合わせ・同じプロンプト・同じ seed で RTX 5080 と RTX 5060 Ti の画像同士を比べた PSNR (3組) だ。
| 組み合わせ (画像モデル本体+テキストエンコーダ) | bf16+bf16 との PSNR (同じ GPU) | bf16+bf16 との平均絶対差 | 同じ組み合わせの GPU 間の PSNR |
|---|---|---|---|
| bf16+bf16 | 基準 | 基準 | 35.5〜36.5dB |
| bf16+fp8_mixed | 25.5〜28.4dB | 3.8〜6.2 | 36.3〜40.2dB |
| bf16+fp4_mixed | 21.9〜25.3dB | 5.6〜12.4 | 27.9〜37.8dB |
| int8_convrot+bf16 | 29.7〜35.1dB | 2.0〜3.3 | 30.5〜33.8dB |
| int8_convrot+fp8_mixed | 24.4〜27.5dB | 4.7〜7.5 | 28.5〜33.1dB |
| int8_convrot+fp4_mixed | 16.9〜25.4dB | 5.5〜20.1 | 17.9〜33.0dB |
| nvfp4+bf16 | 15.4〜20.0dB | 14.6〜27.5 | 15.7〜25.2dB |
| nvfp4+fp8_mixed | 18.5〜21.7dB | 13.1〜19.8 | 23.7〜27.2dB |
| nvfp4+fp4_mixed | 17.5〜20.9dB | 13.7〜19.6 | 20.0〜25.1dB |
int8_convrot+bf16 は 29.7〜35.1dB で、6つの比較のどれでも基準に最も近かった。6つの比較のうち5つでは、nvfp4 の3つの組み合わせ (全体で 15.4〜21.7dB) が8通りの中で最も基準から離れていた。残る1つ (RTX 5080 の急須) では int8_convrot+fp4_mixed が 16.9dB で、nvfp4 の3つのうち2つ (nvfp4+fp8_mixed と nvfp4+fp4_mixed) より基準から離れていた。int8_convrot+fp4_mixed は 21.3dB や 21.7dB の比較もあり、範囲 (16.9〜25.4dB) が nvfp4 と重なる。RTX 5080 の3組を並べて目で見ても、nvfp4 の組み合わせは背景や小物の配置が基準と違っていた。
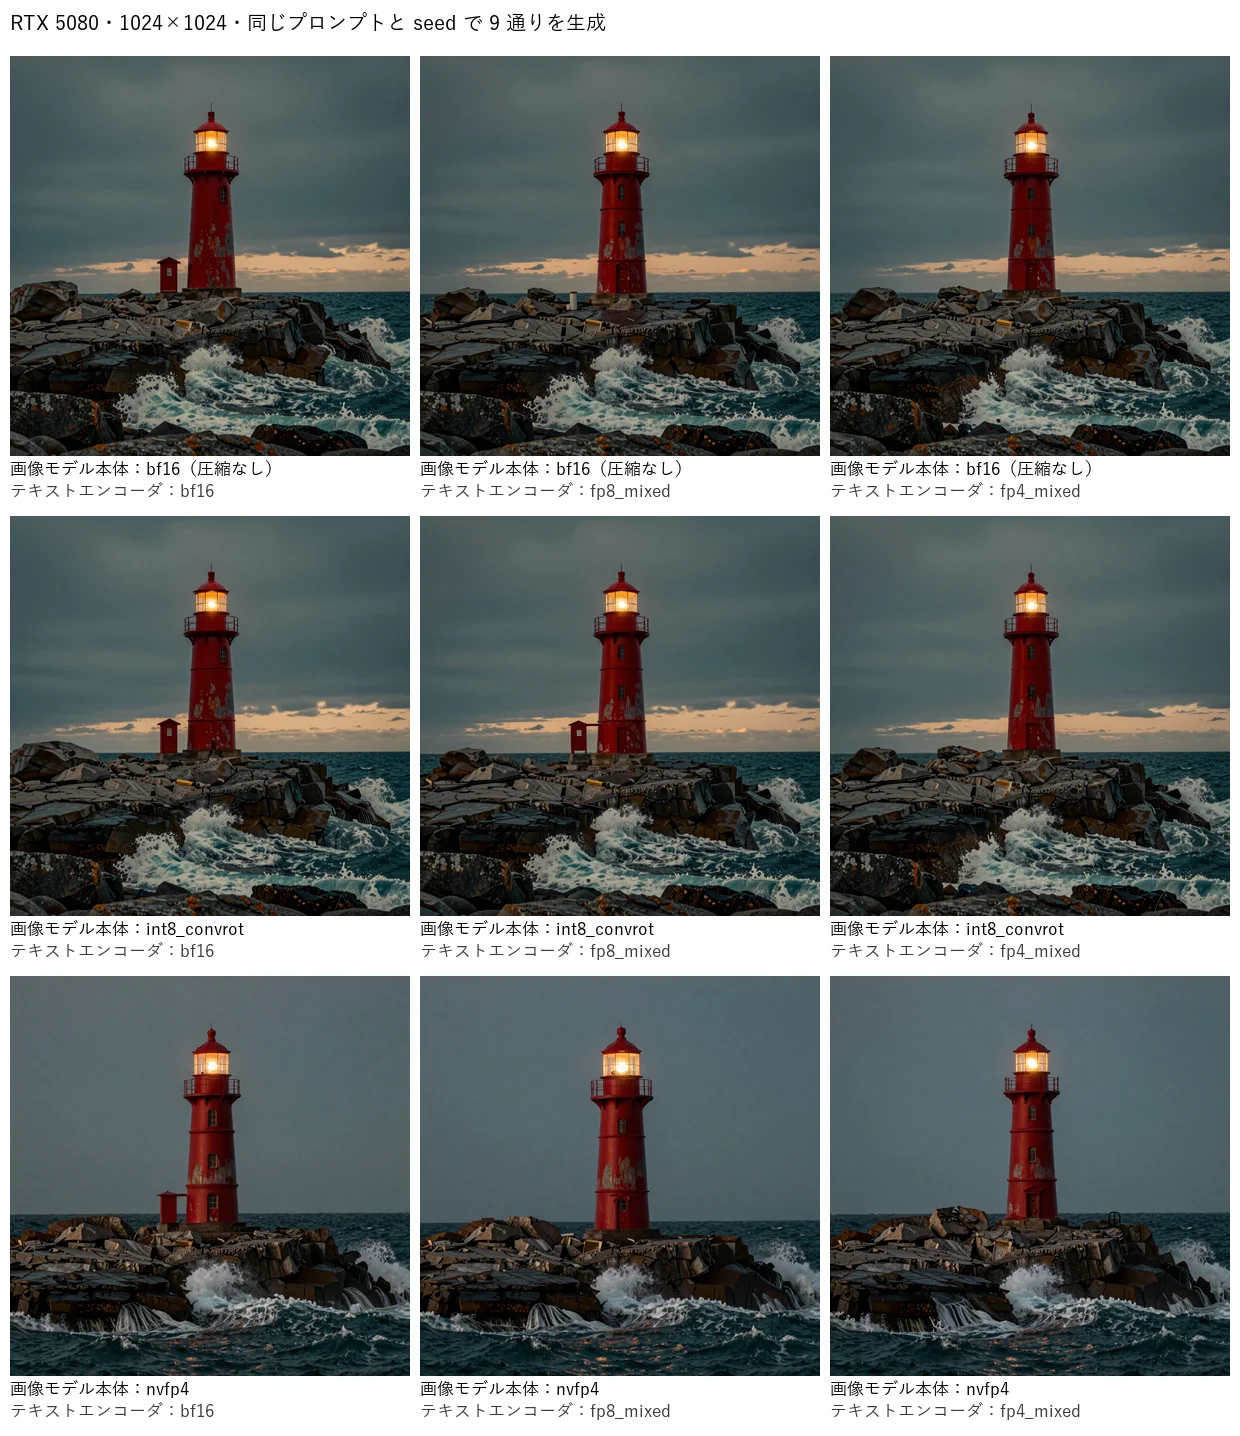
bf16+bf16。画像モデル本体が nvfp4 の下の段は、空の夕焼けの帯がなく、岩場や波の形も上の2段と大きく違う。上の2段でも、灯台の脇の小屋はテキストエンコーダの違いで出たり消えたりしている。テキストエンコーダだけを fp8_mixed や fp4_mixed にしても、画像は基準から離れる。画像モデル本体が bf16 のままでも、fp8_mixed で 25.5〜28.4dB、fp4_mixed で 21.9〜25.3dB だった。
この差を読むときの手がかりになるのが、GPU を替えたときの差だ。同じ組み合わせ・同じプロンプト・同じ seed で出しても、RTX 5080 と RTX 5060 Ti の画像は、ファイルの sha256 で比べた84組 (1024×1024 の72組と 2048×2048 の12組) のどれも一致しなかった。bf16 同士の組み合わせでの GPU 間の PSNR は 35.5〜36.5dB で、GPU を替えただけでもこの程度は離れる。ただしこれは bf16 同士の値で、表の右端の列のとおり、GPU 間の PSNR は組み合わせによって大きく違う。bf16+fp8_mixed は 36.3〜40.2dB で bf16 同士 (35.5〜36.5dB) と同程度かそれ以上なのに対し、nvfp4 の3つは 15.7〜27.2dB で、基準との PSNR (15.4〜21.7dB) と範囲が重なる。bf16 同士の値は、ほかの組み合わせにそのまま当てはまる目安ではない。GPU 間で画像が違う原因は調べていない。
比べたのは3種の題材の各1枚で、ほかの題材や seed で同じ差になるかは測っていない。どの組み合わせの画像が良いかも決めていない。ほかの画像モデルで精度を変えたときの比較は精度を落とすと何が変わるか|SDXL・Flux・MiniMax H3など5モデルをFP16/BF16/FP8で実測にまとめている。
検証環境と測り方
- 測定機: CPU i7-14700F、メインメモリ96GB、Windows 11、NVIDIA ドライバ 610.47
- GPU: RTX 5080 16GB と RTX 5060 Ti 16GB。RTX 5060 Ti は OCuLink の外付け接続。
CUDA_VISIBLE_DEVICESで1枚ずつ見せて別々に測った - ソフト: ComfyUI v0.38.0、PyTorch 2.14.0+cu130。VRAM の管理に関わる起動オプションは付けず (測定ごとに分けるため、ポート番号・出力先・ユーザーフォルダ・データベースの指定だけを付け、プレビューは既定どおり切った)、dynamic VRAM は既定のまま
- モデルのファイル: Comfy-Org/z_image_turbo の revision 6fc90a3b から取得したもの
- ワークフロー: 公式テンプレート
image_z_image_turbo/image_z_image_turbo_int8(workflow_templates の commit 9fac9ca2) の設定のまま、UNETLoaderとCLIPLoaderのファイル名だけを差し替えた。2048×2048 はEmptySD3LatentImageの幅と高さだけを変えた - 回し方: 1つの組み合わせごとに ComfyUI を起動し直し、4枚続けて生成した (seed は 0〜3)
- プロンプトを毎回書き換える出し方: 3種の題材 (港の前の人物・夕暮れの灯台・雨の窓辺の急須) を1枚ごとにこの順で割り当てた。4枚目は1つ目の題材に戻るが、直前と違うのでテキストエンコーダは毎回動いた
- 同じプロンプトの出し方:
image_z_image_turboの既定の題材 (港の前の人物) を、どの組み合わせでも使い、seed だけを変えた - 所要: ComfyUI がワークフローの実行を始めてから終えるまで (
execution_startからexecution_success)。1枚目はモデルの読み込みを含む。ファイルの sha256 は計算して記録してあるが、組み合わせごとの起動前にファイル全体を読み直したわけではなく、1枚目の読み込みのときに OS のファイルキャッシュにどれだけ載っていたかは確かめていない - VRAM:
nvidia-smiで生成中に繰り返し読んだカード全体の最大値と、ComfyUI のプロセス内で読んだtorch.cuda.max_memory_reserved - メインメモリ: ComfyUI のプロセスのコミットを0.25秒ごとに読んだ最大値と、OS が記録するワーキングセットの起動後のピーク
- 画像の比較: 同じ GPU の中で
bf16同士の画像を基準にした PSNR (RGB の全画素から計算) と平均絶対差。GPU 間は全168枚を同じ条件同士で対にし、ファイルの sha256 で一致を見た
本記事の実測値は2026年10月2日〜3日に、上記の測定機・設定で計測したもの。測定機の構成の詳細は検証環境のページにまとめてある。同じ測り方で別の画像モデル本体とテキストエンコーダの組み合わせを測った例としてはMing-Image-0.1-DesignをVRAM 16GBで動かすがあり、ほかの GPU やモデルの実測はAIハードウェア実測データベースから探せる。
まとめ
メインメモリ96GB の測定機では、Z-Image-Turbo の画像モデル本体とテキストエンコーダの9通りが、VRAM 16GB の RTX 5080 と OCuLink 外付けの RTX 5060 Ti のどちらでも、ComfyUI v0.38.0 の既定の起動 (dynamic VRAM) で最後まで生成できた。ファイル合計が VRAM を超える bf16 同士も動いたが、VRAM に全部が載った結果ではない。
速さを優先するなら画像モデル本体の選び方が効き、測った2つの GPU (どちらも RTX 50 シリーズ) では nvfp4 が最も速く、次いで int8_convrot だった。RTX 40 シリーズ以前では nvfp4 がネイティブの量子化演算の対象から外れるため、この順位は測っていない。テキストエンコーダの選び方が所要時間に響くのはプロンプトを書き換えながら出す使い方のときで、その差も1枚あたり約1.4秒 (RTX 5060 Ti) までだった。
測った3種の題材では、出てくる画像を bf16 同士の組み合わせに近づけたい場合は int8_convrot+bf16 が最も近く、nvfp4 は同じ seed でも背景や小物まで変わった。PSNR が示すのは基準からの離れ具合で、どの画像が良いかはこの記事では決めていない。
参考資料
- Z-Image-Turbo (Tongyi-MAI, Hugging Face)
- Comfy-Org/z_image_turbo (ComfyUI 用のモデルファイル)
- テンプレート image_z_image_turbo (workflow_templates commit 9fac9ca2)
- テンプレート image_z_image_turbo_int8 (workflow_templates commit 9fac9ca2)
- ComfyUI v0.38.0 comfy/model_management.py
- ComfyUI v0.38.0 comfy/cli_args.py
- CUDA GPU Compute Capability (NVIDIA)