RTX 5080で画像生成を回しながら、裏でもう1枚のGPUに別の生成タスクを投げたい。ComfyUIを日常的に使っていると、そんな場面に出くわすことがある。当サイトの環境ではメインPCにRTX 5080(16GB)、MINISFORUM DEG1経由のOculink接続でRTX 4070 Super(12GB)を増設した2枚構成で運用してきた(2026年9月にサブを RTX 5060 Ti 16GB へ入れ替え、同じ問いを測り直した結果も載せている)。実測は年代で分かれている。2026年4月の分は 5080 + 4070 Super、2026年9月の測り直しは 5080 + 5060 Tiで、どちらの構成で測ったかは表ごとに書いてある。ComfyUIのデュアルGPU運用は「できること」と「できないこと」の差が極端に大きい。この記事では、当サイトで測った分は実測として、そうでない分は公式の記述として区別しながら、何が実用的で何がそうでないのかを整理する。
- ComfyUIのデュアルGPU運用はポート分離による並列処理が最も実用的。2つのインスタンスを別ポートで起動し、それぞれに使うGPUを指定して独立して動かす方式
- 標準の ComfyUI では 16GB + 12GB を透過的な 28GB として扱えない。カスタムノードによる層の分散は可能
- Ollamaなど一部のLLMツールでは layer split(層分散)で、モデルとKVキャッシュを2枚のVRAMへ分けて置ける。用途によって判断が分かれる
この記事で言える範囲: ポート分離の実測は 2026年9月・RTX 5080 + RTX 5060 Ti 16GB(OCuLink x4)・SDXL と LTX-2。ComfyUI-MultiGPU の層分散と Raylight は公式の記述にもとづく整理で、当サイトでは未実測。本体同梱の MultiGPU CFG Split だけは同じ構成で実測したが、公式が前提とする同型2枚ではないため対象外の構成での結果で、1本の生成は速くならなかった(1.7 倍近く)。
初出(2026-04-10)の実測はメイン RTX 5080 + サブ RTX 4070 Super 12GB。2026年9月にサブを RTX 5060 Ti 16GB へ入れ替え、同じ問いを測り直したものも載せてある。旧構成の表を新構成の性能比較には使えないので、各表に測定日と構成を明記した。タイトルの括弧は初出時の構成を指している。ソフト側の版も一枚岩ではないので、既定の挙動が版で変わる箇所については、どの版で確かめたかを本文に書き分けてある。
ポート分離方式の並列処理 ― 最も実用的なデュアルGPU運用
デュアルGPU環境でComfyUIを使うなら、最初に検討すべきはポート分離方式だ。やることは単純で、GPU1台につきComfyUIのインスタンスを1つずつ起動し、それぞれ別のポートを割り当てる。メインGPUはポート8188、サブGPUはポート8189、のように分ける。ポートに加えて、どちらのインスタンスにどのGPUを使わせるかも起動時に指定する。ブラウザで2つのタブを開けば、それぞれ独立した生成環境として動作する。
起動時の設定ポイント
メインGPU(RTX 5080)側の起動オプションで押さえるべき点は、--port 8188 --cuda-device 0 --reserve-vram 1.5 --bf16-unet --bf16-text-enc あたり。サブGPU側は --port 8189 --cuda-device 1 を指定する。CUDA_VISIBLE_DEVICES を別に立てる必要はない。ComfyUI では --cuda-device に番号を渡すと、その番号のデバイスを残して他を見えなくする動きになり、内部で CUDA_VISIBLE_DEVICES を書き換えるからだ(手元の v0.31.1 と、2026年9月6日時点で最も新しいタグである v0.34.5 の実装で確認)。番号を渡した場合は、先に環境変数を設定していてもこの引数に上書きされる。なおこの 0 / 1 は PCI バス順に並べたときの番号で、CUDA の既定は性能順(FASTEST_FIRST)の列挙になる。まず両方の起動前に set CUDA_DEVICE_ORDER=PCI_BUS_ID を入れて順序を固定し、そのうえで nvidia-smi でどちらが何番かを確認してから番号を写す。順序を固定しても、当サイトの起動設定にある 0 / 1 がそのままお使いの環境に当てはまるとは限らない。x16 スロット側が後に列挙されるマザーボードなら、0 と 1 は逆になる。
ここで --reserve-vram に数字を入れているが、これは「この量を必ず空けておく」という上限の指定ではない。起動オプションを一通り実測した別記事では、13GBを申告した回でも専用VRAMのピークは申告から計算した上限を上回っていた(測定時のバージョンでの挙動で、この手のオプションはバージョンで変わる。現行版には DynamicVRAM 用に --vram-headroom という別のオプションも入っている)。このオプションは「そこで天井を打つ」ものではなく「増やせばピークが下がる方向に動く」もので、上の 1.5 も上限値ではなく、デスクトップ描画や同居プロセスの分を残しておくための出発点の目安だ。VRAMモードは両方とも指定なし、つまり ComfyUI の既定の動的管理に任せている。2枚を同時に回すと片方を絞りたくなるが、絞った分がそのまま待ち時間になるとも限らない。1枚構成で空けるVRAM量を1.5GBから12GBへ増やして測った記事では、GPU全体のピークは測った74組すべてで下がった一方、生成時間の増加を検出できたのは判定できた6構成のうち1つだけだった。2枚を同時に回した場合に同じことが言えるかは測っていない。
| 項目 | メインGPU (RTX 5080) | サブGPU (Oculink 側・現在は RTX 5060 Ti) |
|---|---|---|
| 環境変数 | set CUDA_DEVICE_ORDER=PCI_BUS_ID | set CUDA_DEVICE_ORDER=PCI_BUS_ID |
| ポート | --port 8188 |
--port 8189 |
--cuda-device |
0 | 1 |
| VRAM モード | 指定なし(既定の動的VRAM管理) | 指定なし(既定の動的VRAM管理) |
| 予約VRAM | --reserve-vram 1.5 |
指定なし |
| dtype 関連のオプション | --bf16-unet --bf16-text-enc |
--fp8_e4m3fn-unet --fp8_e4m3fn-text-enc |
これは現在の2インスタンスの設定。9月の測り直しでサブ側を bf16 に揃えた回だけは別で、その設定と結果は「起動オプションを揃えると、2枚の差はどれくらいか」の節にまとめてある。
起動オプションの詳細仕様は ComfyUI 公式リポジトリ の comfy/cli_args.py の引数定義から確認できる。公式の定義では --bf16-unet が「拡散モデルを BF16 で実行する」、--bf16-text-enc が「テキストエンコーダの重みを BF16 で保持する」で、対象も役割も別のオプションだ。BF16 の演算は Ampere 以降のアーキテクチャ(RTX 30/40/50 系)が Tensor Core でハードウェア対応している。Ampere の Tensor Core が BF16 に対応していることは NVIDIA Ampere GPU Architecture Tuning Guideに記載がある(「Improved Tensor Core Operations」の節)。
--cuda-device に番号を渡すと「使うデバイスを指定して他を見えなくする」動きになるので、CUDA_VISIBLE_DEVICES を別に立てる必要はない(同時に指定しても上書きされる)。注意が要るのは番号のほうで、どの番号がどのカードを指すかは列挙順で変わる。 v0.34 以降の Windows は、指定しないと2枚目が見えなくなる
ここまでは --cuda-device を書く前提で進めてきたが、書かなかったときの既定が v0.34 で変わっている。v0.34.0 以降の main.py は、Windows で --cuda-device も --default-device も環境変数 CUDA_VISIBLE_DEVICES も与えずに起動されたとき、CUDA_VISIBLE_DEVICES に 0 を設定してから立ち上がる。CUDA が数える順の先頭の1枚だけが見えている状態になる。この分岐は os.name が nt のとき、つまり Windows のときだけ通る。v0.33.0 から v0.33.4 までの main.py にこの分岐は無く、v0.34.0 と、2026年9月6日時点で最も新しいタグである v0.34.5 の main.py は同一だった。
変わったのは「見える枚数」であって「使う枚数」ではない。GPUを選ぶ指定を書かなければ生成が1枚で走るのは以前からで、v0.31.1 と v0.33.4 の実装はどちらも、使うデバイスを torch.cuda.current_device()(既定で先頭の1枚)から決めている。実際、ComfyUI を2つ起動して --port だけを分けた条件では、2つとも同じカード(この構成では cuda:0 に出た RTX 5080)に載り、もう1枚のピークは3回とも 0MiB のままだった(2026年9月6日・v0.34.5 で実測。v0.33 以前を対照に回してはいないので、この結果そのものは新しい分岐の証拠ではない)。v0.34 で新しくなったのは、選ばれなかった1枚がプロセスから見えなくなるほうだ。MultiGPU CFG Split のように1つの生成を2枚で分担させるノードは、2枚が見えていないと成立しない。そちらを試すなら指定が要る。
絞り込んだことを本体は知らせない。v0.34.5 はこの分岐で警告を出さないので、2枚目が見えないのが増設側の問題なのか本体の既定なのかは、起動ログの見た目からは判別できない。
この分岐に入るのは、Windows で上の3つのどれも渡さずに起動した場合すべてだ。よくあるのは、公式の Windows Portable に同梱される run_nvidia_gpu.bat をそのまま使っている場合と、その bat をコピーしてポート番号だけを変えた2つを用意した場合。自分で main.py を叩いている場合も、GPUを選ぶ指定を書いていなければ同じところに入る。v0.34.5 時点の配布物の起動行は main.py に --windows-standalone-build を渡すだけで、GPUを選ぶ指定はどの行にも入っていない。この記事の起動設定のほうは、両方のインスタンスに --cuda-device を渡しているので分岐に入らない。
いま何枚見えているかは、ブラウザで http://127.0.0.1:8188/system_stats を開き devices の件数を見るのが確実だ(ポートを変えているならその番号に読み替える)。v0.34.5 では起動時にコンソールへ出る Device: を含む行でも数えられるが、この出力の形は版で変わりうるので、数が合わないときは system_stats のほうを見る。2枚とも残したいだけなら、起動行の末尾に --cuda-device all を足す。この値は v0.34 系で受け付けられ、番号を渡したときと違って可視デバイスを絞らない。ただし絞らないだけで、増やすわけではない。先に CUDA_VISIBLE_DEVICES で見える範囲を狭めてあるなら、all を付けてもその外側のカードは戻ってこない。
ただし、2枚見えることと速くなることは別だ。SDXL の同じワークフローを1本流した範囲では、指定なしと --cuda-device all の中央値の差は、走行と順序を変えて4回比べたどれでも、同じ条件を繰り返したときの幅より小さかった。しかも速い側が一定しない。ある走行では順序を入れ替えると逆転し、別の走行では2パスとも指定なしがわずかに速かった。差の向きが走行で変わる程度の大きさということで、この条件では、見せる枚数を増やしても1本の生成時間は動かなかった。なお、指定なしで起動したときに見えるデバイスが1件、--cuda-device all では2件になることは、どちらの走行でも同じだった。見せることと分担させることは別で、2枚を1本の生成に使うには MultiGPU CFG Split のような専用のノードが要る。枚数の数え方、2枚とも見せる書き方、条件ごとの生成時間はComfyUIで使うGPUを指定するにまとめてある。
なお、v0.34 の既定についてここに書いたことは 2026年9月6日に v0.34.5 で確かめたもので、2026年9月の測り直し(SDXL と LTX-2)は v0.31.1 で測っている。後者は両側の起動 bat がどちらも --cuda-device を渡しているため、上に書いた既定には当たっていない。
使うGPUを指定する ― CUDA_VISIBLE_DEVICES と --cuda-device の番号対応
CUDA_VISIBLE_DEVICES 環境変数は、CUDA ランタイムから「見える」GPUを絞り込む仕組みだ。ただし現行の ComfyUI では、この環境変数を手で立てる場面はほとんどない。--cuda-device に番号を渡せばその役目を兼ねていて、指定した番号だけを残して他を見えなくする(v0.31.1 のヘルプは「All other devices will not be visible.」と明記し、実装も内部で CUDA_VISIBLE_DEVICES を書き換えている)。値が all のときだけは別で、v0.34 系で確かめた範囲では可視デバイスを絞らない。つまり --cuda-device 1 と書けば、そのプロセスからは 1 番のカードだけが見える。混乱しやすいのは、その「1 番」が物理的にどちらのカードかが列挙順しだいで変わる点のほうだ。既定では、CUDA が速いと見た順に 0 番から並ぶ。
GPU の列挙順を制御するには CUDA_DEVICE_ORDER 環境変数を併用する。デフォルトでは FASTEST_FIRST(性能順)で列挙されるため、デュアルGPU構成だと意図せず順序が入れ替わる場合がある。PCI バス順に固定したい場合は CUDA_DEVICE_ORDER=PCI_BUS_ID を設定する。仕様の根拠は NVIDIA CUDA Programming Guide「CUDA Environment Variables」にある。
起動したあと実際にどちらを掴んだかは、生成を1本流している最中に nvidia-smi を叩き、そのプロセスがどちらのGPU上にいるか・使用率が動いているのがどちらかで確かめられる。番号を信じるより、動いている側を見るほうが早い。
この方式の最大の利点は、メインGPUで作業中にサブGPUの生成処理が割り込まない点。速度差のあるGPU同士でも問題にならない。メモリ使用量が2インスタンス分になるのはデメリットだ。実測すると、SDXL を回している間のメインメモリは1つで 8.9GB、2つで 17.8GB とほぼ2倍だった。詳しくは後半の「メインメモリはどれだけ要るか」にまとめてある。
実測データ: ポート分離で2枚を同時に回したときの速度
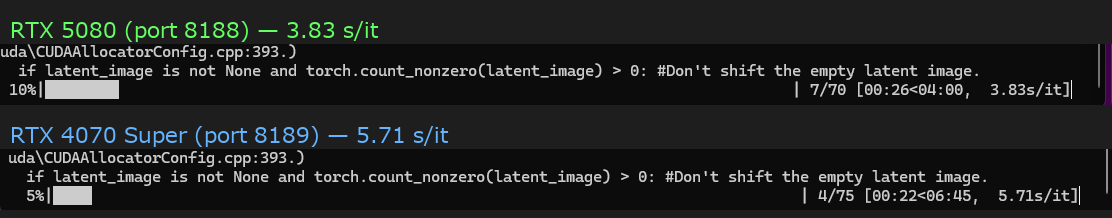
当サイトの検証環境(i7-14700F / 96GB RAM)で、両GPUに同時に生成タスクを投入した結果が以下の通り。
| GPU | 接続方式 | サンプリング速度 | ステップ数 |
|---|---|---|---|
| RTX 5080 (16GB) | PCIe x16 | 3.83 s/it | 70ステップ |
| RTX 4070 Super (12GB) | Oculink (PCIe x4) | 5.71 s/it | 75ステップ |
2026-04-10 計測(サブGPU = RTX 4070 Super)。左右でワークフロー・解像度・ステップ数を揃えておらず、9月に測り直した表(SDXL・1280×720・30ステップ)とも別条件。表をまたいで数字を比べることはできない。
押さえておきたいのは、並列実行時でも互いの速度に干渉している兆候がなかった点。PCIe x16とOculink(PCIe x4)で帯域が異なるものの、画像生成はGPU内のVRAMで完結する処理が大半であり、今回の条件では、バス帯域の取り合いによる目立った落ち込みは観測されなかった。Oculink経由のRTX 4070 Superでも、s/it が落ち込む様子は見られなかった。ただしこの回は単独実行の値を対照として記録しておらず、単独との差を数字で示せてはいない(対照を取ったのは9月の測り直しから)。
ひとつ断っておくと、2026年4月の s/it の表は、2行のステップ数が70と75で揃っていない。1ステップあたりの秒数(s/it)同士を並べた表であって、1枚を出し終えるまでの総時間を比べたものではない。総時間で比べたいなら、ステップ数を揃えて測り直す必要がある。
2026年9月・サブGPUを RTX 5060 Ti 16GB に替えて測り直した
上の実測は2026年4月、サブGPUが RTX 4070 Super だった頃のものだ。その後サブを RTX 5060 Ti 16GB に入れ替えたので、同じ問い(2枚に同時投入すると互いに遅くなるのか)を現行構成で測り直した。前回はステップ数が70と75で揃っていなかったので、今回は同じワークフロー・同じ解像度・同じステップ数を両方へ投げ、さらに単独で回したときの値も対照として取った(前回はこれが無かった)。
| 条件 | メイン RTX 5080 (PCIe x16・bf16) |
サブ RTX 5060 Ti (Oculink x4・fp8) |
|---|---|---|
| 単独で回す(中央値・5本) | 6.55 秒 | 11.48 秒 |
| 2枚同時に投げる(中央値・5本) | 6.5 秒 | 11.46 秒 |
| 差 | −0.8% | −0.2% |
| 単独時のばらつき(最小〜最大) | 6.39〜6.64 秒 | 11.39〜11.53 秒 |
| 1ステップあたり | 0.218 秒 | 0.383 秒 |
SDXL・1280×720・30ステップ。ComfyUI を 8188 と 8189 の2インスタンスで起動し、各側で1本ウォームアップを捨ててから5本ずつ計測(計測日 2026-09-03)。なおこの回は、すでに起動していた ComfyUI に接続して測っている(この点はあとで詳しく書く)。所要は API へ投げてから完了を検知するまでの実時間。
どちらのGPUも、並列にしたことによる明確な低下は確認できなかった。この回は差が負(わずかに速い)に出ているが、これは既に起動していたインスタンスに接続して測った回で、起動から確認して測り直した3走行はいずれも数%の低下側に出た(あとで並べる)。差はいずれも単独で5本回したときのばらつき(メイン側で 6.39〜6.64 秒)の中に収まっている。ただし完了検知は0.25秒間隔のポーリングで、6.5秒の生成に対しては約4%、11.5秒でも約2%にあたる。n=5でもあるので、この測定から言えるのは「数%規模の低下は観測されなかった」までで、−0.8% という値そのものを性能差として読むことはできない。4月は単独実行の対照を取らないまま「干渉している兆候がなかった」と書いていた。今回はその問いを、サブを入れ替えた現行構成で対照付きに測り直した形になる。4月の RTX 4070 Super 構成そのものを測り直したわけではない。
実利がはっきり出るのは、そこではなく2枚分が終わるまでの時間のほうだ。同時に投げると11.57秒で両方終わる(実測の中央値)。順番に流した場合は単独の中央値を足して 6.55 + 11.48 = 18.03秒で、連続実行そのものは測っていない。比にして約 1.56 倍のスループットで、しかもメイン側の生成はほぼ「サブ側の待ち時間の中に隠れて」終わっている。このポート分離方式では、1枚の画像を2枚のGPUで速くすることはできない。だが2枚の画像なら遅い側の時間で出せる。これがポート分離で実際に手に入るものだ。
--bf16-unet / --bf16-text-enc、サブは --fp8_e4m3fn-unet / --fp8_e4m3fn-text-enc で動いている。この2つは対になる指定ではない。公式の定義では --bf16-unet が「拡散モデルを BF16 で実行する」、--fp8_e4m3fn-unet が「UNet の重みを FP8 で保持する」で、テキストエンコーダ側はどちらも重みの保持形式の指定だ。モデルの dtype まわりの条件がそもそも違うので、ここで読み取れるのは「同じ側の、単独と並列の差」までになる。GPU同士を比べたいなら起動オプションを揃えて測り直す必要があるが、揃えても接続の違い(PCIe x16 と Oculink x4)は残るので、カード単体の比較にはならない。起動オプションを揃えると、2枚の差はどれくらいか
2026-09-03 の測定は、メインが bf16、サブが fp8 という普段そのまま使っている設定のままだった。これだと2枚の秒数を並べてもカードの比較にはならないので、翌日、サブ側の起動オプションをメインと完全に揃えて測り直した。dtype 関連の指定(--bf16-unet / --bf16-text-enc)も --reserve-vram 1.5 もプレビュー無効も同じにして、違うのはポート番号と --cuda-device と出力先だけにしてある。これで残るのはカードそのものと、接続の違い(PCIe x16 と Oculink x4)になる。
| 条件 | RTX 5080 (PCIe x16) |
RTX 5060 Ti (Oculink x4) |
|---|---|---|
| 単独で回す(中央値・5本) | 6.79 秒 | 11.42 秒 |
| 1ステップあたり | 0.226 秒 | 0.381 秒 |
| 単独時のばらつき | 6.22〜6.92 秒 | 11.4〜11.53 秒 |
| 2枚同時に投げる(中央値・5本) | 6.96 秒 | 11.49 秒 |
SDXL・1280×720・30ステップ、各側ウォームアップ1本を捨てて5本ずつ、完了検知は0.25秒ポーリング(計測日 2026-09-04)。
同じ条件で並べると、この構成での差は約 1.68 倍だった(この比自体も走行で動き、4走行では 1.68〜1.79 倍に散る。あとで並べる)。ただしこれは「RTX 5080 と RTX 5060 Ti の性能差」ではなく、この2枚を、この接続で、このワークフローで動かしたときの差だ。サブ側は Oculink x4 にぶら下がっているので、カード単体の比較として読むことはできない。
ただし、Oculink の帯域そのものが生成時間を押し下げているのかは、この測定では切り分けられない。同じ DEG1 で SDXL の2枚並列を測ったeGPUドックのレビュー記事で確認できるのは、2枚を同時に動かしたときの相互干渉が約0.5%に収まったことまでだ(単独 3.83 / 5.71 s/it に対し並列 3.85 / 5.74 s/it)。同じカードを x16 と x4 に挿し替えて比べた測定は当サイトに無いので、上の 1.68 倍のうち接続がどれだけ寄与しているかは分からない。画像生成はモデルを一度読み込めば推論本体が GPU の中で完結する性格なので、接続の幅が影響するとすればロードやモデルの切り替えのほうだろう、というところまでが言える範囲になる。
並列にしたときの変化は、メイン側が +2.5%、サブ側が +0.6%。ただしメイン側は単独で5本回したときですら 6.22〜6.92 秒とばらついていて、その幅のほうが並列との差より大きい。そのうえで条件を変えて測り直すと、起動を確認できた回はいずれもメイン +2.2〜+2.6% と同じ向きに出た(あとで並べる)。向きはそろうが、単独時のばらつきのほうが大きいので、この数字の精度までは主張できない。言えるのは「この測り直しでは +2.2〜+2.6% だった」までだ。
2枚分が終わるまでの時間は、同時に投げると 11.61秒(実測の中央値)。順番に流した場合は単独の中央値を足して 6.79 + 11.42 = 18.21秒で、連続実行そのものは測っていない。比にして約 1.57 倍で、前日の fp8 のときとほぼ同じだった。dtype の設定を揃えても揃えなくても、ポート分離で得られるものは「遅い側の時間で2枚出せる」という一点で変わらない。
同じ設定でも走行ごとに数%動く — この測定で分解できること・できないこと
ここまでの数字を額面どおり読む前に、測定そのものの揺れを押さえておきたい。同じワークフローを、サブ側の設定だけ変えて4回まわした。メインの RTX 5080 は4回とも同じ設定なので、これが揺れの目安になる。4回目は、fp8 の起動オプションとdtype の2つ以外まったく同じにした bf16(--reserve-vram を付けない)で回した。予約VRAMの有無そのものを対照にしてある。
| 走行 | RTX 5060 Ti の dtype |
RTX 5060 Ti の 予約VRAM |
RTX 5080 単独 4回とも同設定 |
RTX 5060 Ti 単独 | 並列時の差 5080 / 5060 Ti |
RTX 5060 Ti のVRAM 常駐 → ピーク |
|---|---|---|---|---|---|---|
| 2026-09-03 ※ | fp8 | なし | 6.55 秒 | 11.48 秒 | -0.8% / -0.2% | 3,600 → 6,032 MiB |
| 2026-09-04 ① | bf16 | 1.5 | 6.79 秒 | 11.42 秒 | +2.5% / +0.6% | 6,820 → 9,252 MiB |
| 2026-09-04 ② | fp8 | なし | 6.56 秒 | 11.7 秒 | +2.6% / +0.1% | 3,588 → 6,020 MiB |
| 2026-09-04 ③ | bf16 | なし | 6.39 秒 | 11.46 秒 | +2.2% / +0.2% | 6,820 → 9,252 MiB |
SDXL・1280×720・30ステップ、各側ウォームアップ1本を捨てて5本ずつ。※ 2026-09-03 の回だけ、すでに起動していた ComfyUI に接続して測っている。そのため起動オプションがこの設定だったかを走行時に確認できていない。9月4日の3走行は ComfyUI を落としてから起動し直し、走行時に確認した。
どこまで読み取れるかは、見たい対象ごとに違う。メイン側は同じ設定でも走行間で 6.39〜6.79 秒(6.3%)動き、しかも1走行の5本の中ですら 3.7〜11.3% ばらついた。一方サブ側は1走行の中では 1.1〜1.5% に収まり、走行間でも同じ fp8 どうしが 11.48 秒と 11.7 秒(1.9%)だった。サブ側の設定を論じるのに、メイン側の揺れを基準にしてはいけない。測っている軸が違う。
並列にしたときの差は、起動を確認できた3走行がそろってメイン +2.2〜+2.6%、サブ +0.1〜+0.6%だった。向きは揃っている。ただし単独で5本回したときのばらつきのほうが大きいので、2%台という数字そのものの精度は主張できない。言えるのは「この3走行では +2.2〜+2.6% だった」までで、それ以上落ちないことを示したわけでも、「まったく落ちない」わけでもない。なお並列のほうが速いという負の値は、この画像の測定ではすでに起動していたインスタンスに接続した回にだけ出ている。ただしこのあと見る動画では、起動から確認した走行でも負に出た。相乗りが原因だとは言えない。
サブ側の dtype はどうか。fp8 の2走行が 11.48 秒と 11.7 秒、bf16 の2走行が 11.42 秒と 11.46 秒。bf16 の2値がどちらも fp8 の2値より下に来ているが、同じ fp8 どうしが 1.9% 離れる測り方では、その並びに意味を持たせられない。この負荷では、どちらが速いかを4走行の比較から読み取ることはできない。(同じ向きの差は残っていて、負荷を上げると分解できる。このあと見る)そもそも --fp8_e4m3fn-unet は重みの保持形式の指定で、行列積そのものを fp8 で回すのは --fast fp8_matrix_mult という別の opt-in(公式が「未検証で品質が落ちうる最適化」と書いているもの)だ。重みを FP8 で保持する指定は、FP8 の行列積を有効にする指定ではない。だから速くなることを前提にはできない、というのが出発点になる。負荷を上げるとここが分解できて、fp8 のほうが 1% 弱遅いところまで見えた(2048×1408 まで負荷を上げた測定)。
いっぽうVRAM のほうは、揺れを大きく超えて再現した。bf16 を --reserve-vram 1.5 ありとなしの両方で測ったところ、常駐 6,820 MiB・ピーク 9,252 MiB が1 MiB も違わなかった。この差に予約VRAMは関与していない。残るのは dtype で、fp8 の常駐 3,588 / 3,600 MiB との開きは約 3,226 MiB。そして生成中に増えた分は、4走行とも 2,432 MiB でぴたりと一致した。差はモデルを載せている常駐分だけに出て、生成そのものが使う量は動いていない。保持形式の指定だという説明と、数字の出方が合う。
最後に、2枚同時のスループットは4走行とも 1.53〜1.57 倍に収まった。ポート分離の実利は、速度が落ちないことではなく、この倍率のほうにある。
負荷を上げるとどうなるか — 速度はむしろ落ち、VRAMだけが3GB浮く
ここまでの測定は SDXL の 1280×720 で、bf16 でもピークは 9,252 MiB。16GB のカード(実際に使えるのは 16,311 MiB)に対して 57% しか使っていない。そもそも余裕がありすぎて、fp8 に落としても浮かせる先が無い条件だった。そこで負荷を上げて測り直す。
ただし載りきらないところまで上げてはいけない。あふれた瞬間に測っているものが「あふれた分をどう逃がすか」に変わってしまい、dtype そのものの差が見えなくなる。狙うのはbf16 で天井に近いが収まっている、fp8 なら同じものが降りてくるという位置だ。モデルもステップ数も sampler も seed もそのままに、解像度だけ 2048×1408(画素で 3.13 倍)に上げた。変わるのは dtype のフラグと画素数だけになる。
| SDXL 2048×1408・30ステップ RTX 5060 Ti 16GB(Oculink x4)単独 |
bf16 | fp8 |
|---|---|---|
| 所要(中央値・ウォームアップ後5本×2走行) | 36.19 / 36.32 秒 | 36.52 / 36.56 秒 |
| 10本すべての範囲 | 36.15〜36.38 秒 | 36.49〜36.61 秒 |
| モデルを載せた時点(常駐) | 6,820 MiB | 3,588 MiB |
| GPU全体のピーク | 14,372 MiB | 11,140 MiB |
| 生成中に増えた分 | 7,552 MiB | 7,552 MiB |
| カードに対する占有 | 88% | 68% |
| 起動オプション | --bf16-unet / --bf16-text-enc |
--fp8_e4m3fn-unet / --fp8_e4m3fn-text-enc |
2つの起動ファイルは dtype の2つ以外まったく同じで、--reserve-vram はどちらにも入れていない。それぞれ ComfyUI を起動し直してから、1本ウォームアップを捨てて5本ずつ測っている(計測日 2026-09-04)。
2走行とも fp8 のほうが遅かった。走行ごとに突き合わせると 36.19 秒に対して 36.52 秒(+0.91%)、36.32 秒に対して 36.56 秒(+0.66%)。10本まとめても bf16 は 36.15〜36.38 秒、fp8 は 36.49〜36.61 秒で範囲がまったく重ならない。ただし差そのものの大きさは、この測り方では 1% 弱としか言えない。完了の検知を 0.25 秒ごとに行っているので、36秒に対して 0.69% の粗さがある。いま見ている差と同じ桁だ。「遅い側に出る」は2走行とも再現したが、「何%遅い」を精密な値として受け取らないでほしい。fp8 のほうが軽いのだから速いはず、という直感とは逆になる。
とはいえこれも、機構から見れば筋は通っている。--fp8_e4m3fn-unet が指定するのは重みをどう保持するかであって、計算そのものの形式ではない。実行時に計算用の形式へ変換したり、追加の処理が挟まったりすることがあるので、そのあたりが差の候補になる(ComfyUI 側には fp8 の演算経路もあり、どの経路を通るかは条件で変わる)。ただし今回の測定は所要時間しか見ていないので、原因までは特定できていない。fp8 のまま行列積を回すのは --fast fp8_matrix_mult という別の指定で、今回は有効にしていない。今回の RTX 5060 Ti・SDXL のこの条件では、2走行とも fp8 側が 1% 弱遅い方向に出た。言えるのはそこまでで、「fp8 なら 1% 遅くなる」という話ではない。
この 1% を見るには、完了の検知を細かくする必要がある。2秒ごとに確認する測り方では bf16 も fp8 も同じ値に潰れて、「差がない」と読めてしまった(実際に一度そう出した)。測っているのは所要そのものではなく「次の確認までの切り上げ」なので、確認の間隔がそのまま分解能になる。ここでは 0.25 秒にしてある。
変わったのは VRAM のほうだ。それも、どこが変わったのかがはっきりしている。モデルを載せた時点で 6,820 MiB と 3,588 MiB、その差 3,232 MiB。ところが生成中に増えた分は、どちらも 7,552 MiB でぴたりと同じだった。ピークの差 3,232 MiB は、最初から最後までこの常駐分の差のままということになる。
軽いほうでも同じ形が出ていた。1280×720 のときの増分は両方とも 2,432 MiB で一致していて、常駐の差はやはり 3,232 MiB。画素を 3.13 倍にしたら増分は 3.11 倍になった、というだけの話で、この2つの解像度で見るかぎり、dtype の差は常駐分にだけ出て、生成中に増えた量は一致した。重みの保持形式の指定だという説明と、数字の出方が合う。
この測定で読み取れたのは、fp8 が買ったのは速度ではなく余裕だった、ということだ。bf16 でカードの 88% を使う負荷でも、fp8 に落として速くはならない。差が出るのは「そのままでは載らない」に踏み込んだときで、そこから先は載せ替えたりCPU側へ逃がしたりの話になり、この記事の本題である「2枚目をどう使うか」と地続きになる。
測ったのは SDXL 1本・カード1枚での話で、モデルが変われば重みの割合も変わる。また fp8 での行列積(--fast fp8_matrix_mult)は有効にしていない。
動画ではどうなるか — 2枚が同時に天井へ張り付く
ここまでは画像の話だった。動画になると前提が変わる。LTX-2 19B(Q4量子化)で 512×320・41フレームを出すと、RTX 5080 で 15,181 MiB、RTX 5060 Ti で 14,820 MiB。それぞれカードの 93% と 91% で、1枚のカードが素の状態でほぼ埋まる。画像で「bf16 で 88% まで使わせた」と書いたが、動画はそこが出発点になる。
| LTX-2 19B Q4・512×320・41フレーム | RTX 5080 (PCIe x16) |
RTX 5060 Ti (Oculink x4) |
|---|---|---|
| 単独で回す(中央値・2走行) | 33.63 / 33.9 秒 | 52.21 / 52.18 秒 |
| 2枚同時に投げたとき | 32.07 / 32.34 秒 | 51.29 / 51.01 秒 |
| GPU全体のピーク | 15,181 / 15,316 MiB | 14,820 MiB |
| カードに対する占有 | 93〜94% | 91% |
| 初回(モデルのロード込み) | 113.09 / 97.23 秒 | 120.04 / 118.47 秒 |
各側でウォームアップを1本捨てて3本ずつ、完了検知は0.25秒。2走行とも ComfyUI を起動し直してから測っている(計測日 2026-09-04)。なお2枚は起動オプションが違う(メインが bf16、サブが fp8)ので、A と B の秒数を GPU の比較として読むことはできない。
2枚分が 51.41 秒と 51.12 秒で終わった。順番に流せば 85.84 秒と 86.08 秒かかる計算で、比にすると 1.67 倍と 1.68 倍。画像のとき(1.53〜1.57倍)より効率がいい。しかも遅いほうのカード1枚で回したとき(52.21 秒)より短い。2枚がそれぞれのVRAMを9割方使っている状態で、である。
1枚あたりの所要も、並列にして遅くなってはいない。むしろ2走行ともメイン側が -4.6%、サブ側が -1.8% と -2.2% で、わずかに速い側に出た。ただしこれを並列のおかげと読むことはできない。並列で回した3本の内訳が [33.57, 32.05, 32.07] と [33.62, 31.95, 32.34] で、1本目だけが単独と同じ値だからだ。並列そのものが理由なら1本目から速くなるはずで、この形は説明できない。動画は初回(モデルのロード込み)の総所要が 97.23〜120.04 秒で、ウォーム後の 2.27〜3.36 倍で、1本捨てただけでは足りていない疑いが残る。ここで言えるのは「2枚同時にしても遅くならない」までで、「速くなる」ではない。
ここまでの秒数は、メインとサブで起動オプションが違うまま並べている。そこで両方を同じ設定にして、ComfyUI を1つだけ立てて測り直した。すると RTX 5080 が 34.79 秒、RTX 5060 Ti が 50.28 秒で、差は 1.45 倍。揃えないまま並べた 1.55 倍より小さい。この2つの測定では、見かけの比が 1.55 倍から 1.45 倍へ動いた。起動条件を揃えない比較には、この程度の差が混ざりうるということだ。ただし2つは走行そのものも別なので、差のすべてが起動条件のせいだとは言えない(同じ RTX 5080 が単独の3本で 3.6% 動いている)。VRAM も揃えたほうが少なく、13,924〜14,020 MiB に収まった。
ついでに、もう1枚の ComfyUI が待機しているかどうかでも測ってみた。RTX 5080 を同じ起動ファイルで回すと、1つだけ立てたときが 34.79 秒、もう1つ待機させたときが 33.63 秒と 33.9 秒。ただし1つだけのときの3本が 34.3〜35.55 秒(3.6%)ばらついており、この差はその範囲に収まる。待機している分の影響は、この測り方では見えない。
動画で2枚目が要るのは、この先だ。1枚で 91% まで埋まるということは、解像度やフレーム数を上げればすぐに載らなくなる。そこから先は、層や重みを別のカードへ逃がす方式の話になる。ここで同じ「2枚で分担する」でも、MultiGPU CFG Split は当てはまらない。あれは2枚目にもモデルが載る方式で、実測でも2枚目のピークが 5,348〜5,380MiB まで上がっており、1枚あたりの必要量は下がらないからだ。ポート分離で稼げるのは「2本を並べて流す」分だけで、1本が載らない問題は、ポートを分けても解決しない。
なお、この2枚の秒数を dtype の比較として読むこともできない。LTX-2 の本体は Q4 の GGUF なので、起動フラグでその保存形式が置き換わるわけではない。ただし「だから起動フラグは無関係」でもない。GGUF のローダーは ComfyUI 本体の読み込み処理をそのまま通しており、そこで呼ばれる dtype の決定処理は --bf16-unet や --fp8_e4m3fn-unet が指定されていればそれを最優先で返す(手元の v0.31.1 で確認)。GGUF は推論時に量子化を解いて計算するので、起動時の指定が実行経路に影響しないとは言い切れない。だからこの2条件は、GPU の比較にも dtype の比較にも使わない。
測り方についてもうひとつ。最初は完了検知を2秒間隔でポーリングして測っていたのだが、それだと所要が2秒刻みに丸まり、メイン側が「並列のほうが20%速い」という、単独時のばらつき(6.39〜6.64秒)では説明できない大きさの値が出た。差そのものが分解能より小さかったためだ。0.25秒間隔で測り直して上の値になった。生成時間が10秒前後の題材では、測定側の刻みが結論の符号をひっくり返す。
マルチGPUノードによる同時処理 ― 上級者向けの選択肢
ComfyUIには、複数GPUを単一ワークフロー内で活用するためのカスタムノードがいくつか公開されている。ただし、現状では「万能な高速化ツール」とは言い難い。
主要なカスタムノードの整理
| ノード | 仕組み | 速度向上 | VRAM 効率 | 速度差ありGPU対応 |
|---|---|---|---|---|
| ComfyUI-MultiGPU | UNet/CLIP/VAE を別GPUに割当(逐次実行) | × | ○ 節約 | △ 影響少 |
| ComfyUI-Distributed | 異なるシードを並列実行/アップスケールはタイルを分散 | ○ スループット向上(アップスケールは1枚も短縮) | × 各GPUにフルコピー | △ 異種GPUも可。差が大きいとボトルネック(load_balance あり) |
| ComfyUI-ParallelAnything | バッチを分割して各GPUに振り分け | ○ バッチ全体短縮 | × 各GPUにフルコピー | △ 異種GPUも可・割合調整推奨 |
ComfyUI-MultiGPUは、UNet・CLIP・VAEといったモデルの各コンポーネントを、どのデバイスに載せるかを選べるようにするノード群。標準のローダーに加えて ControlNet・CLIP Vision・GGUF 系のローダーが用意されている。処理自体は逐次実行で、1枚のGPUにすべてを載せる必要がなくなる分VRAMに余裕が出る、という性格のもの。公式リポジトリも「GPUのVRAMを空ける」「カードの latent space を最大化する」という説明で、1枚あたりの生成を速くするものではない。
コンポーネント単位の割り当てだけでなく、DisTorch という機構でモデルの層そのものを別GPUのVRAMやシステムRAMへ逃がすこともできる。配分はGB指定・比率・デバイス容量に対する割合の3通り。対応は .safetensors と GGUF 量子化モデル全般で、FLUX・SDXL・SD1.5 に加えて LTX Video や WanVideo 2.2 も挙がっている(ComfyUI-MultiGPU 公式リポジトリ・2026-09-03 時点)。ただし層を逃がせば逃がすほど転送が挟まるので、載せるための工夫であって速くするための工夫ではない。当サイトではこのノード自体の実測はしておらず、ここまでは公式リポジトリの記述にもとづく整理だ。
ComfyUI-Distributedは異なるアプローチで、同一ワークフローを複数GPUで並列実行する仕組み。異なるシードで同時に生成できるため、スループットが向上する。この使い方では1枚あたりの速度は変わらず、単位時間あたりの出力枚数が増える。ただしアップスケールだけは別で、Ultimate SD Upscale のタイルを複数のワーカーへ分散する機能があり、こちらはGPU を増やすほど1枚の処理が短くなると公式が説明している(ComfyUI-Distributed 公式リポジトリ・2026-09-04 時点)。タイルごとに分けられる処理だから成り立つ話で、生成そのものを分割しているわけではない。
ComfyUI-ParallelAnythingはバッチを分割して各GPUに振り分けるノード。ただし各GPUにモデルのフルコピーが必要で、VRAM消費は2倍。公式は同一GPUのワークステーション向けを推奨しており、異なるGPUの混在でも動くが、速い側が遅い側を待つ形になる(バッチの配分をパーセンテージで補正する仕組みはある)。
ここまでに挙げた3つのカスタムノードでは、単一のデノイジングステップを2つのGPUで分割できない。ただし「そういう技術が存在しない」わけではなく、方式の違うものが2つある。
- 標準の ComfyUI に入っている「MultiGPU CFG Split」(
advanced/multigpuカテゴリ)
CFG の work unit を複数GPUへ振り分けるノードで、サンプリングを速くすることを狙ったものだ。カスタムノードを入れなくても使える。ただし公式は同型のGPU 2枚を前提としており、当サイトのような別型の組み合わせは対象外にあたる(この構成での結果は MultiGPU CFG Split の節にある)。 - Raylight
XDiT の Unified Sequence Parallelism で画像・動画のテンソルを GPU 間に分割し、FSDP で重みも分割する。ただし公式リポジトリの導入手順は Windows ネイティブでの動作を案内しておらず、WSL を使うよう勧めている。SDXL と SD1.5 では CFG 並列のみの対応で、当サイトでは未検証。
つまり「1枚の生成は2枚では速くできない」と言い切れるかは、方式しだいということになる。このうち手元で試せるのは前者なので、実際に測った。
ただし本記事が勧めるポート分離とは併用できない。ポート分離では各インスタンスを --cuda-device で1枚に絞っているので、そのプロセスからはもう1枚が見えない。2枚を1つの生成に使う方式を試すなら、インスタンスを分けない構成で動かすことになる。
加えて v0.34 以降の Windows では、インスタンスを1つにするだけでは足りない。GPUを選ぶ指定が何も無いと先頭の1枚しか見えないので、起動行に --cuda-device all を足して2枚とも見えている状態にしてから試す。
MultiGPU CFG Split ― 公式は同型2枚が前提。当サイトの異種構成では 1.7 倍近くかかった
先に適用条件を確認しておく。公式のノードドキュメントは「Mixing different GPU types is not supported, the installed GPUs must be the same (ie 2x 5090, or 2x 5080, etc.)」と書いており、対象は「Ampere 以降の同型2枚構成」とされている。ワークフローの CFG が 1 より大きいことも条件で、CFG=1 の蒸留系ワークフローでは効果が出ない。当サイトは RTX 5080 と RTX 5060 Ti という別型の2枚なので、この時点で対象外の構成にあたる。
条件を満たしている環境では速くなる報告がある。公式ドキュメントは「speedups of up to 1.95x have been measured in common workflows」としており、実装を追加したときの GitHub の Pull Request には RTX 4090 2枚と1枚の比較で Wan 1.3B t2v が 1.85倍、Wan 14B t2v が 1.89倍という数字が載っている。いずれも当サイトでは未検証の、他者環境の値だ。同じ PR は逆の注意も書いていて、GPU の負荷が軽い場合(例として RTX 4090 で 512×512 の SD1.5 を1枚生成する場合が挙がっている)は、分割と結合のオーバーヘッドが利得を上回って1枚より遅くなるとしている。
速度差のある2枚しかないケースはどうなるのかという疑問に答えるために、対象外の構成のまま測った。SDXL Base 1.0・1024×1024・20ステップ・euler・cfg 7.0 で、ウォームアップを1本捨てて5回の中央値、条件を並べる順序を入れ替えた2パス。ComfyUI は v0.34.5、外部のカスタムノードは無効化してある。下の4条件は同じスクリプトの1走行で、起動構成もそろえてある(dtype のフラグはどれも指定なし)。2枚目を見せる条件だけが --cuda-device all で、ほかは --cuda-device に番号を渡している。生成時間だけでなく、GPU の使用率も 0.25 秒間隔で採った。
| 起動と設定 | 中央値 (正順 / 逆順) |
2枚目のピーク | 5080 の使用率 | 5060 Ti の使用率 |
|---|---|---|---|---|
RTX 5080 だけ見せる(--cuda-device 0) |
3.895 / 3.915秒 | ― | 平均 85 / 84% | ― |
2枚見せる(--cuda-device all) |
3.924 / 3.914秒 | 114MiB | 平均 85 / 85% | 平均 0% |
| 2枚見せる + MultiGPU CFG Split | 6.633 / 6.538秒 | 5,348〜5,380MiB | 平均 29 / 28% | 平均 52% |
RTX 5060 Ti だけ見せる(--cuda-device 1) |
7.977 / 8.003秒 | 9,572MiB | 平均 0% | 平均 90% |
2026-09-06 計測・ComfyUI v0.34.5・メイン RTX 5080 + サブ RTX 5060 Ti 16GB(OCuLink x4)。中央値と使用率は、いずれも正順 / 逆順の順に並べている(使用率は生成中サンプルの平均)。各条件の開始前に両GPUの空きを確認している。
2枚見せるだけでは、RTX 5080 だけを見せた条件との差が 0.03〜0.74% で、条件内のばらつき(2.7〜5.8%)の内側に収まる。ところが CFG Split を挟むと 正順で 1.703 倍、逆順で 1.670 倍かかった。別の走行でも 1.634〜1.636 倍で、走行をまたいでも向きも桁も変わらない。なお CFG Split の条件だけは条件内の幅が 8.6〜9.4% と大きいが、それでもこの差とは桁が違う。
使用率を見ると、何が起きているかがはっきりする。RTX 5080 だけで回したときの 5080 は平均 84〜85% 使われているのに、CFG Split を挟むと 5080 の平均使用率が 28〜29% まで落ちる。入れ替わりに RTX 5060 Ti が平均 52%(最大 88〜98%)で動いており、2枚目はVRAMを確保しているだけでなく実際に計算している。それでも全体としては遅い。速い側が、遅い側を待って手を止めている状態になる。
同じ走行で RTX 5060 Ti だけを見せた条件は 7.977 / 8.003秒 で、RTX 5080 の約 2.05 倍かかっている。CFG Split の 6.5〜6.6秒 は、速い側の単独(3.9秒)と遅い側の単独(8.0秒)の間に入る。この形になるのは実装どおりでもある。v0.34.5 のスケジューラは条件をデバイス数で割った本数ずつ均等に配るだけで、GPU の速度差を考慮しない。速度比を指定する MultiGPU Options というノードがソースには入っているものの、ノード登録の一覧ではコメントアウトされていて使えず、そのノードの説明自体が「スケジューラは relative_speed を参照しない」と断っている。つまり異種の2枚では、遅いほうが1ステップの時間を決める側になり、現状それを調整する手段が無い。
ただし 6.5〜6.6秒 は「遅い側が半分だけ働いた時間」よりも長い。とはいえ仕事を半分にしたからといって所要も半分になるとは限らない(1回あたりの計算量が減れば、GPUの使い切り方も変わる)ので、この超過分がそのまま同期や転送のコストだとは言えない。毎ステップの同期や2枚の間の転送が乗っている可能性はあるが、その内訳は測っていない。
まとめると、この機能に問題があったのではなく、当サイトの構成が公式の対象外だったということになる。同型2枚を持っているなら上に挙げた他者環境の数字が期待値の目安になるが、それは当サイトでは確かめていない。確かめたのは、速度差のある2枚では、1本の生成を分担させても速くならなかったことのほうだ。同じ型のGPUを2枚積んだ場合や、どちらも x16 で挿さっている場合にどうなるかは測っていない。
当サイトがポート分離方式を採用している理由もここにある。RTX 5080 とサブ側(4月は RTX 4070 Super、現在は RTX 5060 Ti)では処理速度に無視できない差があり、同時処理系のノードを使うと遅い方がボトルネックになってしまう。なお上の 3.83 / 5.71 s/it は解像度もステップ数も揃えずに取った値で、倍率の根拠にはできない。起動オプションまで揃えて測り直した結果は前に示したとおりで、現行の2枚では約 1.68 倍だった。速度差の大きいGPU同士では、独立して動かす方が合理的だ。
VRAMは単純合算できない ― デュアルGPU最大の誤解
「RTX 5080の16GBとRTX 4070 Superの12GBを足して28GBとして使えないのか?」。デュアルGPU構成を検討する際、最も多い誤解がこれだろう。結論として、16GB と 12GB を透過的な 28GB の単一 VRAM プールとして ComfyUI に見せることはできない。各カードの VRAM は物理的に独立していて、標準の ComfyUI には複数GPUを透過的な単一VRAMプールとして扱う仕組みが無いからだ。モデルの層を分けて複数GPUへ置くこと自体は、さきほど挙げたカスタムノードで可能になる。
NVLink / SLI / NVSwitch の整理
NVLink は GPU 間の高帯域相互接続技術で、RTX 3090 / 3090 Tiがコンシューマー向け最後のサポート世代だった(公式仕様表で両方とも Yes)。RTX 40 シリーズ以降は非対応で、RTX 4090 の公式仕様表には「NVIDIA NVLink (SLI-Ready)」の欄に No と明記されている。データセンター向けの製品には NVSwitch という GPU 間の相互接続があり、こちらはコンシューマー製品には降りてこない。ただし NVSwitch 自体は帯域とレイテンシの話で、「複数の VRAM が自動的に1つの巨大な VRAM になる」仕組みではない。単一メモリ空間のように扱える部分は CUDA 側のアドレッシングの機能で、相互接続とは別の層の話だ。
NVIDIA は NVLink を GPU 間の高帯域な相互接続、NVLink Switch をそれらを総当たりで結ぶ仕組みとして説明している(NVIDIA NVLink 公式ページ)。いずれもデータセンター向けの製品で使われるもので、要点は帯域とレイテンシにある。
かつてNVLinkという高帯域GPU間接続がコンシューマー向けにも提供されていた時期があった。RTX 3090 と 3090 Ti がNVLinkをサポートした最後の世代で、RTX 40シリーズ以降は非対応。「SLIでVRAM共有」という話も見かけるが、SLIはゲーム用のフレーム分割技術であり、VRAMを合算する仕組みではない。
当サイトでも実際にRTX 5080のVRAMオフロード先としてRTX 4070 Superを指定しようと試みたが、ComfyUIの仕組み上これは不可能だった。2枚の VRAM を透過的な1つの領域として使うことはできない、ということだ。モデルや層を分けて配置する方法(さきほどの ComfyUI-MultiGPU など)は別にあり、1枚の容量を超えるモデルを動かす手段はある。ただしこれは単一生成のデノイジング演算をGPU間で並列化して速くする方式ではない(CPUへあふれていたものがGPUに載れば結果的に速くなることはある)。実用速度が欲しいなら、そのモデルが収まる VRAM を持つ単一 GPU が素直だ。
例外: Ollamaなら2枚のVRAMへモデルを分散配置できる
標準の ComfyUI では2枚を1つの VRAM プールにできないと書いたが、LLM推論ツールのOllamaはまったく事情が異なる。Ollama は層ごとに分けて配置する方式(llama.cpp でいう layer split。同じ層を複数 GPU で分担するテンソル並列とは別物)で、トランスフォーマーの各層を複数GPUに分散配置できる。データが層を順番に流れていく仕組みで、結果として、1枚には収まらないモデルを2枚のVRAMに分けて載せられる。ただし 16GB + 12GB がまるごとモデルの重みに使えるわけではなく、KVキャッシュや実行用のバッファも同じVRAMから取られる。
この layer split の利点は GPU 間通信を抑えられる点にある。この方式では層とその KV キャッシュをまとめて GPU に振り分け、各 GPU は担当する層の範囲を順に処理する。推論中に GPU 間を渡るのは主に層の境目の中間結果で、同じ層を複数 GPU で分担するテンソル並列に比べると転送量を抑えやすい(llama.cpp 公式 docs/multi-gpu.md。Ollama はこの実装を使っている)。なお Ollama 公式 GPU ドキュメント のほうは、どの GPU を使わせるかの指定方法を扱ったページで、分散の方針までは書かれていない。ただし「Oculink (PCIe x4) のような低帯域接続でも実用範囲に収まるか」は公式が述べている範囲ではなく、当サイトの実測(Ollamaの自動分散を測った記事)で確かめたことだ。
デュアルGPU時の実測ベンチマーク
当サイトの検証環境での計測結果を以下にまとめた。
| モデル | RTX 5080 単体 | デュアルGPU (5080+4070S) | 差分 |
|---|---|---|---|
| Qwen3 8B | 99.15 tok/s | 130.68 tok/s | +32% |
| Gemma3 12B | 85.90 tok/s | 84.47 tok/s | ほぼ同等 |
| Qwen3 32B | 5.69 tok/s(CPU溢れ) | 11.24 tok/s | +97% |
2026年4月・サブGPUが RTX 4070 Super だった頃の計測(i7-14700F / 96GB RAM)。このときのモデルタグと量子化、Ollama のバージョンは記録が残っていないため、9月の測定(条件を明記してある)と同列には比べられない。
Qwen3 8Bはもともと単体GPUに収まるサイズだが、この計測では2枚構成のほうが32%速かった。ただし「2枚にすると帯域が増えるから」という説明は成り立たない。層を分けて2枚に置いても各GPUの内部帯域はそのままで、増えるのは主に載せられる容量のほうだ(2枚のVRAMプールをOCuLink接続で実測した記事で整理している)。1枚に完全に収まるモデルなら、PCIe越しの転送が挟まる分2枚へ広げる意味は薄い。これはOllamaの自動分散を測った記事での整理で、8Bはその側にある。実際、別記事の実測では1枚に収まるモデルだと片方のGPUしか使われず、2枚に分かれたのは1枚に収まらないサイズになってからだった(複数GPUが認識されても使われない時の切り分け)。Qwen3 8B の行についても、両カードへ層が分かれていたかを ollama ps で確かめたわけではない。この+32%が何によるものかは、本記事の計測条件では特定できていない。一方のGemma3 12Bはほぼ変化なしで、1枚に収まるサイズでの2枚構成は、どう出るかが一定しない。
最も劇的な差が出たのはQwen3 32B。RTX 5080単体だとVRAM 16GBに収まりきらず、CPUメモリへのオフロードが発生して5.69 tok/sまで落ち込む。それが2枚構成では 11.24 tok/s とほぼ倍速になった。2枚のVRAMに分かれてオフロードが減ったと考えると出方は合うが、この回は配置を ollama ps で確認しておらず、量子化の記録も残っていないので、実際にどこまでVRAMに載ったかは確かめていない。「VRAMが足りなくてCPUに溢れるモデル」こそがデュアルGPUの恩恵を最も受けるケースだ。
ただし注意点もある。2枚に分ける方式によって、トークン生成とプロンプト処理で出方が変わる。同じ2枚で分割方式を比べた別記事の実測では、プロンプト処理はテンソル並列のほうがレイヤー分割より 14〜16% 遅かった。PCIe 4.0 x4 というリンクの制約と整合する結果だが、その記事も x16 接続との比較はしていないので、低下分をすべて OCuLink に帰属させてはいない。
デュアルGPUが向いているケースと向いていないケース
ここまでの検証結果を踏まえ、デュアルGPU構成の適性を整理する。
向いている用途
ポート分離で別タスクを同時実行する場合。メインGPUで作業しながらサブGPUで画像生成を回す、といった運用には最適。今回測った範囲では互いの処理に目立った干渉は出ておらず、速度差も問題にならなかった。
Ollamaなど LLM推論で大型モデルを動かす場合。単体GPUに収まらないモデルをCPUオフロードなしで動かせるのは大きなメリット。Qwen3 32Bの例で示した通り、CPUオフロード発生時との速度差は顕著だ。
同速度のGPU 2枚で枚数を稼ぎたい場合。同じモデルのGPU 2枚なら、ComfyUI-DistributedやParallelAnythingでバッチ分散が働く。1枚あたりの速度は変わらず、単位時間あたりの枚数が増える形だ。ただし各GPUにモデルのフルコピーが載るため、2枚あっても扱えるモデルのサイズは1枚分のままで、VRAMの節約にはならない。加えて当サイトの環境は速度差のある2枚なので、この「同速度2枚」という条件そのものを実測できていない。
向いていない用途
1枚の画像生成を高速化したい場合。本記事で扱う3つのカスタムノードでは、単一のデノイジングステップをGPU間で分割できない(標準の MultiGPU CFG Split や Raylight のように、別方式で1つの生成を複数GPUへ振るものはある。ただしポート分離とは併用できず、CFG Split は公式が同型2枚を前提としているため、当サイトの別型2枚では速くならなかった=1.7 倍近くかかっている)。なおさきほど書いたとおり、アップスケールについては ComfyUI-Distributed がタイルを分散して1枚を短縮できる。ここで言っているのは生成そのものの話だ。
1つのモデルをVRAM合算で載せたい場合。ComfyUIでGPU間のVRAMを1つの領域としてまとめて扱うことはできない。ただしさきほどのComfyUI-MultiGPUのように、UNet・CLIP・VAEを別々のGPUへ置き分けて1枚あたりの必要量を下げる手は残る(ただし単一生成のデノイジング演算をGPU間で並列化して高速化する方式ではない)。それでも UNet 単体が1枚に載らないなら、実用速度で回すにはより大容量のGPU 1枚に替えるのが素直だ。
速度差の大きいGPU同士で、配分を調整せずに同時処理を狙う場合。ComfyUI-Distributed や ParallelAnything のように2枚で同時に生成させる方式では、そのままだと遅い方のGPUがボトルネックになる。どちらも配分を調整する手段は持っている(前者は空いている側へ回す load_balance、後者はバッチの割合指定)ので、詰まるのは調整しなかった場合の話だ。さきほどの ComfyUI-MultiGPU は逐次実行なので、この意味での足の引っぱり合いは起きない。RTX 5080 + RTX 4070 Superのような組み合わせでは、ポート分離で独立運用した方が総合的な効率は高い。
メインメモリはどれだけ要るか ― 2インスタンスでほぼ2倍
ポート分離は ComfyUI を2つ立てる方式なので、GPUだけでなくメインメモリも2つぶん要る。プロセスが別なので、ComfyUI 側のモデル状態やキャッシュ、Python のオブジェクトは基本的にインスタンスごとに持つ。どのくらい要るのかを測った。
| 状態 | 1インスタンス | 2インスタンス | 倍率 |
|---|---|---|---|
| 起動直後(モデル未ロード) | 945MB | 1,890MB | 2.00 |
| SDXL 常駐後 | 8.9GB | 17.7GB | 1.996 |
| 生成中のピーク | 8.9GB | 17.8GB | 1.998 |
| システム全体の増分 | +9.3GB | +18.1GB | 1.94 |
2026-09-06 計測・ComfyUI v0.34.5・SDXL Base 1.0 / 1024×1024 / 20ステップ・外部カスタムノードは無効。プロセス単位は working set、システム全体は起動前との差。倍率は表に出した丸め後の値ではなく、丸める前の測定値から計算している。i7-14700F / 96GB RAM。
ほぼ2倍だった。モデルを読む前の起動直後から2倍で、SDXL を常駐させても生成中も比率は変わらない。システム全体の増分(+9.3GB と +18.1GB)もプロセスの合計とほぼ一致していて、どちらの条件も ComfyUI を止めれば起動前の水準へ戻った。この条件では、大きなメモリ共有の効果は観測できなかった。ただし working set には DLL のように他のプロセスと物理ページを共有しうる分も含まれるので、2つの working set を足した値がそのまま物理メモリの使用量になるわけではない。それでもシステム全体で見た増分の倍率がほぼ変わらないので、見積もりとしては「2インスタンス立てれば、この条件ではメモリもほぼ2倍」で足りる。
自分の機体で足りるかは、ComfyUI を立てる前のメモリ使用量に、この条件で観測した約18GBを足しても余裕が残るかで見当がつく。タスクマネージャーで先に空きを見ておくのが早い。OS 側にも余裕を残したいので、ちょうど18GB空いていれば足りる、とは考えないほうがいい。当サイトの 96GB では余裕があり、詰まったことはない。
もうひとつ、pinned memory の上限がある。v0.34.5 は Windows で、ホストRAMのうち pinned(ページアウトできない状態)として登録してよい上限を搭載RAMの40%に設定する(MAX_PINNED_MEMORY = ram * 0.40)。手元の96GB機では起動ログに Enabled pinned memory 39229.0 と出た。これは起動時に39GBを確保したという意味ではない。実際の固定は、ホスト側の重みなどをGPUへ渡す過程で必要になった領域に対して順次行われ、上限を超えそうになると、既存の pinned 登録を解除して枠を空ける作りになっている。今回のSDXL条件では、この上限に近づくようなメモリの使い方にはならず、1インスタンス約8.9GBに収まった。上限はプロセスごとに計算されるので2つ立てれば2つぶんあるが、約39GBを2つ分あらかじめ予約するという意味ではなく、実際に固定される量はワークロードとメモリの空きで決まる。固定そのものを切りたい場合は起動オプションに --disable-pinned-memory がある。
32GB の機体なら、2インスタンスぶんの約18GBを引いて残りは14GB前後。ここに Windows と常用アプリが収まるかが分かれ目になる。pinned の上限も搭載量の40%なので、32GB機なら上限は概算で1インスタンスあたり 12.8GB 相当まで下がる。VRAM に載らないモデルを流す構成では、この上限の差が影響する可能性がある。当サイトは 32GB の機体で実際に回してはいないので、ここは実測ではなく引き算の結果として見てほしい。
電力 / 電源構成の考慮
2枚挿す前に詰まりやすいのが、電源とスロットという物理側の条件だ。マザーボードにx16スロットが2本あっても、2本目はチップセット側でレーン数が落ちることが多く、3連ファンのカードは隣のスロットを物理的に塞ぐ。ここを避けたくて外付け(Oculink / eGPU ドック)に逃がすのが本記事の構成で、スロットとレーンの選び方はAI用PCのマザーボードとPCIeレーンの選び方、電源容量の決め方はAI用PCの電源(PSU)選び方にまとめてある。
デュアルGPU 運用でしばしば見落とされるのが電源構成。RTX 5080 の TGP は 360W、サブ側は4月の RTX 4070 Super が 220W、現在の RTX 5060 Ti が 180W。CPU の i7-14700F も最大 219W を消費する仕様のため、定格を足しただけでも 4070 Super 構成で 799W、5060 Ti 構成でも 759W になる。ただしこれは仕様上の最大値を足しただけで、同時にその値が出るという意味ではないし、マザーボードやストレージ、ファンの分も入っていない。実際の同時負荷時のシステム消費電力は本記事では測っていない。
| コンポーネント | 定格電力 | 出典 |
|---|---|---|
| RTX 5080 | 360W (TGP) | NVIDIA 公式仕様 |
| RTX 4070 Super | 220W (TGP) | NVIDIA 公式仕様 |
| RTX 5060 Ti 16GB | 180W (TGP) | NVIDIA 公式仕様 |
| i7-14700F | 219W (Max Turbo Power) | Intel 公式仕様(i7-14700F) |
当サイトの環境では Oculink 接続のサブGPU 用電源を別系統(独立 PSU)にしている。eGPU ドックの MINISFORUM DEG1 が独立した ATX 電源を要求する構造のため、サブ GPU の消費をメイン PSU 側で直接受けずに済むのがこの構成の利点だ。ただし分けられるのは PSU から先の負荷で、コンセントから先の AC 側や筐体まわりの熱まで独立するわけではない。デュアル PSU 構成は配線の手間こそ増えるが、長時間の生成タスクで PSU が温度上昇しても片側で吸収できるため、熱マージンに余裕が出る。単一 PSU で組む場合は、両 GPU + CPU の合計に対して 1000W クラスが出発点の目安になる。ただし 80PLUS は変換効率の認証で、過渡応答や 12V 系の出力品質、コネクタ実装の質までを保証するものではない。発熱と効率の面で Gold 以上を選ぶのは妥当だが、あわせて ATX 3.x 対応かどうかと、GPU 側が案内している推奨電源容量も確認しておきたい。
具体的な電源例として、 当サイトでは DEG1 用に Thermaltake TOUGHPOWER GT 750W を使用している。 サブ GPU が RTX 4070 Super クラスなら 600〜750W で十分余裕があり、 容量を盛りすぎる必要はない。
ちなみに「DEG1 = サブ GPU 用の小規模電源」 という前提は外して考えてもよい。 既存 PC の構成変更が予算的に難しい場合、 あえて DEG1 側に RTX 5090 等のハイエンド GPU を載せて運用する選択肢もある。 メイン PC の PSU やケースに手を入れず、 Oculink 経由で別系統に高 TGP GPU を増設する形になるため、 メイン PSU 側の容量問題は発生しない。ただし容量の要求が DEG1 側の PSU に移るだけなので、上の 600〜750W はあくまで 4070 Super クラスを前提にした数字だ。より TGP の高い GPU を載せるなら、DEG1 側の電源もそれに合わせて見直す。 重い生成タスクをやる日だけ DEG1 側を通電して起動し、 日常のブラウジングや軽作業の日はメイン GPU だけで回す。そうすればハイエンド GPU のアイドル消費 (数十W 程度。画面構成や電源プランで変わる) を常時抱えずに済む。ただし OCuLink はホットプラグに対応していない。ドックの製品マニュアルも、ケーブルの着脱はホスト側の電源を落としてから行うよう案内している(通電中に抜き差ししたり強制的に電源を落としたりするとポートを傷めうる)。入切するなら起動前・シャットダウン後にする。 PCIe x16 直結で常時通電している場合と比べ、 トータルの電気代と発熱の両面で抑えやすい。
まとめ
ComfyUIのデュアルGPU運用は、「ポート分離で独立した2つの生成環境を手に入れる」のが最も現実的な活用法だ。ポートを分けるだけでは足りず、各インスタンスにどのGPUを使わせるかを起動時に指定する(指定しないと2つとも同じカードに載る)。本記事で主に比較した3つのカスタムノードとポート分離の範囲では、VRAM の透過的な単純合算も、単一生成のデノイジング演算をGPU間で並列化して高速化することもできない。演算のほうは、標準の MultiGPU CFG Split や Raylight のように別方式の実装がある。ただし MultiGPU CFG Split は公式が同型2枚を前提としており、当サイトのような別型の2枚では速くならず 1.7 倍近くかかった。いずれもポート分離とは併用できない。速度差のあるGPU同士なら、無理に同時処理を狙うより別々のタスクを投げる方が合理的。
一方でOllamaのようなLLM推論では話が違い、layer split(層分散)でモデルを2枚のVRAMへ分けて置ける。用途によってデュアルGPUの価値は大きく変わるため、「何をやりたいのか」を先に明確にしてから構成を検討すべきだ。大規模モデルを1枚のGPUに載せたいだけなら、2枚構成に投資するより大容量VRAM搭載の単一GPU購入を勧める。
当サイトで使用しているeGPUドック(MINISFORUM DEG1)については別記事で詳しくレビューしている。Oculink接続の実測データや設置環境の写真も掲載しているので、外付けGPU環境に興味がある方は参照してほしい。MINISFORUM DEG1レビュー
トラブルシュート FAQ
Q1: ComfyUI 起動時に「No CUDA device available」エラー
--cuda-device に、その環境に存在しない番号を渡している可能性が高い。現行の ComfyUI では --cuda-device に番号を渡すと「使うデバイスの指定」と「他を見えなくする」を兼ねる動きになるので、環境変数と番号を二重に合わせる必要はない。2枚構成なら 0 か 1 のどちらかで、どちらが物理的にどのカードかは列挙順で変わる。CUDA_DEVICE_ORDER=PCI_BUS_ID を先に設定したうえで nvidia-smi と突き合わせるのが早い。古い記事や設定例で CUDA_VISIBLE_DEVICES を併用しているものを見かけるが、--cuda-device に番号を渡している限り、同時に指定してもそちらに上書きされる。
Q2: 片方の GPU だけ生成速度が極端に遅い
まず「1ステップあたり(s/it)が遅い」のか「1枚出るまでの総時間が長い」のかを分ける。モデルが VRAM に収まっていて、生成中に CPU へのオフロードや大きなホスト転送が起きていない条件なら、s/it に対して PCIe の幅は支配的な要因になりにくい。生成中の処理が GPU 内で完結する部分が大半だからだ。この条件では、GPU そのものの性能差、VRAM 不足によるオフロード、電力や温度によるクロック制限を先に疑う。逆に、VRAM に載りきらず毎ステップ CPU 側とやり取りしている場合や、GPU 間で転送が発生する方式を使っている場合は、幅が速度を左右する。総時間だけが長いなら、生成本体の外側(モデルのロード、生成ごとの入れ替え、前処理)を疑う。M.2 経由の Oculink は PCIe x4 接続になるケースが大半で、ロードや切り替えで秒単位の差が出やすいのは確かだが、当サイトは同じカードを x16 と x4 で比べていないので、どれだけが幅の影響かは切り分けられていない。VRAM 不足で毎回モデルを載せ直している場合も、同じように総時間だけが伸びる。NVIDIA 公式の CUDA 開発者向けドキュメント でも PCIe 帯域とホスト・デバイス転送の影響は議論されている。
なお、Ollama のように1つのプロセスで2枚を同時に使う想定のツールで「2枚目がそもそも使われていない」場合は、切り分ける層が違う(本記事が勧めるポート分離では、各インスタンスに1枚ずつしか見せないのが設計どおりなので、1枚しか見えないこと自体は異常ではない)。nvidia-smi に2枚並んでいても、ソフト側がその2枚目を使う候補に入れるかは別の判断で、システム全体の CUDA_VISIBLE_DEVICES が片方だけを指していると、明示的に両方を渡さない限り1枚しか見えない。環境変数を立てていない場合も同じ結果になりうる。ComfyUI は v0.34 以降の Windows では、GPUを選ぶ指定が何も無いと自分で CUDA_VISIBLE_DEVICES を 0 に設定するからだ。この分岐は警告を出さないので、/system_stats の devices が何件あるかで確かめるのが早い。手順は複数GPUが認識されても使われない時の切り分けに、OS・ドライバ層 → ランタイムの候補選定層 → モデル配置層の順でまとめた。
Q3: ブラウザでサブ GPU 側のタブが応答しない
--port 8189 の指定漏れか、Windows ファイアウォールでブロックされている可能性。netstat -ano | findstr 8189 で LISTEN 状態を確認、見当たらなければ起動オプションを再確認する。サブGPU側のコマンドプロンプトに「To see the GUI go to: http://127.0.0.1:8189」の行が出ていれば正常に listen している。
Q4: Ollama でモデルを片方の GPU だけに固定したい
特定の 1 枚に固定したい場合は、環境変数 CUDA_VISIBLE_DEVICES で Ollama に見せる GPU を絞る(例: set CUDA_VISIBLE_DEVICES=0 なら 0 番だけを使う)。ただし公式は、番号は並び順が変わりうるので UUID のほうが確実だとしている。固定して運用するなら nvidia-smi -L で UUID を調べ、番号の代わりにそれを渡すほうがよい。ここは ComfyUI と事情が違う。ComfyUI 側は --cuda-device に番号を渡せばこの環境変数を上書きするので指定そのものが要らなかったが、Ollama は公式ドキュメントが環境変数での絞り込みを案内している。サーバ起動前に設定するか、systemd 経由なら override.conf に記載する。なお num_gpu は「どの GPU か」ではなく「何層を GPU に載せるか(オフロード深度)」の指定で、GPU の固定とは別物だ。これは API リクエストや Modelfile 側のパラメータであって、サーバの環境変数ではない(現行の ollama serve --help が並べる環境変数一覧に OLLAMA_NUM_GPU は無い)。配置は ollama ps で確認できる。詳細は Ollama FAQ に記載がある。Windows 環境では setx ではなく現在のシェルで set コマンドを使う方が即時反映されやすい。
Q5: 2枚を同時に回している最中にメインGPU側だけ突然落ちる
電源の単一 PSU 構成で容量不足の可能性がある。GPU-Z や HWiNFO64 で GPU と CPU の消費電力を読み、周辺分を上乗せした概算を PSU の定格と比べる(これらのツールは PSU の負荷率そのものは出せないので、正確に見たいならワットチェッカーか電力モニタ付き PSU が要る)。定格に近い負荷を continuous で流すほど温度とファン回転が上がり余裕が減るので、GPU 2枚構成で瞬間的なスパイクが乗ることも見込んで容量を選ぶ。容量不足が疑われる場合は PSU 増設または上位モデルへの交換を検討する。デュアル PSU で系統分離するのも合理的な選択肢。
Q6: 2026 年に新規購入するならサブ GPU は RTX 5060 Ti 16GB と RTX 4070 Super どちらが良いか?
新規購入なら RTX 5060 Ti 16GB が現実解。 VRAM 容量 (16GB vs 12GB) と消費電力 (180W vs 220W) の両面で優位だ。 4070 Super は世代落ちで新品の流通が薄くなっており、 比較するとしたら中古相場との比較になる。 一方で、 両方の VRAM に収まる小〜中型モデルでは、 4070 Super のほうがメモリ帯域 (504GB/s 対 448GB/s) と CUDA コア数 (7,168 対 4,608) で上回る。 ただし世代が違うので、 この2つの数字だけでどちらが速いかは決まらない。 当サイトは同じ条件で両者を並べて測っていないので、 実際にどちらが速いかは示せない。 ただし 12GB を超える大型モデルでは 4070 Super 側でオフロードが発生して逆に遅くなるため、 大型モデル前提なら 16GB の 5060 Ti が有利だ。 用途次第ではあるが「これから組むなら」 という前提では 5060 Ti 16GB を推奨。
Q7: Oculink x4 と PCIe x16 で生成速度に体感差はあるか?
モデルが VRAM に収まり、ホストとの転送が少ない画像生成 (SDXL / Flux) では、PCIe 幅の影響は小さくなりやすい。 生成中の主要負荷が VRAM ↔ GPU コアの内部演算で、 GPU ↔ CPU の帯域が支配要因になりにくいためだ。 ただし LLM (大型モデルのロード時) や、 重い ControlNet で大容量の preprocessor を CPU 側から渡す処理では Oculink x4 (本構成で使っている MINISFORUM DEG1 では PCIe 4.0 x4 相当) で待ち時間が伸びる。 ロード時間や前処理を含む total ワークフローで秒単位の差は出るが、 モデルが VRAM に載りきっていてホストとの転送が少ないワークフローなら、1 ステップあたりの生成時間への影響は小さくなりやすい。ただし本記事の表は x16 と x4 を同条件で比べたものではないので、ここから幅の因果を断定はできない。
この記事で扱ったGPU・電源をAmazonで探す
| 製品 | 概要 | 価格目安 |
|---|---|---|
| RTX 5080 | NVIDIA GeForce RTX 5080 16GB GDDR7(本記事のメインGPU) | ¥220,000前後 (実勢価格・2026年6月時点) |
| RTX 4070 Super | NVIDIA GeForce RTX 4070 Super 12GB GDDR6X(2026年4月の実測構成のサブGPU) | ¥90,000〜(中古相場) |
| RTX 5060 Ti 16GB | NVIDIA GeForce RTX 5060 Ti 16GB GDDR7(2026年9月の測り直しで使ったサブGPU / これから組む場合の推奨) | ¥95,000前後 (実勢価格・2026年6月時点) |
| 1000W電源 | 80PLUS Gold認証 ATX電源(デュアルGPU構成向け) | ¥20,000〜 |
※価格は2026年6月時点の主要ブランド在庫品の実勢価格(出典: 価格.com 売れ筋ランキング・gazlog GPU価格チャート)。GDDR7・メモリ高騰で相場変動が大きいため、最新は各リンク先でご確認ください。
グラボ単体を探すならここで挙げた RTX 5080 / RTX 5060 Ti 16GB を含め、8GB から 32GB まで ASUS・MSI・GIGABYTE などの実際の型番ごとに絞り込めます。長さ・厚み・スロット・補助電源も出しているので、2枚目がケースに収まるかと電源が足りるかを型番の単位で確かめられます。
関連記事
ハードウェア・ComfyUI 技術
- ComfyUI推奨スペック実測ガイド|VRAM 8・12・16GBとメモリ・CPU ─ VRAM 容量別に動かせるモデルを実測整理
- MINISFORUM DEG1 OCuLink eGPUドック実機レビュー|RTX 4070 Superで半年運用したAI推論帯域実測 ─ 本記事で使用している eGPU ドックの単独レビュー
- RTX 4070 Super vs RTX 5060 Ti 16GB|VRAM 12GB vs 16GBのLLM実測比較 ─ サブ GPU 選定の判定軸
- LTX 1をComfyUIで動かすノード構成の全体像|スクリーンショットで見る基本ワークフロー ─ ComfyUI ワークフローの具体的構築例
AI 自動化 ハブ
- 量産型AI自動化の4層構造 ─ ストックフォト動画系で動かしている中身 ─ ComfyUI を量産パイプラインに組み込む全体像
- マルチモーダル検品とは何か ─ 単一視点では見抜けない欠陥を、複数モダリティで重ね合わせる ─ 生成物の品質チェック設計
参考資料
- ComfyUI 公式リポジトリ: comfy/cli_args.py 起動オプション仕様
- NVIDIA 公式: Ampere GPU Architecture Tuning Guide (BF16 Tensor Core サポート)
- NVIDIA 公式: CUDA Programming Guide「CUDA Environment Variables」(CUDA_VISIBLE_DEVICES / CUDA_DEVICE_ORDER)
- NVIDIA 公式: NVLink / NVSwitch 技術ページ
- Ollama 公式ドキュメント: GPU / Multi-GPU の項
本記事は AIハードウェア図鑑 が記載時点の情報をもとに執筆。製品アップデートや第三者ベンチマーク・価格・対応ランタイム等の変動で評価が変わる可能性がある。一定期間経過した内容は再検証を推奨する。
当サイトはAmazonアソシエイト・プログラムの参加者です。Amazonのアソシエイトとして、当サイトは適格販売により収入を得ています。本記事には各種アフィリエイトリンク(広告)を含み、リンク経由で購入されると当サイトに紹介料が入ります。読者の購入価格は変わりません。