この記事の要点
2ステップ LoRA は RTX 5080 と RTX 5060 Ti で動き、1枚あたりの時間は6ステップの4〜6割になる。
ただし量子化した本体に当てた2ステップの画像は、縮めずに見ると格子状の模様が出た。6ステップで作った画像では、同じ見方で1枚も数えなかった。
プロンプトからどんな画像になるかを確かめる下見は2ステップ LoRA、最終的に使う1枚は LoRA を外し、公式テンプレートの6ステップに戻して作る、という使い分けになる。
初めて読む場合は「2ステップLoRAを使う場面と、6ステップに戻す場面」まで読めば判断できる。使ったソフトのバージョン、プロンプト、時間の測り方、模様の数え方は「測定の条件と測っていないこと」にまとめた。
2ステップLoRAを使う場面と、6ステップに戻す場面
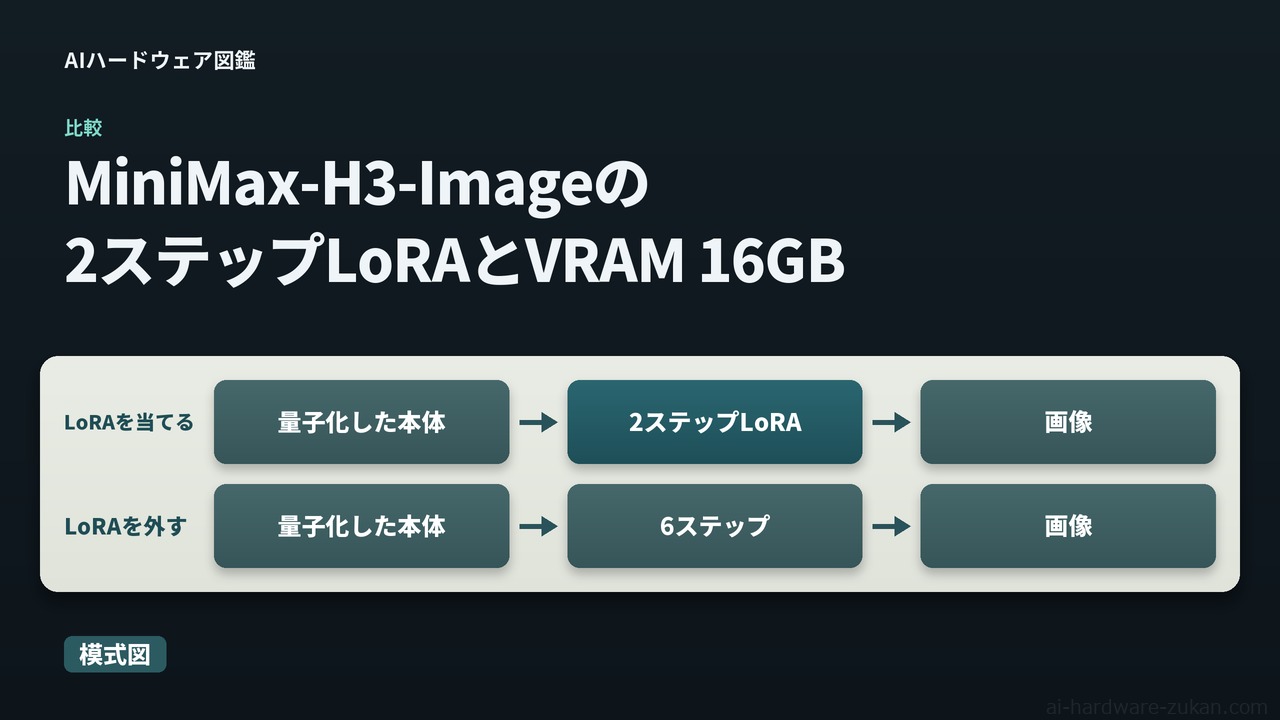
2ステップ LoRA は、VRAM が16GBの RTX 5080 と RTX 5060 Ti で動き、2048×2048 の1枚あたりの時間は6ステップの5〜6割になった。2ステップ LoRA は、本体に足して、6回の計算を2回に減らすための追加の重みである。VRAM は、GPUに載っている専用のメモリ。モデルの重みや計算途中のデータを置く。
ただし、16GBの GPU で動いた量子化した本体の w4a8 と int8 に当てると、2ステップの画像には等倍で見て格子状の模様が出た。量子化は、重みを少ないビット数で持ち、ファイルと VRAM の使用を小さくしたもの。等倍は、画像を縮めずに、1画素を画面の1画素で表示することを指す。そのため、2ステップ LoRA はプロンプトからどんな画像になるかを確かめる下見に使い、最終的に使う1枚は LoRA を外し、公式テンプレートの6ステップに戻して作る、という使い分けになる。
場面ごとの設定と、その理由になった測定の結果は次のとおり。
| 場面 | 設定 | 理由 |
|---|---|---|
| プロンプトからどんな画像になるかを確かめる下見 | 2ステップ LoRA | 1枚あたりの時間が6ステップの5〜6割 (2048×2048) |
| 最終的に使う1枚を作る | LoRA を外し、公式テンプレートの6ステップに戻す | 6ステップの画像では、格子状の模様が34枚のうち0枚 |
| LoRA を入れたまま模様を減らしたい | LoRA のまま4ステップ | 格子状の模様が4枚のうち0枚。サンプリングの時間は6ステップに近づく (参考値) |
時間は RTX 5080 と RTX 5060 Ti の両方で、w4a8 と int8 の本体を使い、正方形の 2048×2048 と 4096×4096 で測った。模様は RTX 5080 で作った画像だけを数えた。時間の縮み方は本体で違い、2048×2048 では w4a8 が6ステップの5割台、int8 が約6割だった。
同じ seed でも、6ステップと2ステップ LoRA では同じ画像にならなかった。下見で選んだ seed の構図が、6ステップでそのまま出るわけではない。同じ起動のまま LoRA を付け外ししたときの切り替えの時間は測っていない。4ステップの行は4枚だけの結果で、時間は別の処理が動いていた間の参考値である。
この記事の「6ステップ」は、ComfyUI の公式テンプレートの設定を指す。配布ページのワークフローから LoRA だけを外して6ステップにした場合は測っていない。
2ステップLoRAの中身と、16GBのGPUで使える入れ方
MiniMax-H3-Image の本体は、6ステップで作るように蒸留されている。この記事で扱う pDMD の2ステップ LoRA は、第三者が Hugging Face の配布ページ(akhaliq/minimax-h3-image-pdmd-2step)で配っている、2回の計算で画像を仕上げるための LoRA である。MiniMax の公式の配布物ではない。
LoRA は Apache-2.0 で配られているが、本体と作った画像の利用には MiniMax-H3-Image Community License Agreement の条件がかかる。このライセンスの「対象の地域」からは、EU・英国・韓国・米国が除かれている。作った画像を、この対象の地域の外で使うことも認めていない。利用する本人か関連会社の年換算の売上が100万米ドルを超える場合や、モデルを動かしてその機能を第三者に提供するサービス(Hosted Service)を提供する場合は、MiniMax から事前に書面の許可を得るよう定めている。使う前に公式のライセンスを確認する必要がある。
配布物は2通りあり、量子化した本体では LoRA を当てる入れ方だけ
配布物には、LoRA を焼き込んだ1ファイル(minimax_h3_image_pdmd_2step_bf16.safetensors・約40GB)と、手元の本体に当てる LoRA(minimax_h3_pdmd_2nfe_comfyui.safetensors・約2GB)がある。配布ページは、int8_convrot と w4a8 の量子化した本体では、LoRA を当てる入れ方だけが使えると書いている。この記事で「int8」と書くのは、ファイル名では int8_convrot の本体のことである。約40GB の1ファイルは、VRAM 16GB の GPU では測っていない。
本体(w4a8 と int8)やテキストエンコーダーのファイルをまだ置いていない場合は、置き場所と本体の選び方を「MiniMax-H3-ImageをVRAM 16GBで動かす|RTX 5080・5060 Ti実測と本体の選び方」にまとめている。
LoRA のノードの位置と設定
配布ページの手順では、LoraLoaderModelOnly を本体の読み込み(Load Diffusion Model)と MiniMaxH3SigmaShift の間に入れる。手順にある値は次の表のとおり。
| 項目 | 配布ページの手順の値 |
|---|---|
| LoRA を読み込むノード | LoraLoaderModelOnly |
| ノードの位置 | Load Diffusion Model と MiniMaxH3SigmaShift の間 |
| LoRA の強さ | 1.0 |
| サンプラー | euler |
| スケジューラー | simple |
| ステップ | 2 |
| shift_video | 12 |
配布ページは、LoRA を入れた ComfyUI 用のワークフロー(minimax-h3-image-pdmd-2step-lora-t2i.json)も配っている。2ステップ LoRA の測定は、このワークフローのサンプリングの設定をそのまま使い、本体には w4a8 か int8、テキストエンコーダーには nvfp4_awq のファイルを指定して行った。プロンプト・seed・画像の大きさは、この記事の条件に合わせた。6ステップは公式テンプレートで測った。
配布ページの動作確認は bf16 の本体で行われている
配布ページの ComfyUI の節が動作確認として書いているのは、bf16 の本体を H200 という GPU で動かした結果で、2048×2048 で1枚約20秒とある。この記事は、量子化した本体と VRAM 16GB の GPU で測った。条件が違うので、配布ページの結果と、この記事の時間や画像の結果は同じ条件の比較にならない。
仕上げ用の detail pass
配布ページには、半分の大きさで2ステップの下書きを作り、拡大してから3ステップで描き足す detail pass という手順と、そのワークフローも載っている。この記事では detail pass を測っていない。
1枚あたりの時間は6ステップの4〜6割になった
2048×2048 では、RTX 5080 と RTX 5060 Ti のどちらでも、w4a8 と int8 のどちらでも、2ステップ LoRA のほうが1枚あたりの時間が短かった。値は、人物の主題1つで seed だけを変えて4枚続けて作り、2枚目以降3枚の中央値をとったもの。1枚目はモデルの読み込みが入るので長い。
GPU と本体の組み合わせごとに6ステップと2ステップ LoRA の時間を並べたのが「2048×2048 の時間の表」である。「6ステップ」は LoRA なしの公式テンプレートの設定、「2ステップ LoRA」は配布ページのワークフローで minimax_h3_pdmd_2nfe_comfyui.safetensors を強さ 1.0 で当てたもの。サンプリングの時間は、サンプラーのノードが動き始めたという知らせを受けた時点から、次のノードの知らせを受けた時点までの間隔を、測定する側で計ったものである。ステップの計算だけを切り出した時間ではなく、ノードの中の準備や知らせの遅れも入る。
| 構成 | 1枚あたりの時間 | うちサンプリングの時間 |
|---|---|---|
| RTX 5080・w4a8・6ステップ | 6.16秒 | 4.46秒 |
| RTX 5080・w4a8・2ステップ LoRA | 3.33秒 | 1.65秒 |
| RTX 5080・int8・6ステップ | 6.36秒 | 4.50秒 |
| RTX 5080・int8・2ステップ LoRA | 4.09秒 | 2.31秒 |
| RTX 5060 Ti・w4a8・6ステップ | 11.44秒 | 9.25秒 |
| RTX 5060 Ti・w4a8・2ステップ LoRA | 6.40秒 | 3.29秒 |
| RTX 5060 Ti・int8・6ステップ | 11.63秒 | 9.41秒 |
| RTX 5060 Ti・int8・2ステップ LoRA | 6.90秒 | 4.79秒 |
主題1つ・seed 3つぶんの中央値である。プロンプトを書き換えた直後の1枚と、ComfyUI を起動して最初の1枚は入っていない。
w4a8 では、RTX 5080 で 6.16秒が 3.33秒、RTX 5060 Ti で 11.44秒が 6.40秒になり、6ステップの 54%と 56%だった。int8 は、RTX 5080 で 6.36秒が 4.09秒 (64%)、RTX 5060 Ti で 11.63秒が 6.90秒 (59%) で、どちらの GPU でも w4a8 より縮み方が小さかった。2ステップ LoRA を当てた RTX 5060 Ti は、LoRA なしの RTX 5080 に近い時間で1枚を作れた。
RTX 5060 Ti の w4a8・2ステップ LoRA と int8・6ステップの行は、測り直した値である。経緯は「測定の条件と測っていないこと」に書いた。
4096×4096 でも2ステップ LoRA のほうが短かった
4096×4096 で同じように作ったときの時間は次の表のとおり。こちらも人物の主題1つで、2枚目以降3枚の中央値である。
| GPU | 本体 | 6ステップ | 2ステップ LoRA |
|---|---|---|---|
| RTX 5080 | w4a8 | 30.49秒 | 13.68秒 |
| RTX 5080 | int8 | 28.44秒 | 16.57秒 |
| RTX 5060 Ti | w4a8 | 51.85秒 | 21.42秒 |
| RTX 5060 Ti | int8 | 60.67秒 | 27.14秒 |
RTX 5080 の w4a8 では 30.49秒が 13.68秒、RTX 5060 Ti の w4a8 では 51.85秒が 21.42秒になり、大きい画像でも4つの組み合わせすべてで短くなった。6ステップに対する割合は 41〜58%だった。RTX 5080 の int8 は回ごとの幅が大きく、6ステップで 27.74〜35.34秒、2ステップ LoRA で 15.24〜21.73秒だった。この組み合わせの中央値は、ほかの行より振れやすい値として読む必要がある。
ステップ数ほどには1枚あたりの時間が縮まない
ステップは6から2に減るが、1枚あたりの時間はその割合ほどは縮まない。1枚あたりの時間には、画像への復元や保存といったサンプリング以外の時間が含まれる。RTX 5080 の w4a8 では、サンプリングの時間が 4.46秒から 1.65秒に縮んだ。
次に、1枚ごとに、1枚あたりの時間からサンプリングの時間を引いて「残り」を出し、その中央値をとった。「残り」には、画像への復元や保存のほかに、完了の確認や GPU の監視の処理の時間も入っている。2枚目以降は、プロンプトが同じでテキストの処理の結果が使い回されるので、テキストの処理の時間は入っていない。
RTX 5080 の w4a8 では、残りは6ステップが約1.7秒、2ステップ LoRA が約1.6秒で、近かった。RTX 5080 の int8 は、6ステップも2ステップ LoRA も約1.7秒だった。RTX 5060 Ti の int8 は、どちらも約2.1秒だった。RTX 5060 Ti の w4a8 だけは、6ステップの約2.2秒が、2ステップ LoRA では約2.9秒に増えた。この増え方の理由は切り分けていない。
int8 では、サンプリングの時間そのものの縮み方が小さく、RTX 5080 で 4.50秒が 2.31秒だった。int8 で縮み方が小さい理由は切り分けていない。
LoRA を外して2ステップにしただけの場合
RTX 5080・w4a8・2048×2048 で、LoRA を外して本体だけで2ステップにした4枚(人物2枚と商品2枚)も作った。2枚目以降の3枚の1枚あたりの時間の中央値は 3.67秒だが、この3枚にはプロンプトを書き換えた直後の1枚(9.65秒)が入っている。同じプロンプトで続けた3枚から出した2ステップ LoRA の 3.33秒とは数え方が違うので、時間の比較には使わない。
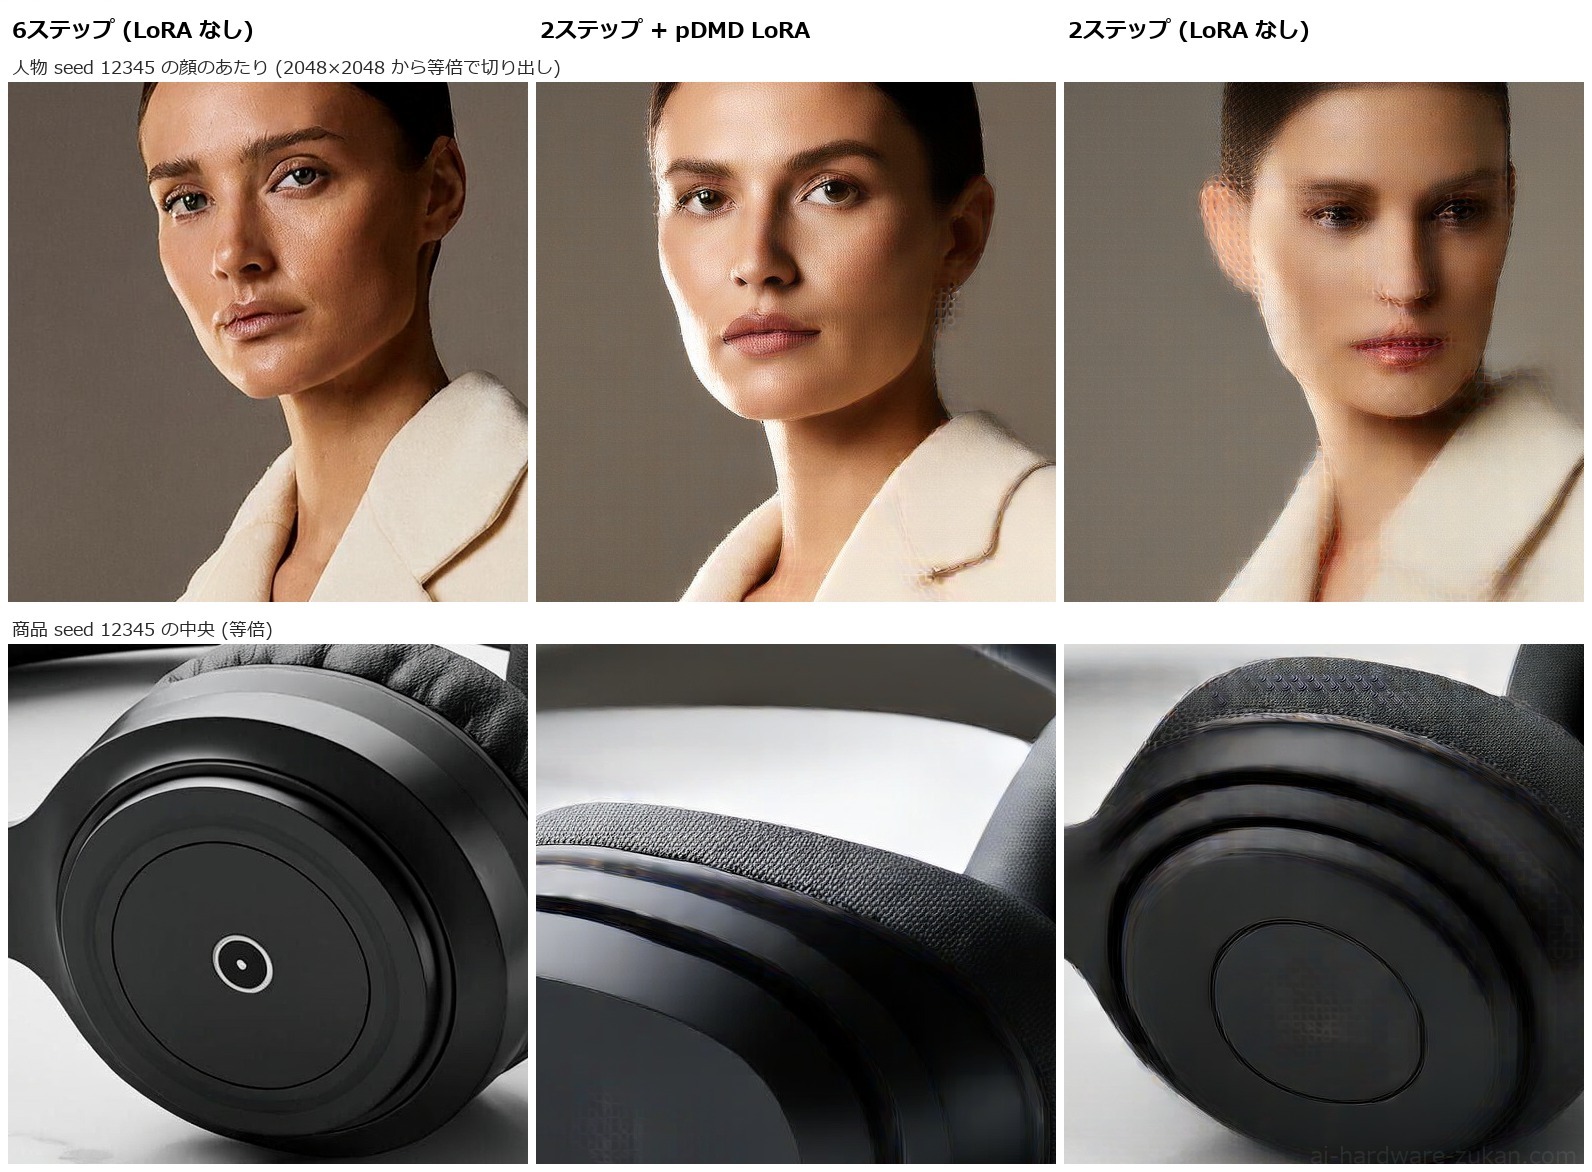
LoRA なしの2ステップの4枚は、人物の2枚で全体の輪郭のぼやけと顔の輪郭の崩れを数え、商品の2枚では数えなかった。同じ主題と seed で LoRA を当てた2ステップの4枚は、形の崩れを数えたのが人物の2枚で、商品の2枚では数えなかった。輪郭のぼやけは、LoRA を当てたこの4枚では数えなかった。数えたのは崩れやぼやけがあるかどうかだけで、LoRA の有無で崩れの程度が変わるかは、この結果からは言えない。
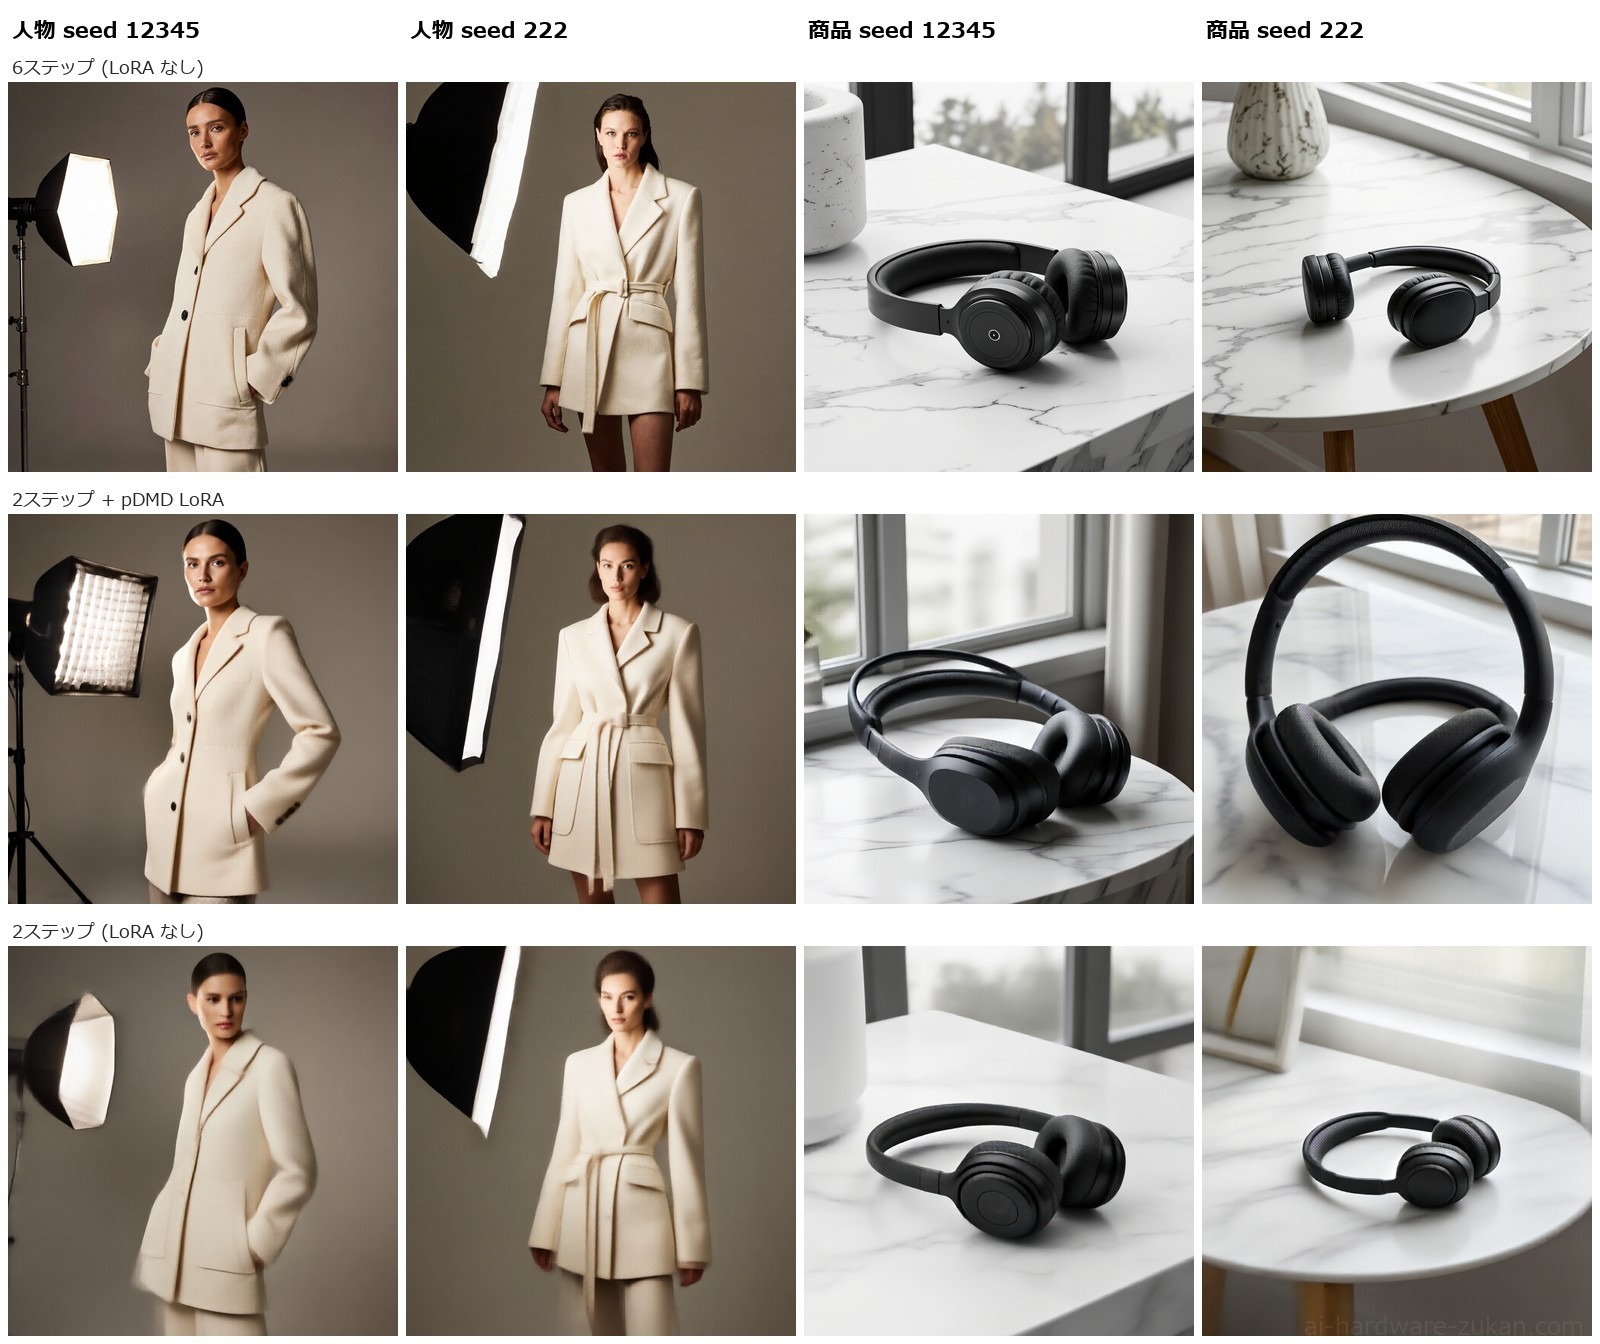
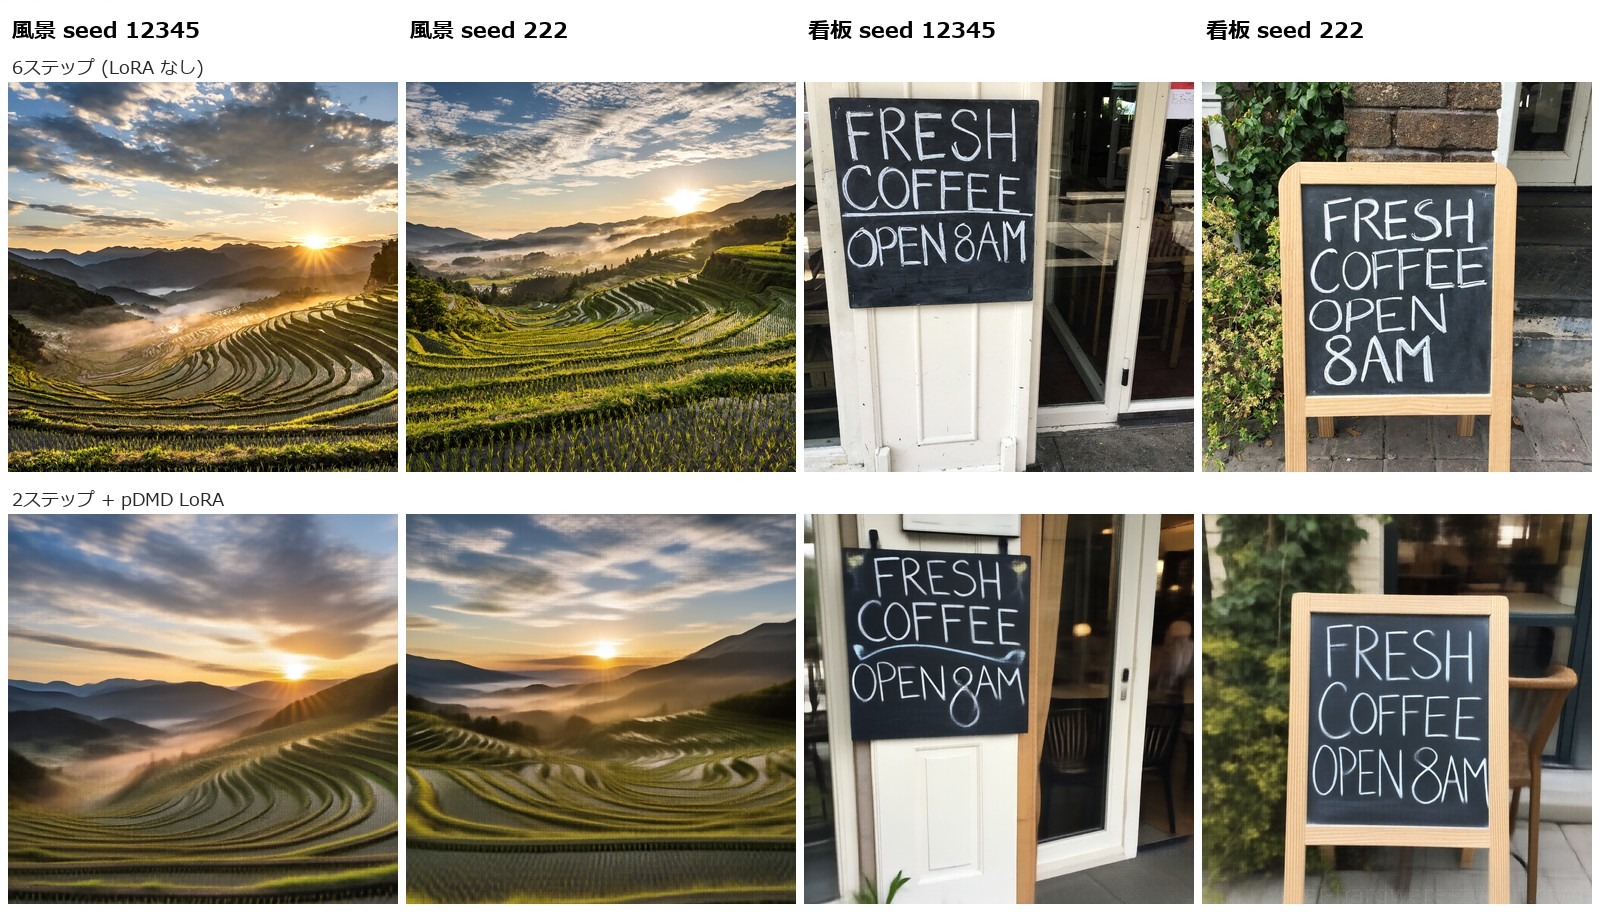
掲載した人物と商品の画像では、同じ seed でも6ステップと2ステップ LoRA で同じ画像にならなかった。人物は大まかな配置が近く、顔や上着の細部が違った。商品は、seed 222 でヘッドホンの置き方が変わった。
VRAMのピークは変わらず、共有GPUメモリの使用は1枚目に増えた
VRAM のピークは LoRA の有無でほとんど変わらず、RTX 5080 で 15,441〜15,497MiB、RTX 5060 Ti で 14,898〜14,924MiB だった。ピークは、生成の間くり返し読み取った nvidia-smi の GPU 全体の使用量の最大値で、読み取りの合間の短い山は入らないことがある。どちらの GPU でも、LoRA を当てた状態で 2048×2048 と 4096×4096 の生成が最後まで終わった。
VRAM のピークのほかに、共有 GPU メモリ(メインメモリのうち GPU も使える領域)の使用も記録した。この使用量は、VRAM に置ききれないぶんだけを表す値ではない。読んだのは Windows の、GPU ごとの合計のカウンターで、ComfyUI 以外のソフトのぶんも入り、何が使ったかの内訳は分からない。カウンターは1秒ごとに読み、増分は、1枚を作る間の最大値から、その1枚の最初の値を引いたものである。RTX 5080 で 2048×2048 の人物を4枚作ったときの値は次の表のとおり。
| 本体と設定 | VRAM のピーク | 共有 GPU メモリの増分 (1枚目) | 共有 GPU メモリの増分 (2枚目以降の最大) |
|---|---|---|---|
| w4a8・6ステップ | 15,474MiB | 9.5MiB | 1.0MiB |
| w4a8・2ステップ LoRA | 15,484MiB | 1,323.4MiB | 1.5MiB |
| int8・6ステップ | 15,441MiB | 6,546.9MiB | 1.2MiB |
| int8・2ステップ LoRA | 15,495MiB | 8,206.3MiB | 139.7MiB |
増分が大きかったのは、モデルを読み込む1枚目だった。1枚目の増分は本体が int8 のときに大きく、LoRA を当てない6ステップでも 6,546.9MiB あった。int8 の本体はファイルが約21GBあり、それだけで VRAM の16GBより大きい (w4a8 は約12.5GB)。LoRA を当てた回は、当てない回より1枚目の増分が大きかった (w4a8 で 9.5MiB と 1,323.4MiB、int8 で 6,546.9MiB と 8,206.3MiB)。2枚目以降の増分は、w4a8 で 0〜1.5MiB、int8 に LoRA を当てた場合で 0〜139.7MiB だった。2枚目以降の増分は、その1枚の最初の値との差で、使用量が0という意味ではない。int8 に LoRA を当てた回では、2枚目を始める時点で約8.7GiB が共有 GPU メモリに置かれたままだった。
RTX 5060 Ti でも並びは同じで、1枚目の増分は w4a8 の6ステップで 196.0MiB、w4a8 に LoRA を当てて 658.8MiB、int8 の6ステップで 6,588.6MiB、int8 に LoRA を当てて 7,310.7MiB だった。ここに書いた値は各構成1回の測定で、int8 や LoRA で増分が大きくなった理由は切り分けていない。
1秒ごとの読み取りなので、読み取りの合間に一瞬だけ上がった値は拾えていない可能性がある。測定機のメインメモリは 96GB で、メインメモリが少ない PC での結果は測っていない。
等倍で見ると、2ステップの画像に格子状の模様が出た
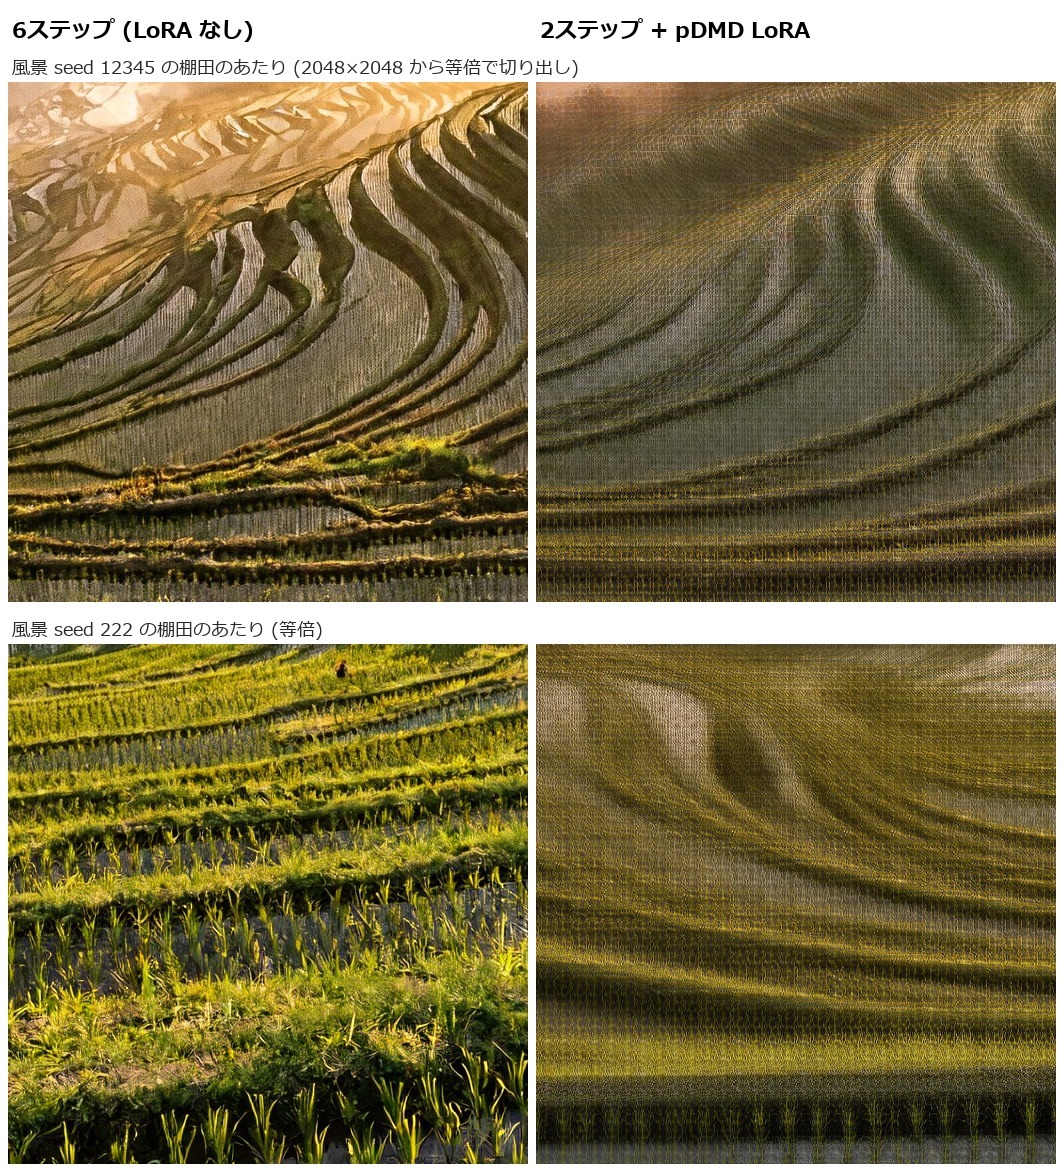
6ステップ(LoRA なし)の画像では、格子状の模様を34枚のうち1枚も数えなかった。2ステップ LoRA を w4a8 の本体に当てた 2048×2048 の画像では、16枚のうち13枚で数えた。内訳は、はっきり見えるものが7枚、うっすら見えるものが6枚、見えないものが3枚である。縮小した表示では分かりにくく、ここに書くのは等倍で見たときの結果である。
模様が、量子化した本体・LoRA・ステップ数のどれと関係するかは切り分けていない。6ステップは公式テンプレート、2ステップ LoRA は配布ページのワークフローで作っていて、サンプリングの設定(MiniMaxH3SigmaShift の有無など)も違う。この記事は、w4a8 と int8 の量子化した本体で測った。配布ページの ComfyUI の節が動作確認として書いているのは、bf16 の本体を H200 で動かした結果である。bf16 の本体(約40GB)は測っていない。
数えたのは RTX 5080 で作った画像である。各画像から、位置を固定した4か所(448×448画素)を縮めずに切り出して並べ、設定名を伏せて、模様があるかを1回数えた。切り出した範囲の外は見ていない。4か所の合計は、2048×2048 では画像の約19%、4096×4096 では約5%にあたる。
「はっきり」は等倍ですぐ分かるもの、「うっすら」は平らな面や肌をよく見ると分かるもの。布の織り目のように、素材の模様かもしれず迷ったものも「うっすら」に入れた。同じ設定・同じプロンプト・同じ seed で2回作った画像は、1枚として数えた。数えた結果であって、画質の採点ではない。設定・本体・大きさごとの結果は次の表のとおり。
| 設定 | 本体 | 大きさ | 枚数 | はっきり | うっすら | 見えない |
|---|---|---|---|---|---|---|
| 6ステップ (LoRA なし) | w4a8・int8 | 2048×2048・4096×4096 | 34枚 | 0枚 | 0枚 | 34枚 |
| 2ステップ LoRA | w4a8 | 2048×2048 | 16枚 | 7枚 | 6枚 | 3枚 |
| 2ステップ LoRA | w4a8 | 4096×4096 | 10枚 | 8枚 | 1枚 | 1枚 |
| 2ステップ LoRA | int8 | 2048×2048 | 4枚 | 1枚 | 3枚 | 0枚 |
| 2ステップ LoRA | int8 | 4096×4096 | 4枚 | 1枚 | 3枚 | 0枚 |
6ステップの34枚は、w4a8 の 2048×2048 が16枚・4096×4096 が10枚、int8 が8枚。2ステップ LoRA・w4a8 の 2048×2048 の16枚は、4つの主題を seed 4つずつ作ったもの。4096×4096 の10枚は、人物4枚と、商品・風景・英語の看板が2枚ずつ。int8 の行は人物だけを数えた。
2ステップ LoRA では、画像を大きくしても模様は残り、4096×4096 の w4a8 では10枚のうち8枚がはっきり見えた。int8 の本体でも、人物の4枚ずつすべてで模様を数えた。どちらの本体でも、LoRA を外した6ステップの画像では1枚も数えなかった。
格子状の模様のほかに、細部の形が崩れている箇所があるかも同じ見方で数えた。形が崩れているとしたのは、ボタンや金具、文字、遠くの景色などで、何が写っているか分からないか、線が溶けてつながっている箇所である。2ステップ LoRA・w4a8 では、2048×2048 の16枚のうち9枚、4096×4096 の10枚のうち7枚で数えた。6ステップの34枚では数えなかった。判断に迷った画像もあり、これも1回数えただけの結果である。
主題ごとの差
主題によって模様の見え方が違った。2ステップ LoRA・w4a8・2048×2048 の16枚を主題ごとに分けると、次の表のとおり。プロンプトは主題ごとに1つである。
| 主題 | はっきり | うっすら | 見えない |
|---|---|---|---|
| 人物 | 2枚 | 2枚 | 0枚 |
| 商品 | 0枚 | 1枚 | 3枚 |
| 風景 | 4枚 | 0枚 | 0枚 |
| 英語の看板 | 1枚 | 3枚 | 0枚 |
風景は4枚とも、はっきり見えた。商品は4枚のうち3枚で見えず、残る1枚もうっすらだった。主題ごとに4枚ずつなので、主題による差は、この16枚の範囲での傾向として読む。
LoRAのままステップを3・4に増やした結果
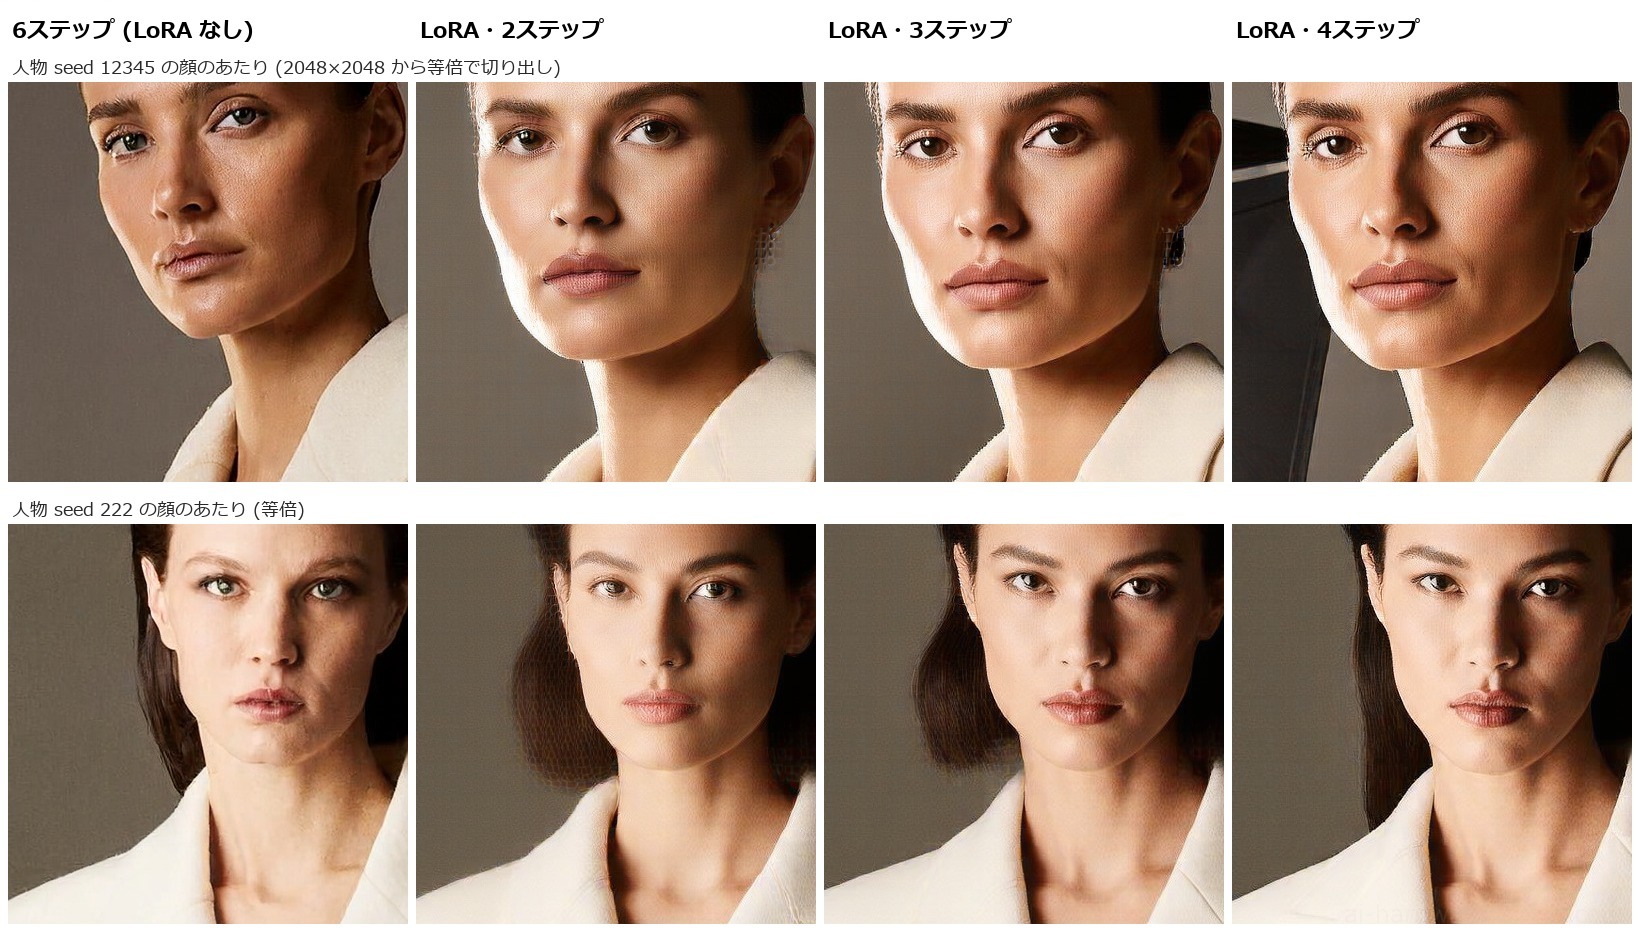
LoRA を当てたままステップを4に増やすと、格子状の模様は4枚のうち1枚も数えなかった。3ステップでは4枚のうち1枚で、うっすら見えた。どちらも RTX 5080・w4a8・2048×2048 で、人物2枚と商品2枚の4枚ずつを作った結果である。
ステップ数ごとの結果は次の表のとおり。模様の列は数え上げの結果で、サンプリングの時間は2枚目以降3枚の中央値である。LoRA なしの2ステップと、LoRA のままの3・4ステップは、2枚目以降の3枚に、プロンプトを書き換えた直後の1枚が入っている。3・4ステップを測っている間は、同じ PC で別の処理が動いていた。そのため3・4ステップのサンプリングの時間は参考値で、1枚あたりの時間は載せていない。
| 設定 | 枚数 | 格子状の模様 | サンプリングの時間 |
|---|---|---|---|
| LoRA なし・2ステップ | 4枚 | 4枚 (うっすら) | 1.78秒 |
| LoRA あり・2ステップ | 16枚 | 13枚 (はっきり7・うっすら6) | 1.65秒 |
| LoRA あり・3ステップ | 4枚 | 1枚 (うっすら) | 2.28秒 |
| LoRA あり・4ステップ | 4枚 | 0枚 | 3.58秒 |
| LoRA なし・6ステップ (公式テンプレート) | 16枚 | 0枚 | 4.46秒 |
3・4ステップは4枚ずつと枚数が少なく、そのうち商品の主題は2ステップでも模様が見えにくかった。模様が減ることを確かめた範囲は狭い。
参考値の範囲では、LoRA のまま4ステップにするとサンプリングの時間は 3.58秒で、LoRA なしの6ステップの 4.46秒に近づいた。模様が減る代わりに、2ステップで縮めた時間は小さくなる。LoRA を外した2ステップでも、4枚すべてでうっすらと模様を数えた。
よくある質問
VRAM 16GB の GPU で2ステップ LoRA は動くか
RTX 5080 と RTX 5060 Ti(どちらも16GB)では動く。2048×2048 と 4096×4096 のどちらも、w4a8 と int8 のどちらの本体でも生成が終わった。VRAM のピークは LoRA の有無でほとんど変わらなかった。1枚目には共有 GPU メモリの使用が増え、RTX 5080 の 2048×2048 では、w4a8 は6ステップで 9.5MiB、2ステップ LoRA で 1,323.4MiB。int8 は LoRA なしの6ステップでも 6,546.9MiB、2ステップ LoRA で 8,206.3MiB だった。測定機のメインメモリは 96GB で、メインメモリが少ない PC では測っていない。
w4a8 と int8 のどちらに当てるか
測った範囲では、2ステップ LoRA を当てたときの1枚あたりの時間と、1枚目の共有 GPU メモリの増分は、w4a8 のほうが小さかった。格子状の模様は、どちらの本体でも数えた(int8 は人物の主題だけ)。どちらの本体にも、同じ minimax_h3_pdmd_2nfe_comfyui.safetensors を当てる入れ方になる。配布ページは、この2つの量子化した本体では LoRA を当てる入れ方だけが使えると書いている。
格子状の模様を消す方法はあるか
LoRA を外し、公式テンプレートの6ステップに戻して作った34枚のうち、格子状の模様を数えた画像は0枚だった。数えたのは、各画像の切り出した4か所である。画像の全体や別のプロンプトでも出ないことを確かめた結果ではない。LoRA のまま4ステップにした4枚でも0枚だった。ただし枚数が少ない。サンプリングの時間は6ステップに近づく (参考値)。配布ページにある detail pass は測っていない。
RTX 5060 Ti でも使えるか
測定した16GBの RTX 5060 Ti では、2ステップ LoRA を当てた生成が終わった。8GBの製品は測っていない。2048×2048・w4a8 の1枚あたりの時間は、6ステップの 11.44秒に対して、2ステップ LoRA は 6.40秒だった。この 6.40秒は、RTX 5080 の2ステップ LoRA(3.33秒)よりは長いが、RTX 5080 の6ステップ(6.16秒)に近い。格子状の模様を数えたのは RTX 5080 で作った画像で、RTX 5060 Ti で作った画像は数えていない。
測定の条件と測っていないこと
測定は RTX 5080(16GB)と RTX 5060 Ti(16GB)で、ComfyUI 0.45.3・PyTorch 2.14.0+cu130・NVIDIA ドライバー 610.88 で行った。本体は w4a8 と int8_convrot、テキストエンコーダーは qwen3vl_32b_minimax_h3_nvfp4_awq、VAE は fp16 である。細かい条件は次の表のとおり。
| 項目 | 内容 |
|---|---|
| GPU | RTX 5080 (16GB)・RTX 5060 Ti (16GB)。RTX 5060 Ti は OCuLink 接続。1回の測定で使う GPU は1枚 |
| メインメモリ | 96GB |
| ソフトウェア | ComfyUI 0.45.3・PyTorch 2.14.0+cu130・NVIDIA ドライバー 610.88 |
| 本体 | minimax_h3_image_pruned_w4a8.safetensors・minimax_h3_image_pruned_int8_convrot.safetensors |
| テキストエンコーダーと VAE | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors・minimax_h3_image_vae_fp16.safetensors |
| LoRA | minimax_h3_pdmd_2nfe_comfyui.safetensors (強さ 1.0・本体の読み込みの直後) |
| サンプリング (6ステップ) | 公式テンプレートの設定 (KSampler・euler・simple・CFG 1)。MiniMaxH3SigmaShift は入っていない |
| サンプリング (2ステップ LoRA) | LoRA の配布ページのワークフローの設定 (SamplerCustomAdvanced・BasicGuider・euler・simple・MiniMaxH3SigmaShift の shift_video 12)。3・4ステップと、LoRA を外した2ステップは、このワークフローでステップ数と LoRA の有無だけを変えた |
| プロンプト | 英語の短い文。プロンプト拡張はオフ。時間の測定に使った人物の文は「Editorial studio portrait of a woman in a structured ivory wool coat against a seamless warm grey backdrop, single softbox from the left, 85mm lens」 |
| seed | 12345・222・333・444 (4枚の場合)。2枚の場合は 12345・222 |
| 時間の測り方 | ワークフローを送る直前から、完了を確かめて記録するまでを、測定する側で計った時間。完了の確認と、GPU の監視を止める処理の時間も入り、ComfyUI が知らせる実行時間より長い。RTX 5080・w4a8 の中央値では、6ステップは、この記事の値が 6.16秒、ComfyUI が知らせる実行時間が 5.65秒で、2ステップ LoRA は、この記事の値が 3.33秒、ComfyUI が知らせる実行時間が 2.82秒だった。ComfyUI を起動して最初の1枚を除いた、2枚目以降の中央値。LoRA なしの2ステップと、LoRA のままの3・4ステップは、人物2枚と商品2枚を続けて作っていて、2枚目以降の3枚にプロンプトを書き換えた直後の1枚が入る |
| 模様の数え方 | 各画像から位置を固定した4か所 (448×448画素) を等倍で切り出し、設定名を伏せて1回数えた。同じ設定・プロンプト・seed の画像は1枚として数えた |
GPU・本体・設定の組み合わせを変えるたびに ComfyUI を起動し直し、1枚目を作る前の GPU の使用量を記録した。載せた測定では、RTX 5080 が 1,391MiB 以下、RTX 5060 Ti が 114MiB だった。計算に使われた GPU は、ComfyUI が起動時に知らせるデバイス名と、その GPU の使用量が nvidia-smi で増えたことで確かめた。ComfyUI のログでは、テキストエンコーダー・本体・VAE はどれも、必要なぶんだけを VRAM に載せる読み込み方(dynamic VRAM)になっていた。ログに Staged と出た量は、テキストエンコーダーが 14,956MB、本体は w4a8 が 11,960MB、int8 が 19,999MB、VAE が 1,114MB だった。Staged は読み込みの対象として用意された量で、VRAM に載った量を表す値ではない。テキストエンコーダー・本体・VAE を足した合計は、本体が w4a8 でも int8 でも16GBを超えていて、全部が VRAM に載ったままで動いたわけではない。MB はログの表記のままの値で、この記事のほかの MiB の値と並べて比べるものではない。メインメモリの側に置かれた量は記録していない。nvidia-smi は 0.25秒の待ちをはさんでくり返し読んだ。共有 GPU メモリは、Windows の typeperf で「GPU Adapter Memory」の Shared Usage を1秒おきに読んだ。
RTX 5060 Ti の w4a8・2ステップ LoRA と int8・6ステップ(どちらも 2048×2048)は、ComfyUI を起動し直して測り直した値を載せた。1回目は、測定を始める前からその GPU の VRAM が約10GiB 使われていて、1枚あたりの時間が 25.81秒と 19.47秒、1枚目の共有 GPU メモリの増分が約20GiB と約24GiB、VRAM のピークが 15,801MiB と 15,551MiB だった。この記事の表と VRAM のピークの範囲に、1回目の値は入れていない。
本記事の実測値は2026年11月14日に、上記の測定機・設定で計測したもの。
この記事で測っていないことは、次のとおり。
- bf16 の本体と、LoRA を焼き込んだ約40GB の1ファイル
- 配布ページにある detail pass
- 画像編集
- VRAM が12GB 以下の GPU
- 正方形以外の縦横比
- メインメモリが96GBより少ない PC
- RTX 5060 Ti で作った画像の模様の数え上げ
- 同じ起動のまま LoRA を付け外ししたときの切り替えの時間
- 格子状の模様が、量子化した本体・LoRA・ステップ数・サンプリングの設定のどれと関係するか
- 配布ページのワークフローから LoRA だけを外して6ステップにした場合
- 切り出した4か所の外の範囲の模様
- 画質の良し悪しの採点(模様は、あるかどうかを1回数えただけ)