この記事の要点
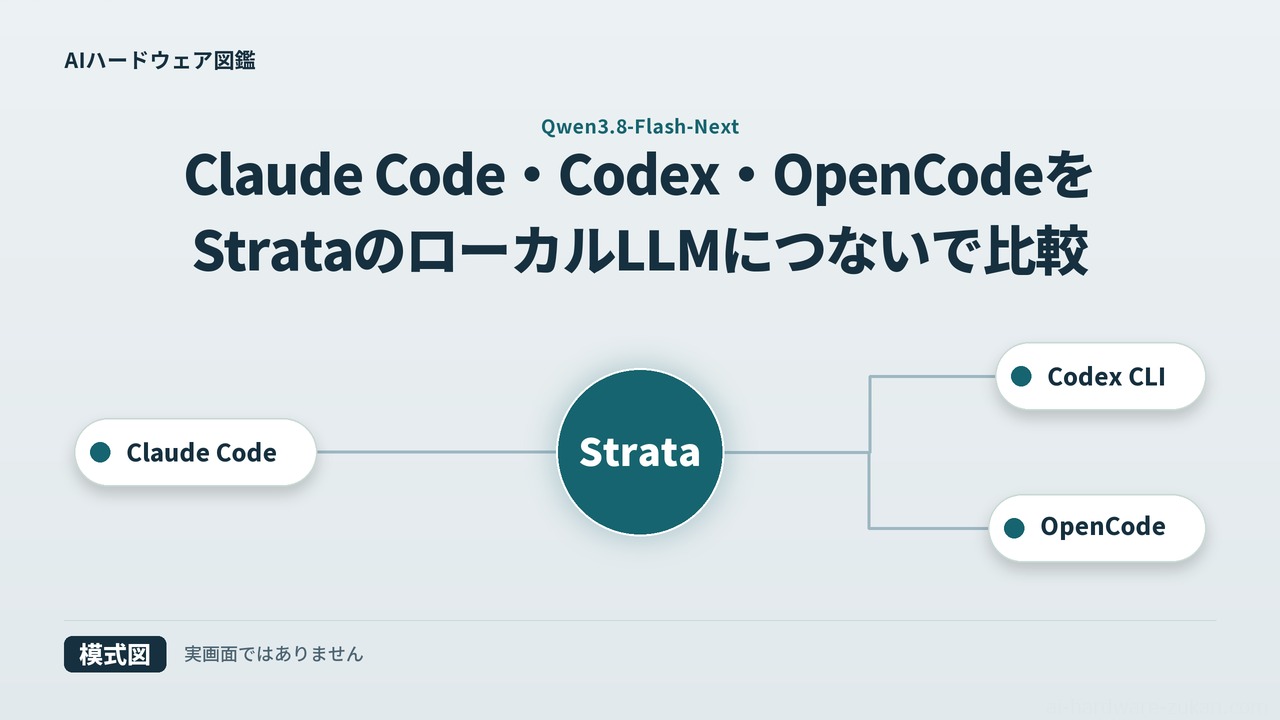
Strata 0.1.41 で Qwen3.8-Flash-Next (IQ3_S) を RTX 5080 1枚で動かし、Claude Code・Codex CLI・OpenCode に同じ課題文で小さな関数の修正を解かせた。各15回のうち合格は OpenCode が15回、Codex が14回、Claude Code が12回で、所要の中央値は OpenCode が17.0秒、Claude Code が20.5秒、Codex が35.1秒だった。Codex だけはファイルを読む専用のツールが無く、シェルで読む構成で、所要の差のどれだけがこの違いによるかは分けていない。不合格の4回はどれも採点器の規則に当たったもので、決まったテストの範囲では関数は期待どおりの値を返していた。RTX 5080 (VRAM 16GB) 1枚とメインメモリ 96GB の PC でも、この規模の修正なら3つとも手元のモデルで最後まで終えた。
Codex 0.162.0 に手元のモデルの名前 (この記事の qwen3.8-flash-next-iq3_s のように、Codex が持つモデルの一覧のどれにも当てはまらない名前) を渡すと、ファイルを書き換えるツール (apply_patch) がモデルに渡らない。この状態で測った別の回 (指示も違う) では、Codex はシェル (この PC では Windows PowerShell 5.1) からファイルごと書き直し、ファイルの先頭に付いた3バイトの印 (BOM) で不合格になった回があった。config.toml の model_catalog_json でモデルの情報を渡すと apply_patch が渡り、上の測定では書き換えはすべてこのツールで済んだ。
Codex ではアプリ連携など手元のモデルに要らないツールを切り、思考設定は各クライアントで指定し、文脈の長さは Codex と OpenCode の設定を Strata のセットアップに合わせる。Claude Code はつなぎ先の上限を自動では知らないので、会話を要約する境界を自分でそれより小さくしておく (測定では指定していない)。Claude Code をこの形で Claude 以外のモデルにつなぐ使い方は Anthropic のサポートの外にある。
RTX 5080 1枚で、3つのクライアントに3つの修正課題を同じ課題文で5回ずつ解かせた
Strata 0.1.41 で Qwen3.8-Flash-Next (IQ3_S) を動かした RTX 5080 1枚のサーバーに、課題と課題文・思考設定・温度・出力の上限をそろえて3つのクライアントを順につなぎ、小さな Python の関数の修正3つを各5回、クライアントごとに15回解かせた。ここでいうクライアントは、Strata につなぐコーディング用のエージェントのアプリ (Claude Code・Codex CLI・OpenCode) のことで、測ったのは Claude Code 2.1.295・Codex CLI 0.162.0・OpenCode 1.18.35。以下では Codex CLI を Codex と書く。
サーバーは最大の文脈 262,144 トークンで起動した1つのまま使い、クライアントの順番は回ごとに入れ替え、課題ごとにプロジェクトを元の状態から始めた。思考設定 (effort。low・medium・high などで指定する考える深さ) はどのクライアントも medium にし、温度は0、1回の出力の上限は 8192 トークンにそろえた。Strata のドキュメントによると、IQ のモデルでは温度0でも、先読みやキャッシュの状態によって同じ入力から別の答えになることがある。同じドキュメントには、答えの違いを減らすための指定 (Strata の設定の env の STRATA_IQ_MT_MIN=1 や、エンジンの引数の --prompt-cache 0 など) も載っているが、測定ではどれも指定していない。Strata は各回の前に起動し直していないので、サーバーの状態までそろえた比較ではない (エンジンの記録では、どの回も最初の要求は会話の再利用が0トークンで、会話のキャッシュが回をまたいで使われた形跡は無い)。また、要求に乱数の種 (seed) は指定していない。同じ課題の5回が同じ答えになるとは限らない条件で測っている。
起動時に渡す課題の文面 (以下、課題文) は3つとも同じで、module.py だけを、ファイルを書き換える専用のツールで直すよう求めた。シェルのコマンドでファイルを書かないことなどは作業の決まりのファイルに書いたが、Claude Code の要求にはこのファイルの文面が入っていなかった (「測った課題と条件」に書いた)。以下では、課題文と作業の決まりのファイルをあわせて指示と書く。モデルに渡ったツールは、Claude Code が Read・Edit・Write・Glob・Grep、OpenCode が read・edit・write・glob・grep の5つずつで、書き換えには Claude Code が Edit を、OpenCode が edit を使った。Codex に渡ったのは、シェルのコマンドを実行する exec_command と、ファイルを書き換える apply_patch を含む5つで、apply_patch は「Codexの失敗例と直し方」に書いた事情から、設定を足して渡している。
そろえられなかった点もある。この測定で Codex 0.162.0 に渡ったツールにはファイルを読む専用のものが無く、module.py はシェルのコマンドで読む。シェルのコマンドを実行するツールが渡ったのも Codex だけで、Claude Code と OpenCode はシェルを外した設定で動かした。所要の内訳と、Codex がシェルで何をしていたかは「所要を分けると、Codexはエンジンの記録に残らない時間が長かった (中身は測っていない)」で扱う。
この medium は、Codex では既定と違う。Codex 0.162.0 に手元のモデルの名前を渡して思考設定を指定しないと、要求に思考設定は入らず (手元の記録)、Strata のドキュメントによればその要求はモデルの既定の high で考えるので、表の Codex の値は既定のまま動かしたときの値ではない。Claude Code の既定はモデル名によって変わり (「Strataにつなぐ設定」の Claude Code の項)、測定で入れた claude-sonnet-5-5 では既定も medium なので、--effort medium は既定と同じ設定を明示したことになる。OpenCode の既定は確かめていない。Codex を既定のまま動かしたときの所要は測っていない。測定機は Windows で、Codex のシェルのコマンドは Windows PowerShell 5.1 (powershell.exe) で動いた。
Claude Code の公式ドキュメント (Other LLM gateways) は、Anthropic はどのゲートウェイを経由しても Claude Code を Claude 以外のモデルへ流す使い方をサポートしていない、と書いている。この記事の Claude Code の使い方はそのサポートの外にある。
本記事の実測値は、2026年10月10日に Strata 0.1.41 とこの測定機・設定で計測したもの。「Codexの失敗例と直し方」の2つの例と、思考設定の既定を確かめた記録 (Claude Code と Codex に思考設定を指定しなかったときの要求) は、前日の10月9日に取った。測定の日の未明 (日本時間) には Claude Code 2.1.296 と Codex CLI 0.162.1 が公開されていたが、それらでは測っていない。
表の「合格」は採点器の検査 (決まったテストと規則。「測った課題と条件」に書いた) が全部通り、変わったファイルが module.py だけで、クライアントがエラー無く (終了コード0で) 制限時間内に終わった回、「所要」は起動済みの Strata に対してクライアントを起動してから終わるまでの時間 (Strata の起動とモデルの読み込みは入らない)、「要求」はクライアントがモデルの API へ送る1回のリクエストを指す。トークンの数はサーバーの応答に付く使用量の記録から取った。
| クライアント | 合格 | 所要の中央値 (最小〜最大) | モデルへの要求の回数 (中央値、最小〜最大) | 一番長い入力 (トークン、中央値) | 生成したトークン (1回の合計、中央値) |
|---|---|---|---|---|---|
| Claude Code 2.1.295 | 12/15 | 20.5秒 (16.5〜53.8) | 4 (4〜5) | 4,769 | 1,060 |
| Codex 0.162.0 | 14/15 | 35.1秒 (27.1〜128.4) | 7 (5〜11) | 8,290 | 1,150 |
| OpenCode 1.18.35 | 15/15 | 17.0秒 (12.8〜25.2) | 4 (4〜5) | 4,804 | 739 |
合格の数は採点器の結果のままで、参考として行った再採点や採点器の外での確かめは含めていない。不合格の4回はどれも、決まったテストで関数が誤った値を返したためではなく、指示に書いていない採点器の規則に当たったためで、中身は下に書いた。この表は小さな関数の修正3つの結果で、大きなリポジトリや長い作業の結果ではない。秒数はこの PC での値で、手元の GPU では変わる。
OpenCode は15回とも合格し、所要も一番短かった。Claude Code は所要が OpenCode に近く、合格は12回だった。Codex は合格が14回で、所要の中央値は OpenCode の約2倍、Claude Code の約1.7倍だった。この差には、上に書いた Codex だけの構成の違いも含まれる。要求の回数と一番長い入力は Codex が他の2つより多く、生成したトークンの合計は OpenCode が一番少なかった。
不合格の4回 (Claude Code が3回、Codex が1回) はどれも税込みの合計で、関数の外で Decimal(1) や Decimal("0.10") のように Decimal(...) を呼んで定数を作ったことが、採点器の「関数の外の代入で呼び出しを使わない」規則に当たった。この規則は指示に書いていない。規則だけを外して確かめると、4回とも決まったテストで関数は期待どおりの値を返した。この確かめは参考で、表の合否は採点器の結果のまま変えていない。
課題ごとに分けると次のようになる (各5回、所要は中央値)。
| 課題 | Claude Code | Codex | OpenCode |
|---|---|---|---|
| 税込みの合計 | 2/5 合格・34.7秒 | 4/5 合格・77.0秒 | 5/5 合格・18.1秒 |
| 設定の行の解析 | 5/5 合格・20.5秒 | 5/5 合格・34.6秒 | 5/5 合格・13.2秒 |
| ログの ERROR の数 | 5/5 合格・18.4秒 | 5/5 合格・33.8秒 | 5/5 合格・17.0秒 |
Claude Code と Codex では、税込みの合計の所要が他の2つの課題より長かった。
この記事では、どのクライアントがよいかは断定せず、差の出どころと、Strata につなぐときに見る設定を扱う。設定は「Strataにつなぐ設定」にまとめている。
所要を分けると、Codexはエンジンの記録に残らない時間が長かった (中身は測っていない)
以下の内訳は10月10日に測った各15回の値。Strata のエンジンの記録には、要求ごとに入力を読んだ時間 (入力の読み込み、prefill) と、出力を作った時間 (生成、decode) が残る。この記録を要求と順に対応させて1回ずつ足し、所要と突き合わせたのが次の表で、値はクライアントごとに15回の値から項目ごとにとった中央値。「それ以外の時間」は1回ごとに所要から読み込みと生成の時間を引いた残りの中央値。ツールの呼び出しはクライアント自身の記録から数え、Codex ではシェルのコマンドも1回ずつ数えた。書き換えは module.py を書き換えたツールの呼び出しで、Codex では apply_patch の呼び出しを数えた (シェルのコマンドで module.py を書いた回は無かった)。
| クライアント | 所要 | エンジンが入力を読んだ時間 | エンジンが生成した時間 | それ以外の時間 | 生成の速さ | ツールの呼び出し (うち module.py の書き換え) |
|---|---|---|---|---|---|---|
| Claude Code | 20.5秒 | 3.8秒 | 16.0秒 | 0.7秒 | 68.0 tok/s | 3 (1) |
| Codex | 35.1秒 | 6.6秒 | 16.4秒 | 12.2秒 | 69.2 tok/s | 6 (1) |
| OpenCode | 17.0秒 | 3.7秒 | 11.7秒 | 1.7秒 | 70.5 tok/s | 2 (1) |
項目ごとに別々にとった中央値なので、横に足した値が所要の中央値と一致するとは限らない。生成の速さは1回ごとの「生成したトークン÷エンジンが生成した時間」の中央値で、表のほかの項目の中央値からは割り戻せない。「それ以外の時間」には、クライアントの起動・コマンドの実行・通信のほか、サーバーの中でもエンジンの記録の外にある処理 (要求の受け取りや変換など) が入りうるが、内訳は測っていない。
生成の速さは3つのクライアントでほぼ同じだった。所要の中央値は、Codex が Claude Code より約15秒、OpenCode より約18秒長かった。項目ごとの中央値を比べると、差が一番大きかったのはエンジンの記録に読み込みとも生成とも残らない時間 (Claude Code とで約11.5秒、OpenCode とで約10.5秒) で、読み込みの時間の差は約3秒、生成の時間の差は Claude Code とでは1秒未満、OpenCode とでは約5秒だった。中央値どうしの差なので、所要の差を項目ごとに割り振った値ではない。Codex は要求の回数も多かったが、それが生成した量や読み込みと別に所要をどれだけ延ばしたかは分けていない。Codex ではシェルのコマンドを実行している時間がこの「それ以外の時間」に含まれている可能性があるが、そこは確かめていない。
Codex はシェルのコマンドを1回の作業で中央値5回動かしていた。module.py を読むのもシェルで、それに加えて15回とも、指示に無い Python での動作の確かめをシェルで2回ずつ試みていた。この測定の Codex のシェルからは Python が見つからず、この30回のコマンドはどれもエラーで終わっている。ほかに Python を探すだけのコマンドも15回の合計で15回あった。測定は Codex の承認の方式 (approval_policy) を never にしていた。記録した要求には、課題文と作業の決まりのファイルのほかに、Codex に組み込まれた既定の指示文 (prompt.md) も入っていて、そこには never のときはテストなどを自分から実行して作業を終えたことを確かめるよう求める一文がある。確かめの試みがこの一文によるかは分けていない。Python が使えるシェルでは、これらの回数は変わりうる。税込みの合計の5回のうち4回は、Python が見つからなかったあと、税の丸め方を PowerShell の decimal の計算で確かめるコマンドも動かしていた。これは同じ計算を PowerShell で書いたもので、直した Python の関数を動かしたものではない。税込みの合計の5回では、Python を探すコマンドのうち1回ずつが作業フォルダーの外 (C ドライブの直下など) を調べていて、作業フォルダーの外に触れないという指示から外れていた。どれも探して一覧するだけのコマンドで、ファイルの書き込みは無かった。Claude Code と OpenCode はシェルが無く、作業フォルダーの外はツール側の設定で止めているので、この点は3つの比較になっていない。
2回目以降の要求では会話の前半が再利用されるため、新しく読む入力は少なくて済む。1回の作業で新しく読んだ入力 (1回の作業の全部の要求の合計なので、1回の要求の最大である一番長い入力より大きくなることがある) は、中央値で Claude Code が約 4,093 トークン、Codex が約 7,380 トークン、OpenCode が約 4,883 トークンだった。
OpenCode の要求の回数には、ツールを付けずにスレッドの題名を作らせる要求が毎回1回入っている。
Codexの失敗例と直し方
Codex を手元のモデルにつないだときに起きた2つの失敗と、その直し方を書く。どちらも10月9日に、RTX 5080 1枚の Strata 0.1.41 と Codex CLI 0.162.0 で記録したもの。
例1: apply_patch が渡らず、シェルからファイルごと書き直した
Codex 0.162.0 に、Codex が持っているモデルの一覧のどれにも当てはまらない名前 (この記事では qwen3.8-flash-next-iq3_s) を渡すと、モデルに渡ったツールは exec_command・write_stdin・request_user_input・view_image の4つで、ファイルを書き換える apply_patch は入らなかった (アプリ連携などを切った設定での観測)。Codex 0.162.0 のソースでは、渡された名前を一覧の名前と頭から照らし合わせ、一覧にある名前で始まっていれば、そのうち一番長く一致した項目の情報を使う (「名前空間/」が1つ付いた名前は、それを外してもう一度照らし合わせる。models-manager/src/manager.rs)。どれにも当てはまらないと、既定のモデルの情報 (models-manager/src/model_info.rs) を使う。apply_patch はモデルの情報に apply_patch の指定があるときにだけ渡され (core/src/tools/spec_plan.rs)、この既定の情報にはその指定が無い。
10月9日は、この状態の Codex に同じ3課題を各5回解かせた。指示も10月10日とは違い、Codex にはシェルで module.py を読み書きするよう、ほかの2つにはシェルを使わないよう出していた。
Codex は、シェル (この PC では Windows PowerShell 5.1) から module.py を書き換えていた。15回のうち13回で、シェルのコマンドとして Codex のパッチの書式 (apply_patch) を呼んだが、計34回のどれも適用されず (返ってきたエラーで一番多かったのは Invalid patch: The last line of the patch must be '*** End Patch')、15回とも module.py をファイルごと直接書き直していた。1回の作業で module.py を書き換えようとした回数は、適用されなかったパッチも含めて、中央値で Codex が3回、ほかの2つが1回だった。指示に無い、Python で動作を確かめる試みも15回のうち14回であった。この日も承認の方式は never で、要求には上に書いた Codex の既定の指示文の一文 (never のときはテストなどを自分から実行する) が入っていて、試みがこの一文によるかは分けていない。この測定の Codex のシェルからは Python が見つからなかった。
合格は15回のうち13回だった。不合格の2回は、どちらも決まったテストの範囲では関数が期待どおりの値を返していて、採点器の検査で落ちた。1回は設定の行の解析で、最後の書き込みが Windows PowerShell 5.1 の Set-Content の -Encoding utf8 だったため、module.py の先頭に BOM (ファイルの先頭に付く3バイトの印、EF BB BF) が付いた (Microsoft のドキュメント about_Character_Encoding によると、5.1 でこの指定は BOM 付きの UTF-8 になる)。Python はソースファイルを読み込むとき先頭の UTF-8 の BOM を無視するが、この採点器はファイルを BOM ごと文字列として読み込んでから構文を調べていたので、構文エラーとして落とした。Windows PowerShell 5.1 でファイルを書かせ、そのファイルを BOM を受け付けない道具に渡すときは、書き込まれたファイルの先頭の3バイトを確かめる手がある。もう1回は税込みの合計で、10月10日の不合格4回と同じ採点器の規則に当たった。BOM だけを除いた再採点と、規則だけを外した確かめはどちらも参考で、合否は採点器の結果のまま変えていない。
apply_patch を渡していない10月9日と、渡した10月10日の Codex を並べると次のようになる。2つの日では指示と測った日も違うので、表の差のどれだけが apply_patch によるものかは分けていない (所要などは各15回の中央値)。
| 項目 | 10月9日 (apply_patch なし・指示が別) | 10月10日 (apply_patch あり) |
|---|---|---|
| Codex への指示 | シェルで module.py を読み書きする (課題文と作業の決まりのファイルの両方に書いた) | 課題文: ファイルを書き換える専用のツールで直す (この課題文は3つのクライアントで同じ)。作業の決まりのファイル: 専用のツールで直し、シェルでファイルを書かない |
| module.py の書き換え方 | 15回ともシェルでファイルごと書き直した | 15回とも apply_patch (計17回、すべて適用) |
| ファイルの先頭に BOM が付いた回 | 1回 | 0回 |
| 合格 | 13/15 | 14/15 |
| 所要の中央値 | 63.1秒 | 35.1秒 |
| モデルへの要求の回数 | 10 | 7 |
| 生成したトークン (1回の合計) | 2,809 | 1,150 |
同じクライアントどうしで比べると、生成の速さは10月9日のほうが約2〜8%速かった。10月10日の15回では、module.py の書き換えはすべて apply_patch で行われ、シェルで module.py を書いた回も、BOM が付いた回も無かった。
直し方: config.toml の model_catalog_json で、手元のモデルの名前に apply_patch の指定を付けたモデルの情報のファイルを指す。ファイルの作り方と config.toml の行は「Strataにつなぐ設定」の Codex の項に書いた。直したあとの10月10日の記録では、codex exec --json の出力に、module.py の書き換えがシェルのコマンド (command_execution) ではなく file_change として出ていた。
例2: アプリ連携のツールまで渡り、最初の要求が大きくなった
ChatGPT のアカウントでログインした Codex の設定フォルダーをそのまま使うと、アプリ連携などのツールまで手元のモデルに渡り、最初の要求が大きくなった。税込みの合計を設定ごとに1回ずつ解かせたときの最初の要求は次のとおり (読み込みの時間はエンジンの記録)。
| Codex の設定 | モデルに渡ったツール | 最初の要求の入力 | その読み込み |
|---|---|---|---|
| アプリ連携・ウェブ検索・サブエージェントなどを既定のまま | 268個 (うちアプリ連携 251個) | 104,337 トークン | 32.2秒 |
| それらを切った ([features] の10項目と web_search。apply_patch はまだ渡していない) | 4個 | 6,455 トークン | 3.0秒 |
設定ごとに1回だけの記録で、アプリ連携のツールの数はログインしているアカウントの連携によって変わる。[features] の10項目と web_search をすべて切ると、渡るツールと最初の要求は表の下の行まで小さくなった。どの指定でどれだけ小さくなったかは分けていない。apply_patch も渡した10月10日の設定では、渡ったツールは5個、最初の要求の入力は 6,707 トークンだった。
Codex のドキュメント (Config basics) によると、[features] のうち、アプリ連携 (connectors) を有効にする apps と、サブエージェントと協調するツールを有効にする multi_agent は既定で true になっている。ウェブ検索は最上位の web_search で方式を選び、"disabled" にできる。Codex で各15回解かせた測定 (10月9日と10日) は、どれもこれらを切った設定で行った。切ったのは、入力を小さくするためだけでなく、手元のモデルに外部のサービスを操作させないためでもある。上の表の2行は、各15回の測定とは別に税込みの合計を1回ずつ解かせた記録で、各15回の測定には入っていない (1行目は切る前、2行目は10月9日の各15回と同じ切り方)。
直し方: config.toml の [features] で上の10項目を false にし、web_search を "disabled" にする (「Strataにつなぐ設定」の Codex の項の例に入っている)。
Strataにつなぐ設定
この節の3つの例は、どれもつなぎ先をこの PC の 127.0.0.1 で待つ Strata にしている。つなぎ先を別のサーバーにすると、課題文・会話・ツールで読んだファイルの中身など、モデルへの要求に入るものはそのサーバーへ送られる。
Claude Code
Strata の公式ドキュメント (v0.1.41 の docs/DETAILS.md) は、Claude Code (Strata 0.1.17 以降) をつなぐには ANTHROPIC_BASE_URL を Strata のアドレスにし、ANTHROPIC_MODEL には Claude Code が知っている Claude のモデル名を入れ、ANTHROPIC_AUTH_TOKEN に任意の値を入れる、と書いている。同じドキュメントは、Claude Code は知らない名前を受け付けず、Strata の側は名前を見ない、としている。
これらのほかに、思考設定も見ておきたいものの1つになる。Strata のドキュメント (v0.1.41 の docs/LLAMA_SWAP.md) は、Claude Code は指定しなければ毎回の要求に思考設定 high (output_config の effort) を付けて送るので Strata は最も深く考え、クライアント側の環境変数 CLAUDE_CODE_EFFORT_LEVEL を medium か low にすると変わる、と書いている。一方、Claude Code のドキュメント (Model configuration) は思考設定の既定をモデルごとに決めていて、対応するモデルの多くは high、Opus 5.5・Sonnet 5.5・Haiku 5.5 は medium、Opus 4.7 は xhigh としている。CLAUDE_CODE_EFFORT_LEVEL・起動時の --effort・セッション中の /effort で指定すれば、それが優先される。モデル名は起動時には確かめず、誤った値は最初の要求でエラーになる、とも書いている。
Claude Code 2.1.295 を --effort を付けずに起動し、送られた要求を手元で記録すると、ANTHROPIC_MODEL が claude-sonnet-5-5 と claude-opus-5-5 では effort が medium、qwen3.8-flash-next では high だった。qwen3.8-flash-next という Claude ではない名前も断られず、そのまま要求に入っていた。このとき Claude Code は警告の行 ([claude-code:unrecognized_model]) を出したが、要求は送っていて、Strata のドキュメントの「受け付けない」とは違う結果だった (モデル名ごとに1回ずつの記録で、要求は記録用のサーバーが受けただけ。Strata につないで最後まで動くかは、この記録では確かめていない)。どの思考設定が届くかはモデル名で変わるので、そろえたいときは --effort か CLAUDE_CODE_EFFORT_LEVEL で指定し、何が届いているかを記録で確かめる。
測定では --effort medium を付け、記録で確かめると、実際の要求には output_config の effort が medium と、思考を必要に応じて使う指定 (adaptive) が付いていた。出力の上限は CLAUDE_CODE_MAX_OUTPUT_TOKENS で 8192 にした。
次の例は、PowerShell の1つのウィンドウの中だけで Claude Code の接続先を Strata に向け、測定で使った指定のうち接続先・モデル名・思考設定・ツール・出力の上限にあたる部分で課題を渡すもの (Strata が既定の 127.0.0.1:8080 で待っている場合)。モデル名は Strata のドキュメントに従って Claude の名前を入れ、Strata はそれを見ない。測定では claude-sonnet-5-5 を入れた。測定ではほかに「測った課題と条件」に書いた指定を付け、課題文は英語の仕様の文で渡し、温度0は途中の中継でそろえたので、どれもこの例には反映していない。--permission-mode acceptEdits は、作業フォルダーの中であれば、ファイルの編集に加えて rm・mv・cp などのファイル操作のコマンド (PowerShell のツールが有効なら Remove-Item など) も確認なしで通す指定で、保護されたパスへの書き込みや、重要なパスを消すコマンドなどは確認が要る (この例のように -p で動かすと、確認に答える人がいないので断られる)。この例は --tools でシェルを外している。測定では使い捨てのフォルダーで使った。自分のプロジェクトで使うときは権限の設定を見直す。
$env:ANTHROPIC_BASE_URL = "http://127.0.0.1:8080"
$env:ANTHROPIC_AUTH_TOKEN = "local"
$env:ANTHROPIC_MODEL = "claude-sonnet-5-5"
$env:CLAUDE_CODE_MAX_OUTPUT_TOKENS = "8192"
claude -p "module.py の関数を仕様どおりに直して" --effort medium --tools "Read,Edit,Write,Glob,Grep" --permission-mode acceptEdits
Claude Code のドキュメント (Model configuration) によると、ANTHROPIC_BASE_URL でつなぎ先を変えても、Claude Code は Claude のモデル名 (この例では claude-sonnet-5-5) にはそのモデルが Anthropic の API で持つ文脈の長さ (Sonnet 5.5 は100万トークン) を使い、つなぎ先の上限は自動では知らない。Strata のセットアップで選んだ文脈の長さ (この記事では 262,144 トークン) を長い作業で超えないようにするには、会話を要約する境界をそれより小さい値にする (例: 同じウィンドウで $env:CLAUDE_CODE_AUTO_COMPACT_WINDOW = "200000")。この記事の課題は短く、測定ではこの指定をしておらず、長い作業での動きも確かめていない。
Strata の導入と起動の仕方、別の量子化で Claude Code を動かした結果、文脈を短くしたときに要求が断られた例は、Strata で Qwen3.8-Flash-Next を VRAM 16GB で動かした実測の記事の「Claude Codeの裏で動かす」節に、別の設定例とあわせて載せている。
Codex
Strata のドキュメントによると、Strata は 0.1.39 から OpenAI の Responses API (POST /v1/responses) を受け付け、Codex はこれでつなぐ。会話を保存しないので、クライアントが毎回会話の全体を送る。web_search などサーバー側で動かす種類のツール (hosted tools) はモデルが実行できないので外され、reasoning.effort を付けない要求はモデルの既定 (high) で考える。
同じドキュメントは、Codex の設定を ~/.codex/config.toml (Windows では %USERPROFILE%\.codex\config.toml) に書く例を載せている。model_provider を Strata 用の名前にし、[model_providers.strata] に base_url と wire_api = "responses" を書く。model_context_window は Strata のセットアップで選んだ文脈の長さにする (Codex はそこに届く前に会話を要約する)。最初の長い入力の読み込みに数分かかることがあるとして、stream_idle_timeout_ms = 600000 も入っている。model_reasoning_effort を書かなければモデルの既定 (high) で考える。
測定では、Codex を codex exec で対話なしに動かし、approval_policy を never、サンドボックスを workspace-write (書き込める場所を、作業フォルダーと、一時フォルダーなど許可された場所に限る) にして、その中のネットワークを切った。利用者の config.toml は読まず (--ignore-user-config)、設定はすべて -c で渡している。
その -c の中身を config.toml に書くと次のようになる。つなぎ先は Strata の既定の 127.0.0.1:8080 にし、測定の中継のための API キーの指定 (env_key) は除いた。model には測定で渡したモデル名 qwen3.8-flash-next-iq3_s を入れている。model_context_window は Strata のセットアップで選んだ文脈の長さに合わせる。model_catalog_json は apply_patch を渡すためのファイルを指す行で、ファイルの作り方はこの次に書いた (測定ではファイルの置き場所と中身の作り方がこの例と違う)。[features] の10項目と web_search は、測定で切ったものをそのまま並べた (理由は「Codexの失敗例と直し方」の例2)。approval_policy = "never" は承認を求めない設定で、サンドボックスの制限は外れない (Codex のドキュメント Agent approvals & security によると、never は sandbox_mode のどの値とも組み合わせられ、Codex はその値で決まる制限の中で作業する)。測定では使い捨てのフォルダーで使った。自分のプロジェクトで使うときは承認の設定を見直す。測定は利用者の config.toml を読まない指定で動かしたので、普段の config.toml にこの例を足すと、そこにある MCP サーバーなどのツールもモデルに渡りうる。例2のように、実際に渡ったツールを確かめる。末尾の stream_idle_timeout_ms は Strata のドキュメントの例にあるもので、測定では入れていない。
model = "qwen3.8-flash-next-iq3_s"
model_provider = "strata"
model_context_window = 262144
model_reasoning_effort = "medium"
model_catalog_json = "strata-catalog.json"
approval_policy = "never"
sandbox_mode = "workspace-write"
web_search = "disabled"

[sandbox_workspace_write]
network_access = false

[windows]
sandbox = "elevated"

[features]
apps = false
multi_agent = false
goals = false
plugins = false
remote_plugin = false
tool_suggest = false
image_generation = false
browser_use = false
computer_use = false
in_app_browser = false

[model_providers.strata]
name = "Strata"
base_url = "http://127.0.0.1:8080/v1"
wire_api = "responses"
stream_idle_timeout_ms = 600000
model_catalog_json は、モデルの情報を並べた JSON のファイルを指す設定で、Codex のドキュメント (Configuration Reference) には起動時に読み込む、とある。Codex 0.162.0 のソースのコメントによると、指したファイルは Codex が持っているモデルの一覧の代わりに使われる。ファイルの中で apply_patch_tool_type を "freeform" にしたモデルには apply_patch が渡る。ソースでは、シェルなどの作業の環境を操作するツールを渡す設定であることも条件で、この記事の設定はそれに当たる (シェルのツールが渡っている)。
指したファイルは一覧を丸ごと置き換えるので、ChatGPT のモデルで Codex を使うときの設定には、この行を入れない。上の例のように Strata 用の設定を config.toml に書くと普段の設定も変わるので、ChatGPT のモデルと使い分けるなら、Strata で使うときだけ起動時の -c で設定を渡す方法もある (測定では、設定をすべて -c で渡し、モデルの情報のファイルはフルパスで指した。ファイル名だけで指せることを確かめたのは、config.toml に書いた場合だけ)。
モデルの情報のファイルは、次の手順で作る。
- Windows PowerShell 5.1 のウィンドウを開く。
%USERPROFILE%\.codexのフォルダーが無ければ、先に作る (New-Item -ItemType Directory -Force "$env:USERPROFILE\.codex") - 下のコードを貼り付けて実行する。書き換えるのは、
$m(config.toml のmodelと同じ名前にする) と、context_window・max_context_window(Strata のセットアップで選んだ文脈の長さ) だけ - config.toml に
model_catalog_json = "strata-catalog.json"の行を足す (上の例には入っている)。ファイルは config.toml と同じフォルダーに書かれるので、ファイル名だけで指せる
$m = "qwen3.8-flash-next-iq3_s"
$url = "https://raw.githubusercontent.com/openai/codex/rust-v0.162.0/codex-rs/models-manager/prompt.md"
$text = (Invoke-WebRequest -UseBasicParsing $url).Content
$text = $text -replace "`r?`n", "`r`n"
$text = $text -replace '(?s)## Planning\r\n.*?(?=## Task execution)', ''
$text = $text -replace '(?s)## `update_plan`\r\n.*$', ''
$entry = [ordered]@{
  slug = $m; display_name = $m; supported_reasoning_levels = @(); shell_type = "shell_command"
  visibility = "list"; supported_in_api = $true; priority = 99; support_verbosity = $false
  apply_patch_tool_type = "freeform"; truncation_policy = @{ mode = "bytes"; limit = 10000 }
  experimental_supported_tools = @(); include_apps_usage_instructions = $false
  default_reasoning_summary = "auto"; context_window = 262144; max_context_window = 262144
  base_instructions = $text
}
$json = ConvertTo-Json @{ models = @($entry) } -Depth 5
[IO.File]::WriteAllText("$env:USERPROFILE\.codex\strata-catalog.json", $json)
このコードは、Codex 0.162.0 のソースにある指示文 (prompt.md) を GitHub から取り、手元のモデルの名前で1件だけのファイルを %USERPROFILE%\.codex\strata-catalog.json に書く。URL の rust-v0.162.0 は確かめた Codex のバージョンのタグで、ほかのバージョンの Codex では確かめていない。指示文から Planning と update_plan の2つの節を除き、改行を CRLF にしているのは、ファイルを指さないときに Codex が送る指示文とそろえるためで、書き換えるところではない。
この例のファイルと上の config.toml で Codex 0.162.0 を起動し、最初の要求を記録用のサーバーで受けて、ファイルを指さないときの要求と比べると、要求ごとに変わる ID と時刻、フォルダーのパス、サンドボックスの種類を書く欄を除くと、違いは apply_patch のツールが1つ増えたことだけだった (要求を記録しただけで、モデルにはつないでいない)。課題を解かせた測定では、中身の作り方がこの例と違うファイルを使ったが、同じように比べたときの違いは apply_patch の追加だけだった。
Windows のサンドボックス
Codex のドキュメント (Windows sandbox) によると、Windows のサンドボックスの方式は config.toml の [windows] の sandbox で mxc・elevated・unelevated から選ぶ。対応する Windows の機器でポリシーが許す場合の推奨は mxc で、elevated と unelevated は従来の方式 (legacy) として載っている。elevated は管理者が承認するセットアップを前提にしている。単体の CLI では features.prefer_mxc が既定で off になっている。
この測定では elevated にし、この PC の Codex の設定フォルダーで管理者の承認を済ませたセットアップを使って動いた (別の Codex の作業と重ならない状態で)。一方、Strata のドキュメントには、Codex CLI 0.160.0 と RTX 5070 で試したとき、Windows では Codex のサンドボックスが windows.sandbox="unelevated" を付けて起動するまでシェルのコマンドを全部拒否した、とある (Strata ではなく Codex の設定)。
Codex のシェルのコマンドがすべて断られるときは、[windows] の sandbox の値、elevated なら管理者の承認のセットアップが済んでいるか、同じ PC で別の Codex が動いていないかを見る。最後の点は、この測定で最初に測り始めたとき、別の Codex が動いている間にサンドボックスの準備が失敗したことによる (「測った課題と条件」に書いた)。
Codex を Windows で動かすときの注意点は、Codex CLI の推奨スペックとローカルサンドボックス、Windows・Node.js 環境の記事でも扱っている。
OpenCode
Strata のドキュメントは OpenCode の設定 (opencode.jsonc) の例も載せている。プロバイダーを @ai-sdk/openai-compatible で作り、baseURL を Strata の /v1 にする。limit.context はセットアップで選んだ文脈の長さにし (OpenCode はそこに届く前に会話を要約する)、limit.output はそれより十分小さくする。入力と出力の上限の合計が文脈を超える要求は断られるためだ。options の reasoningEffort は reasoning_effort として送られ、例の値は high になっている。
測定で使った OpenCode の設定のうち、つなぎ方・思考設定・権限・繰り返しの上限の部分を抜き出すと次のようになる (Strata が既定の 127.0.0.1:8080 で待っている場合)。プロバイダーの名前とモデルの名前は自由に決めてよい。
{
  "$schema": "https://opencode.ai/config.json",
  "model": "strata/qwen3.8-flash-next-iq3_s",
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata (local)",
      "options": { "baseURL": "http://127.0.0.1:8080/v1", "apiKey": "local", "timeout": 600000 },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "limit": { "context": 262144, "output": 8192 },
          "options": { "reasoningEffort": "medium", "temperature": 0 }
        }
      }
    }
  },
  "permission": {
    "*": "deny", "read": "allow", "glob": "allow", "grep": "allow", "edit": "allow",
    "bash": "deny", "external_directory": "deny", "webfetch": "deny", "websearch": "deny", "task": "deny"
  },
  "agent": { "build": { "steps": 8, "temperature": 0 } }
}
測定ではこのほか、スレッドの題名を作る要求の行き先 (small_model) も同じモデルにし、使うプロバイダーを strata だけにし (enabled_providers)、自動更新・共有・スナップショット・LSP を切っていた。普段の設定にこの例を足すときは、既にある small_model などが、この例と別の値のまま残っていないかを見る。
OpenCode のドキュメント (Permissions) によると、権限の設定名 edit はファイルの変更全般を含み、edit・write・patch のツールがこれにあたる。設定名の edit は、モデルに渡るツールの edit と同じものではない。値は allow・ask・deny で許可・確認・拒否を決め、* で全体を決めてから道具ごとに上書きでき、最後に一致した規則が使われる。steps は、OpenCode のドキュメント (Agents) によると、テキストだけで答えるよう強制されるまでに繰り返せる回数の上限で、上限に達すると、作業のまとめと残りの作業を書くよう指示される。
OpenCode を動かす PC の目安は、OpenCode の推奨スペックとローカルモデルに要る VRAM の記事にまとめている。
測った課題と条件
課題は、小さな Python の関数1つを仕様どおりに直すもの3つ。
- 税込みの合計: 税率 10% の品と 8% の品の税抜きの価格 (0以上の整数) から、税をそれぞれ十進の四捨五入 (half-up) で整数にし、価格と税を足した合計を整数で返す
- 設定の行の解析: 空行・(前の空白を除いて) # で始まる行・= の無い行・空のキーを無視し、最初の = で分け、キーと値の前後の空白を除き、後の行を優先する
- ログの ERROR の数: 名前が .log で終わるファイルだけを対象に (.LOG は対象外) ERROR を含む行を数え (大文字と小文字は区別し、1行に何回あっても1と数える)、ERROR が無いファイルも0として入れ、数の多い順・名前の順に並べ、入力を変えない
課題文は英語で、仕様の文だけを渡し、テストは見せていない。採点器は決まったテスト (5問・3問・3問) で関数を確かめ、入力が変わっていないことと、変わったファイルが module.py だけであることも見る。採点器は安全のため、使える import を限り、関数の外の代入で呼び出しを使うことを認めない。戻り値は JSON に直してから期待する値と比べるので、タプルとリストのような型の違いは区別しない。入力は、関数を呼ぶ前と後で同じかを見ている。
クライアントに渡す課題文は3つとも同じ文にした。ファイルを書き換える専用のツールで module.py だけを直すことは、課題文と作業の決まりのファイル (Claude Code は CLAUDE.md、Codex と OpenCode は AGENTS.md) の両方に書き、シェルのコマンドでファイルを書かないこと、ネットワークと作業フォルダーの外に触れないことは、作業の決まりのファイルにだけ書いた。10月9日の測定 (「Codexの失敗例と直し方」の例1) ではこの部分が違い、Codex にはシェルで module.py を読み書きするよう、Claude Code と OpenCode にはシェルを使わないよう、課題文と作業の決まりのファイルの両方に書いていた (Claude Code の作業の決まりのファイルの文面は、この日も要求に入っていない)。
記録した要求に作業の決まりのファイルの文面が入っていたのは Codex と OpenCode で (OpenCode がスレッドの題名を作らせる要求を除く)、Claude Code の要求には10月9日・10日とも入っていなかった。Claude Code 2.1.295 は、下の --restricted を付けると CLAUDE.md を読まず、外すと読むことを、モデルにつながない記録用のサーバーで確かめている。Claude Code にはシェルとネットワークのツールを渡しておらず、ファイルのツールは --restricted で作業フォルダーに限られるので、作業の決まりのうちシェル・ネットワーク・作業フォルダーの外のことはツールの側で止まっている。
サーバーは Strata 0.1.41 で、Qwen3.8-Flash-Next の IQ3_S を、最大の文脈 262,144 トークン、KV キャッシュ int8 (VRAM に置くのは 32,768 トークン分)、VRAM の余白指定 1200MiB、先読み (MTP) 4 トークンで起動した。測定機のメインメモリは 96GB で、Strata は IQ3_S のエキスパートの重み (起動ログで 46.84GiB) をメインメモリに読み込んだ。Strata の README (v0.1.41) は、メインメモリが 64GB 以上の行で IQ3_S を選べるものに挙げていて、VRAM 16GB があれば同じ条件になるわけではない。制限時間は1回 600 秒で、表と図の45回にはこの時間に達した回は無かった。
表と図の45回より前に、同じ条件で一度測り始めた。そのときは、同じ PC で別の Codex が動いている間に、測定中の Codex の Windows のサンドボックスの準備がエラー (os error 32。ファイルを別のプロセスが使っている) で失敗し、シェルのコマンドが通らなくなったため、39回で止めて全部を測り直した。止めた測定には、600秒に達した Codex の回が1回ある。測り直しでは、Codex の各回の前に別の Codex が動いていないことを確かめてから始めた。この確かめの時間は所要に入れておらず、表と図の Codex の15回とも待つことは無かった。表と図の45回は、測り直しの1回ごとの結果をそのまま使っていて、不合格だった回を取り直した回は無い。Codex のシェルのコマンドがすべて断られるときに見るところは、「Strataにつなぐ設定」の Windows のサンドボックスの注意にまとめた。
RTX 5080 の VRAM の使用量は、モデルを読み込む前の 1,482MiB から読み込んだ後は 15,589MiB になり、この PC のもう1枚の GPU (RTX 5060 Ti) は測定の前後とも 0MiB だった (nvidia-smi の記録)。エンジンの起動ログにも、GPU 0 として RTX 5080 が出ている。
思考設定はどのクライアントも medium にし、記録で確かめると、Codex の要求には reasoning.effort が medium、OpenCode の要求には reasoning_effort が medium が付いていた。温度0と出力の上限 8192 は、途中に置いた中継でそろえた。Claude Code と Codex は温度を指定せずに送ってきたので0に書き換え (OpenCode は0を送っていた)、Codex は出力の上限の指定も無かったので 8192 にした。
Claude Code には、--restricted (コマンドやコードを実行するツールを外し、ファイルのツールを作業フォルダーに限る指定)、--strict-mcp-config、--no-session-persistence、ログを取るための --output-format stream-json を付けた。OpenCode は run --pure で動かした。Codex の条件 (codex exec での実行や workspace-write のサンドボックスなど) は「Strataにつなぐ設定」の Codex の項に書いたとおり。
RTX 5080 に RTX 5060 Ti を足して2枚にしたときの Strata の動きは、Strata で2枚目の GPU を使う方法を RTX 5080+RTX 5060 Ti で比べた記事にまとめている。
測っていないものもある。デスクトップのアプリの使い勝手、会話の自動の要約、VRAM の解放、大きなリポジトリや長い作業、クラウドのモデルとの使い分け、思考設定を変えた比較は、この記事の結果からは何も言えない。思考設定を変えて比べた結果は、Strata の思考設定 none・low・medium・high を RTX 5080 で比べた記事にまとめている (Strata 0.1.40 で、この記事の3つの修正課題と同じ課題を含む16問を、クライアントを通さず API で思考設定ごとに送った測定)。課題の渡し方や、合格の数え方と所要の測り方が違うので、リンク先の記事の数字はこの記事の数字と並べて比べられない。
測定機の詳しい構成は検証環境のページに載せている。
まとめ
この PC・この課題・この設定の Strata 0.1.41 と RTX 5080 1枚で、3つのクライアントに同じ課題文で解かせると、合格は OpenCode が15回、Codex が14回、Claude Code が12回で、所要の中央値は OpenCode が17.0秒、Claude Code が20.5秒、Codex が35.1秒だった。不合格の4回は採点器の規則に当たったもので、決まったテストの範囲では関数は期待どおりの値を返していた。RTX 5080 (VRAM 16GB) 1枚とメインメモリ 96GB の PC でも、小さな修正なら3つとも手元のモデルで最後まで終えた。大きなリポジトリや長い作業は測っていない。
所要の内訳を項目ごとの中央値で比べると、Codex と他の2つの差が一番大きかったのは、エンジンの記録に残らない時間だった。Codex はファイルを読むのにもシェルを使い、指示に無い Python での確かめもシェルで試みていたが、それが所要をどれだけ延ばしたかは分けて測っていない。
Codex 0.162.0 に、Codex が持つモデルの一覧のどれにも当てはまらない名前 (手元のモデルの名前など) を渡すと apply_patch がモデルに渡らず、その状態で測った10月9日は、シェルでファイルごと書き直して BOM で不合格になった回があった。model_catalog_json で apply_patch を渡した10月10日は、書き換えはすべて apply_patch で済んだ。指示と測った日も違うので、所要や合格の差がすべて apply_patch によるとは言えない。
Strata にクライアントをつなぐときに見るものは4つある。
- 思考設定: 既定はクライアントとモデル名で変わる。Claude Code はモデル名によって送る思考設定が変わり (手元の記録では claude-sonnet-5-5 と claude-opus-5-5 で medium、qwen3.8-flash-next で high)、Codex は指定が無ければ、Strata のドキュメントによるとモデルの既定の high で考える。OpenCode の既定は確かめておらず、Strata のドキュメントの設定例は high になっている。Strata は届いた思考設定に従うので、そろえたいならクライアント側で指定し、何が届いているかを記録で確かめる
- モデルに渡るツール: Codex はログインしたアカウントのアプリ連携まで手元のモデルに渡すことがあるので、
[features]やweb_searchの設定で要るものに絞る - apply_patch: Codex 0.162.0 は、一覧のどれにも当てはまらないモデルの名前 (手元のモデルの名前など) では apply_patch を渡さないので、
model_catalog_jsonでモデルの情報のファイルを指して渡す - 文脈の長さ:
model_context_windowやlimit.contextは Strata のセットアップで選んだ文脈の長さにし、limit.outputはそれより十分小さくする。Claude Code はつなぎ先の上限を自動では知らないので、長い作業で超えないようCLAUDE_CODE_AUTO_COMPACT_WINDOWで会話を要約する境界をそれより小さくする (測定ではこの指定をしていない)
Strata で動かせるほかのモデル (Coder など) を、メインメモリの量と VRAM 12GB・16GB から選ぶ早見表は「Strataで動かせるモデルと必要なメモリ」にまとめた。
参考資料
- Strata (GitHub)
- Strata v0.1.41 docs/DETAILS.md (クライアントのつなぎ方・Responses API)
- Strata v0.1.41 docs/LLAMA_SWAP.md (Claude Code の思考設定)
- Strata v0.1.41 (リリース)
- Claude Code ドキュメント: Other LLM gateways
- Claude Code ドキュメント: Model configuration
- Codex ドキュメント: Config basics
- Codex ドキュメント: Configuration Reference
- Codex ドキュメント: Windows sandbox
- Codex ドキュメント: Sandboxing
- Codex ドキュメント: Agent approvals & security
- Codex 0.162.0 のソース: models-manager/src/manager.rs (モデルの名前と一覧の照らし合わせ)
- Codex 0.162.0 のソース: models-manager/src/model_info.rs (一覧に当てはまらないモデルの既定の情報)
- Codex 0.162.0 のソース: core/src/tools/spec_plan.rs (apply_patch を渡す条件)
- Codex 0.162.0 のソース: models-manager/prompt.md (既定の指示文)
- Codex 0.162.0 のソース: core/src/config/mod.rs (model_catalog_json の読み込み)
- OpenCode ドキュメント: Agents
- OpenCode ドキュメント: Permissions
- Microsoft Learn: about_Character_Encoding (PowerShell 5.1)
- Python ドキュメント: Lexical analysis (Encoding declarations)
- ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF (Hugging Face)