MTP

LLM量子化・軽量化

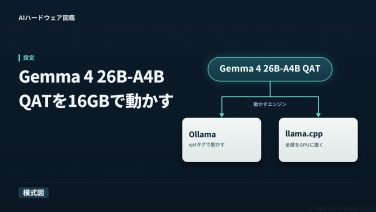
Gemma 4 26B-A4BのQATをVRAM 16GBで動かす|Ollamaとllama.cppのどちらを使うか

Ollama の qat タグ ( gemma4:26b-a4b-it-qat ) は RTX 5080 1 枚で 8K から 256K まで動いたが、この記事の Ollama の設定では、どの文脈長でも 16GB の GPU に全部は載らず、一部が CPU 側に回った。
Strata

Strataで125BのQwen3.8-Flash-NextをVRAM 12GB・16GBで実測|素のllama.cpp・27B・Claude Codeとも比較

VRAM 12GB・16GBのGPU 1枚とメインメモリ96GBの検証環境で、125BのQwen3.8-Flash-NextをStrataと素のllama.cppで実測。RTX 5080・5060 Ti・4070 SUPERでの速さ、2枚目のGPUの分け方、量子化の違い、Qwen3.8-27BやClaude Codeとの比較をまとめた。
ローカルLLM

Qwen3.8-27BのMTPは16GBで速くなるか|有効化で増えるVRAMと、速くならない条件を実測

Qwen3.8-27BのMTP(マルチトークン予測)を16GBのGPU1枚で実測。有効化でのGPU使用量の増分と速度変化は対応したが、開始時の空きと実配置も同時に違うため、増分が原因とは判定できない。KVキャッシュの型を落とすと結果が変わる例も測った。
GPU・グラフィックボード

MTP(マルチトークン予測)でローカルLLMは本当に速くなるか|RTX 5080実測、非MoEで1.69倍・MoEは1.0〜1.4倍と構成次第

MTP(マルチトークン予測)でローカルLLMが何倍速くなるかをRTX 5080で実測。非MoEのgemma-4-12bは1.69倍、MoEは1.0〜1.4倍と量子化・GPU構成で振れる。効きを分けるのは1順伝播あたりのボトルネック(帯域/GPU間の受け渡し待ち)をMTPが薄められるか。llama.cppの実測で解説。