LLM量子化・軽量化

LLM量子化・軽量化

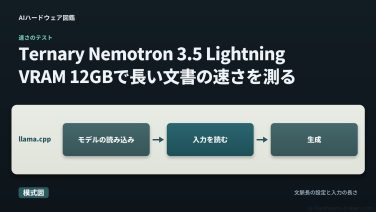
Ternary Nemotron 3.5 LightningをVRAM 12GBで動かす|長い文書でも速さは保てるか

RTX 4070 SUPER(VRAM 12GB)1枚でTernary Nemotron 3.5 Lightningを実測。文脈長368,640の設定でも全層をGPUに置く指定のまま動いた。29万トークンの入力は読み込みに約2分かかり、そのあとの生成は短い入力の約3割に落ちた。
LLM量子化・軽量化

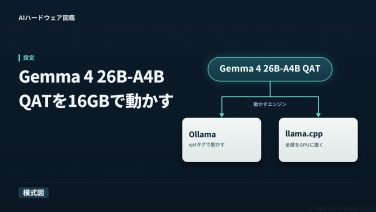
Gemma 4 26B-A4BのQATをVRAM 16GBで動かす|Ollamaとllama.cppのどちらを使うか

Ollama の qat タグ ( gemma4:26b-a4b-it-qat ) は RTX 5080 1 枚で 8K から 256K まで動いたが、この記事の Ollama の設定では、どの文脈長でも 16GB の GPU に全部は載らず、一部が CPU 側に回った。
LLM量子化・軽量化

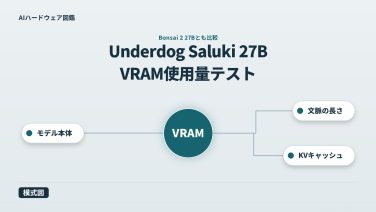
Underdog Saluki 27BはVRAM何GBで動くか|文脈長ごとの使用量、Ollama・LM Studioでの読み込み、Bonsai 2 27Bとの違い

Underdog Saluki 27B(Qwen3.8-27Bを8GB未満にしたGGUF、IQ2-mix)をRTX 5060 Ti・5080で実測。文脈の長さごとのVRAM、生成の速さ、Ollama・LM Studioでの読み込み、Claude Codeと税計算の結果をBonsai 2 27Bと並べた。
GPU・グラフィックボード

Bonsai 2 27BはVRAM 16GBで動くか|公称5.9GBの中身と、専用ビルドが要る理由を実測

PrismML が公開した Bonsai 2 27B を RTX 5080 16GB 単体で実測。標準の llama.cpp では読み込めず専用ビルドが要ること、配布される PTQ1_0 と PQ2_0 でプロンプト処理と生成の差の出方が変わること、公称5.9GBがどのファイルの値かを整理した。
GPU・グラフィックボード

量子化で27B級LLMはVRAM 16GBに載るか|1bit・Ternary圧縮の実力と精度の代償

27B級LLMは1bit・Ternary(三値)の極低ビット量子化なら、重みを約3.8〜7.2GBまで圧縮してVRAM 16GBに載せられます。ただし精度はFP16比で約9割前後に低下し、長文ではKVキャッシュ量が可否を左右するため、理想サイズと実行時ピークメモリの区別が要点になります。