この記事の要点
測った RTX 5080 と RTX 5060 Ti のどちらでも、配布されているテンプレートの設定のまま最後まで動き、VRAM の使用量はカードの半分前後だった。
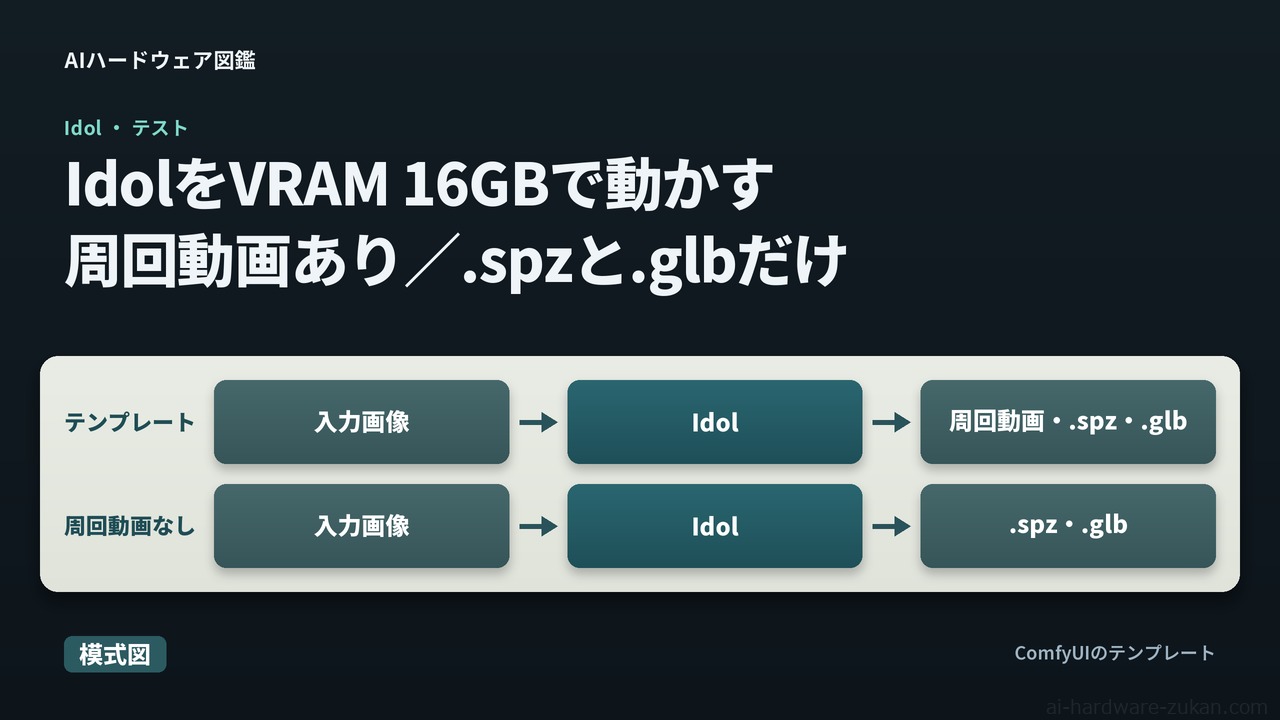
周回動画を成果物として使わないなら外せて、周回動画を外しプレビューも切って残りの出力を書き出すと、20ステップの条件で1枚の時間の中央値は半分以下になる。周回動画そのものを使う場合は外せない。
配布元が冒頭に書いている速さは、どの条件の値かが示されておらず、配布元自身の速度表にもその速さの行は無いため、手元の時間を見積もる材料にはならない。
初めて試す場合は「周回動画を外すと何秒になるか」まで読めば、周回動画を外したときの時間が分かる。.glb を残すかどうかはファイルの大きさも関わるので、「.glbの解像度と被写体による大きさの違い」の節もあわせて見るとよい。使ったソフトのバージョン、入力の画像、試行回数、試していない条件は「検証環境と測り方」にまとめた。
IdolはVRAM 16GBで動くか
16GBのカード2枚 (RTX 5080 と RTX 5060 Ti) のどちらでも、公式テンプレートの設定のまま、8枚すべてで周回動画を含む3つの出力が最後まで出た。VRAM 使用量のピークはカード全体の値で RTX 5080 が最大6.7GiB (画面出力の分を含む)、RTX 5060 Ti が最大8.5GiBで、どちらも16GBのカード (nvidia-smi の表示で約15.9GiB) の半分前後だった (RTX 5060 Ti の最大は約15.9GiBの約53%)。テンプレートのままの1枚の時間は RTX 5080 で55.0秒、RTX 5060 Ti で68.9秒 (中央値) で、20ステップのまま周回動画を外しプレビューも切ると、RTX 5080 では約39秒 (テンプレートのままの約71%) 短くなって残りは3割弱、RTX 5060 Ti では約36秒 (約53%) 短くなって残りは5割弱になった。
周回動画を外しプレビューも切って、残りの2つの出力を書き出した1枚 (中央値) は、RTX 5080 で15.8秒、RTX 5060 Ti で32.6秒だった。出力をさらに1つ外して1つだけにしても15.2秒と31.8秒で、中央値で1秒未満しか縮まない。周回動画を外した条件ではサンプリングのプレビューも切っているので、縮んだ分にはプレビューの分 (生成の処理の時間で2秒前後) も入っている。
RTX 5060 Ti は OCuLink(PCIe の信号をケーブルで外へ出す接続の規格で、外付けの GPU ボックスをつなぐのに使われる)で外付けした構成で測った。
Idolとは: 元のTripoSplatとの関係とライセンス
Idol は Speridlabs が公開した、1枚の画像から3Dガウシアンスプラット(立体を、色と大きさを持つ小さなぼかしの粒 (ガウシアン) をたくさん空間に置いて表す方式で、ポリゴンのメッシュとは別の表し方)を作るモデルで、配布元の Hugging Face のモデルカードが表示しているライセンスは Apache-2.0。配布元の SDK の README には、Idol は TripoSplat を土台にしていると書かれている。
元の TripoSplat は VAST-AI が公開したモデルで、GitHub のリポジトリにはコードと重みが MIT ライセンスだと書かれている。
ComfyUI(画像生成などのモデルを、ノードをつないだワークフローで動かすオープンソースのソフト)用には、Comfy-Org が Idol の重みを ComfyUI の形式にまとめ直したもの (Comfy-Org/Idol) が配布されている。そのモデルカードは Idol を TripoSplat を微調整したものとし、既存の TripoSplat のワークフローで動くと書いている。何を学習し直したのか (データや手法) は、どちらのモデルカードにも書かれていない。ComfyUI のテンプレートの注記は Idol を Comfy-Org による TripoSplat の微調整と書き、スタイライズされたキャラクターや小物の読み取りが良いとしているが、根拠は示されていない。Hugging Face の Comfy-Org/Idol は元のモデルとして speridlabs/idol を挙げていて、注記とは書き方がそろっていない。
ComfyUI のテンプレートは、結果を .spz(ガウシアンスプラットを圧縮して保存するファイルの形式)と、メッシュに変換した .glb(ポリゴンのメッシュを保存する一般的な3Dファイルの形式で、Blender やゲームエンジンなどで読み込める)で保存し、ほかに周回動画も書き出す。
部品ごとのライセンス表示
Apache-2.0 は Idol の配布の表示で、動かすのに使う部品の元の配布元は、それぞれ別の条件を表示している。各リポジトリの表示を「ライセンス表示の一覧」の表に並べた。
| 対象 | 表示されているライセンス (2026-11-07 時点) |
|---|---|
| Idol (speridlabs/idol) | Apache-2.0 |
| Comfy-Org/Idol (ComfyUI 用にまとめ直した配布。モデルカードの表示) | Apache-2.0 |
| 元の TripoSplat (VAST-AI) | MIT (コードと重み) |
| 画像のエンコーダ DINOv3 の元の配布 (Meta) | DINOv3 License |
| FLUX.2 [dev] のモデル本体 (SDK がアクセス申請を求めるリポジトリの表示) | FLUX Non-Commercial License |
| 背景除去の BiRefNet (ComfyUI 用の再配布 Comfy-Org/BiRefNet の表示) | MIT |
ComfyUI の構成が使う FLUX.2 のファイルは VAE だけで、Black Forest Labs の GitHub は autoencoder (VAE) を Apache 2.0、FLUX.2 [dev] のモデル本体を Non-Commercial と書き分けている。
Idol 本体や ComfyUI 用の配布 (Comfy-Org/Idol) が Apache-2.0 を表示していても、含まれる DINOv3 の元の配布元は別の条件を表示していて、表示はそろっていない。商用・非商用を問わず、使い方や再配布の形によっては、ComfyUI 用の配布の表示だけでなく元の配布元の条件も確かめる必要がある。再配布側の表示だけで、含まれる各ファイルの条件が一律に決まるとは言えない。この記事では、商用で使えるかどうかの判断はしていない。
ComfyUIのテンプレートと必要なファイル
ComfyUI の公式テンプレート「Idol: Image to Gaussian Splat」(テンプレート一覧の 3D Model にある) は、入力画像1枚の背景を取り除いてから生成し、周回動画 (1024×1024・75コマ・25fps)・.spz・.glb の3つを出す。テンプレートの注記では、3つの枝がすべて有効になっている。
生成の設定の既定値
生成の本体はサンプラー(ノイズから少しずつ結果を作っていく処理で、ステップ数はその繰り返しの回数)で、seed(生成の出発点になる乱数の値で、同じ設定でも seed を変えると結果が変わる)もテンプレートで固定されている。テンプレートに入っている値を「テンプレートの既定値」の表にまとめた。
| 項目 | テンプレートの値 |
|---|---|
| ステップ数 | 20ステップ |
| サンプリングの方式 | dpmpp_2m・simple |
| CFG | 3 |
| seed (サンプラー) | 46 |
| seed (デコード) | 790219963981395 |
| ガウシアンの数 | 262,144 |
.glb の解像度 (SplatToMesh) |
384 |
| 周回動画 | 1024×1024・75コマ・25fps |
サンプリングのプレビュー (enable_preview) |
あり |
time shift(ノイズを減らしていく刻み方を調整する設定)はテンプレートの項目には無く、ComfyUI 0.44.0 では TripoSplat 系のモデルの既定として 3.0 が入っている。配布元の SDK の既定と同じ値になる。
テンプレートの注記は、ガウシアンの数 262,144 は八分木(空間を8つずつ区切っていき、点の置き場所を決める仕組み)の密度に合った値で、増やしても既存の点を重ねて密にするだけで細部は増えず、VRAM と時間がかかるとしている。.glb の出力についても、解像度 384 では数百万ポリゴンになり重いと書いている。どちらも後の節で実測と並べる。
既知の限界として注記が挙げているのは、正面はよく再現されるが側面と背面は推定であり、弦・手すり・毛のような細い部分は痩せたり、取り除いた背景の色を拾ったりする、という点。
必要なファイルと置き場所
テンプレートの注記は、先に ComfyUI を更新しておくよう書いている。動かすのに必要な最低のバージョンは確かめておらず、この記事は 0.44.0 で測った。
必要なファイルは5つで、テンプレートの注記 (Model Links) は置き場所を ComfyUI の models フォルダの下としている。生成本体のほかに、画像のエンコーダとデコーダ(生成本体が作った中間の表現を、ガウシアンの粒の並びに変換する部品)などが要る。ファイルごとの置き場所と取得元を「必要なファイル」の表に並べた。
| ファイル | 置き場所 (models の下) |
取得元 | 役割 |
|---|---|---|---|
birefnet.safetensors |
background_removal |
Comfy-Org/BiRefNet | 背景除去 |
idol_fp16.safetensors |
diffusion_models |
Comfy-Org/Idol | 生成本体 |
dino_v3_vit_h_bf16.safetensors |
clip_vision |
Comfy-Org/Idol | 画像のエンコーダ (DINOv3) |
idol_decoder_fp16.safetensors |
vae |
Comfy-Org/Idol | デコーダ |
flux2-vae.safetensors |
vae |
Comfy-Org/Idol | FLUX.2 の VAE |
注記に書かれた合計は3.52GBで、これはファイルのバイト数を1024で割っていった値。5つのファイルのバイト数をそのまま足すと、約3.78GB (10の9乗バイトを1GBとした値) になる。
配布元の SDK で動かす場合は、Hugging Face でアクセス申請が要る2つのモデル (DINOv3 と FLUX.2 [dev]) の許可を先に得る必要があると README に書かれている。ComfyUI 用の Comfy-Org/Idol には、DINOv3 と FLUX.2 の VAE のファイルが含まれている。
出力の枝と止め方
3つの出力は、ワークフロー上で別々のグループに分かれている。グループ名と出力の対応を「出力のグループ」の表に示す。
| グループ名 | 出す物 |
|---|---|
| Create Video | 周回動画 |
| Create 3D Model | .spz |
| Create 3D Model (experimental) | .glb |
.spz と .glb の保存ノードはどちらも SaveGLB という種類で、.spz を出す側は SplatToFile3D、.glb を出す側は SplatToMesh の後ろにつながっている。保存ノードの種類が同じなので、どちらの出力かは前につながったノードかグループ名で見分ける。サンプリングのプレビューは、『Image to Gaussian Splat』サブグラフの enable_preview で切り替える。
ComfyUI は出力のノードにつながる処理だけを実行するので、要らないグループのノードを無効 (バイパスかミュート) にすれば、その枝の描画やメッシュ化も実行されないと考えられる。この記事の測定では、外した出力の処理を実行対象から除いて測っており、画面でグループを無効にする操作そのものは試していない。
テンプレートのままの時間と内訳
1枚の時間を区間に分けると、RTX 5080 では周回動画の描画が最も長く、RTX 5060 Ti では生成が RTX 5080 の約2倍かかる分、生成と周回動画の描画が並ぶ。テンプレートの設定のまま8枚を各2回流し、モデルを読み込んだ後の回 (各 GPU 15回) の中央値を「テンプレートのままの時間と内訳」の表にまとめた。
| GPU | 1枚の時間 (中央値) | 最短〜最長 | うちサンプラー | うち周回動画の描画 | うち保存と形式変換 |
|---|---|---|---|---|---|
| RTX 5080 | 55.0秒 | 43.4〜76.1秒 | 15.2秒 | 26.4秒 | 2.4秒 |
| RTX 5060 Ti (OCuLink 接続) | 68.9秒 | 60.9〜76.5秒 | 29.9秒 | 28.5秒 | 6.8秒 |
1枚の時間は、ComfyUI がワークフローの実行を始めたと知らせた時刻から、実行が終わったと知らせた時刻までの差で、ワークフローを送る時間や実行が始まるまでのキュー待ち、画像を読み込ませる操作や結果を確かめる時間は含まない。最短〜最長の幅には、被写体の違いと回ごとの揺れの両方が入っている。内訳の3列は列ごとの中央値なので、足しても1枚の時間にはならない (背景除去・画像のエンコード・デコードなど列に出していない処理と、ノードの合間の時間が残る)。
RTX 5060 Ti は生成 (サンプラー) に RTX 5080 の約2倍かかり、内訳の中では生成 (29.9秒) と周回動画の描画 (28.5秒) がほぼ同じ長さになる。RTX 5080 では周回動画の描画 (26.4秒) が最も長い。一方、周回動画の描画は2枚の GPU でほぼ同じだった。周回動画の描画の列は、カメラの設定・描画 (RenderSplat)・動画化 (CreateVideo) の合計。保存の列は、周回動画・.spz・.glb の3つを書き出すノードと、.spz の形式に変換するノード (SplatToFile3D) の合計で、ノード別に見ると .glb の保存は1秒未満、周回動画の保存は1〜17秒と回によって大きく揺れた。揺れの原因は切り分けていない。
RTX 5060 Ti は OCuLink (PCIe 4.0 x4) で外付けした構成で、サンプラーの差が GPU の違いによるのか接続の違いによるのかは切り分けていない。通常の PCIe スロットに挿した RTX 5060 Ti は測っていない。
ComfyUI を起動して最初の1枚 (モデルの読み込みを含む) は、同じ画像の2回目より、RTX 5080 でも RTX 5060 Ti でも約4秒長かった。テンプレートの見本 (シロクマ) の1回目と2回目で比べた値で、重みは測定機の SSD に置き、事前に1度読み込んだ後だったため、OS のファイルキャッシュに載っていた可能性がある。
周回動画を外すと何秒になるか
どの出力を残すか
周回動画を成果物として使わないなら外せる。外すと、出来の確認は周回動画ではなく .spz や .glb を別に開いて行うことになり、その手間や見え方は測っていない。.spz と .glb を残し、周回動画を外してプレビューも切ると、1枚の時間は RTX 5080 で15.8秒、RTX 5060 Ti で32.6秒だった。テンプレートのままより RTX 5080 では約39秒 (テンプレートのままの約71%) 短くなって残りは3割弱、RTX 5060 Ti では約36秒 (約53%) 短くなって残りは5割弱で、どちらも20ステップの条件で中央値が半分以下になった。同じ画像・同じ回どうしを組にして比べると、RTX 5060 Ti では15組のうち4組で、周回動画を外した側の時間がテンプレートのままの半分をわずかに上回った (50.1〜52.9%)。別の3枚で測ったプレビューの分 (約1.8秒) を、周回動画を外した時間に単純に足し戻すと、RTX 5060 Ti はテンプレートのままのちょうど半分前後になる。これは計算上の値で、周回動画だけを外してプレビューを残した条件は測っていない。
RTX 5080 で縮んだ約39秒は、内訳の表の周回動画の描画 (26.4秒) を上回る。条件どうしの中央値の差なので、プレビューの有無や保存の時間の揺れも入っていて、差のうちどれだけが周回動画の出力を外した分かは分解していない。
.glb も外して .spz だけにすると、RTX 5080 で15.2秒、RTX 5060 Ti で31.8秒で、1枚の時間の中央値の差は RTX 5080 で0.6秒、RTX 5060 Ti で0.8秒だった。条件どうしの中央値の差で、回ごとの差がいつも1秒未満という意味ではない。測った範囲では、.glb を残すか外すかで時間はほとんど変わらない。ファイルの大きさは別で、.glb の節で扱う。周回動画そのものを成果物として使う場合は外せない。.glb とプレビューを外して周回動画を残す条件では、RTX 5080 で46.5秒かかった (元の TripoSplat と比べた表の Idol の行で、8枚を1回ずつ流した7回の中央値)。
周回動画を外した条件では、サンプリングのプレビューも切っている。縮んだ分には出力を外した分とプレビューを切った分の両方が入っていて、プレビューの分はサンプラーの時間で、同じ3枚で RTX 5080 が約2.6秒、RTX 5060 Ti が約1.8秒だった。この条件を ComfyUI の画面で再現するには、周回動画のグループ (Create Video) のノードを無効にし、「Image to Gaussian Splat」サブグラフの enable_preview も切ると考えられる。画面での無効化そのものは試していない。
出力とステップ数ごとの1枚の時間
20ステップはテンプレートの設定 (dpmpp_2m・simple・CFG 3)、50ステップはステップ数とサンプリングの方式を配布元の SDK の既定に近づけた参考の設定 (50ステップ・CFG 3、サンプリングの方式は Euler・simple) で、どちらも8枚を各2回流し、モデルを読み込んだ後の回の中央値をとった。テンプレートのまま以外の行は、外した出力の処理を実行せず、プレビューも切った条件。出力の組み合わせとステップ数で1枚の時間がどう変わるかを「設定・出力別の1枚の時間」の表と図に示す。
| 設定 | 1枚の時間 |
|---|---|
| RTX 5080・テンプレートのまま | 55.0秒 |
| RTX 5080・.spzと.glb・20ステップ | 15.8秒 |
| RTX 5080・.spzだけ・20ステップ | 15.2秒 |
| RTX 5080・.spzだけ・50ステップ | 32.6秒 |
| RTX 5060 Ti・テンプレートのまま | 68.9秒 |
| RTX 5060 Ti・.spzと.glb・20ステップ | 32.6秒 |
| RTX 5060 Ti・.spzだけ・20ステップ | 31.8秒 |
| RTX 5060 Ti・.spzだけ・50ステップ | 72.7秒 |
20ステップでは、.spz だけの行と .spz と .glb の行は1秒未満しか違わない。1枚の時間が大きく変わるのは、周回動画を出すかどうかと、ステップ数を変えたとき (50ステップの行はサンプリングの方式も同時に変えている) だった。
50ステップにすると
配布元の SDK の既定に近づけて 50ステップ・Euler にすると、.spz だけで1枚 RTX 5080 が32.6秒、RTX 5060 Ti が72.7秒で、20ステップの約2.1倍と約2.3倍かかった。RTX 5060 Ti では、テンプレートのまま (20ステップ・3つの出力) の68.9秒より長い。周回動画を外して半分以下になったのは、20ステップで測った結果。50ステップで周回動画を付けた条件は測っていないので、50ステップでも同じ割合になるかは分からない。50ステップ・.spz だけの時間を20ステップのテンプレートのままと並べると、RTX 5080 は32.6秒で、テンプレートのままの55.0秒の半分以下にはならず、RTX 5060 Ti は72.7秒で、テンプレートのままの68.9秒より長い。これはステップ数と出力を同時に変えた比較で、周回動画を外す効果そのものではない。
この50ステップは、ステップ数とサンプリングの方式を同時に変えた条件で、SDK そのものでは測っていない。CFG の数値の意味も SDK と ComfyUI で違う。SDK の式は「条件付きの予測 ×(1+CFG) − 条件なしの予測 ×CFG」で、この式の係数に合わせると、SDK の CFG 3 は ComfyUI の CFG 4 にあたる。この行は ComfyUI に同じ値をそのまま入れて流したので、SDK の既定の再現ではない。SDK の既定の time shift 3.0 は、ComfyUI 0.44.0 ではモデル側の既定として入っている。20ステップと50ステップで見た目がどれだけ違うかは比べていないので、50ステップで出来が良くなるかどうかは、この結果からは言えない。
この50ステップの値は、配布元の速度表と同じ物差しの数字にはならない。理由は配布元の速度表を扱う節で説明する。
プレビューを切った分
プレビューはサンプリングの途中経過を画面に出すための処理で、切るとサンプラーの時間が縮む。テンプレートの設定 (20ステップ・3つの出力) で、同じ3枚 (シロクマ・レインコートの人物・猫のフィギュア) を各2回流し、モデルを読み込んだ後の5回の中央値を「プレビューの有無とサンプラーの時間」の表に示す。
| GPU | プレビューあり (テンプレートのまま) | プレビューなし |
|---|---|---|
| RTX 5080 | 15.3秒 | 12.7秒 |
| RTX 5060 Ti | 29.8秒 | 28.0秒 |
縮み方は RTX 5080 のほうが大きかった。同じ seed なら、プレビューの有無にかかわらず .spz のファイルの大きさは一致した。.glb と周回動画の中身は比べていない。1枚の時間は保存の揺れがプレビューの有無の差より大きかったため、表にはサンプラーの時間だけを載せた。
VRAMとメインメモリの使い方
テンプレートのままの条件で、VRAM とメインメモリに加えて、共有GPUメモリ(GPU も使えるメインメモリの領域で、VRAM が足りないときの退避先にもなる)の量を測り、値を「VRAM とメインメモリの使用量」の表に示す。
VRAM は nvidia-smi で見たカード全体の使用量で、同じ GPU に載っている他のプロセスの分も含む。PyTorch の予約量は、ComfyUI のプロセスの中で PyTorch が GPU から確保した量の最大値 (PyTorch の max_memory_reserved の値。使っていない分のキャッシュも含むので、実際に使われている量とは違う)、共有GPUメモリは Windows の計測機能 (パフォーマンスカウンタ) の値。メインメモリは、ComfyUI のプロセスのワーキングセット(プロセスが実際に物理メモリに載せている量)の最大値をとった。
| GPU | VRAM使用量のピーク (中央値) | VRAM使用量のピーク (最大) | 初回の実行前の使用量 | PyTorch の予約量 (最大) | 共有GPUメモリ (最大) | メインメモリ (最大) |
|---|---|---|---|---|---|---|
| RTX 5080 | 6.0GiB | 6.7GiB | 0.8GiB | 4.8GiB | 0.4GiB | 6.2GiB |
| RTX 5060 Ti | 5.8GiB | 8.5GiB | 0.1GiB | 4.8GiB | 0.3GiB | 6.3GiB |
共有GPUメモリはどちらも最大0.3〜0.4GiBで、大きな使用は見られなかった。ただし、この値だけでは、VRAM 不足による退避や、ComfyUI がモデルをメインメモリ側へ移したかどうかまでは言い切れない。メインメモリも2枚の GPU でほぼ同じ量だった。初回の実行前 (ComfyUI を起動した後、モデルを読み込む前) のカード全体の使用量は、RTX 5080 が約0.8GiB、RTX 5060 Ti が約0.1GiBだった。RTX 5080 は画面出力にも使っていて、表のピークはこの分を差し引いていないカード全体の値。RTX 5060 Ti は画面を出していない。
RTX 5060 Ti のピークは回によって5.2GiB〜8.5GiBの間で揺れ、同じ画像の2回でも違った。中央値は5.8GiBと RTX 5080 の6.0GiBでほぼ並び (RTX 5080 は初回の実行前から0.8GiBを使っている)、最大だけ RTX 5060 Ti が高い。カード全体の使用量には他のプロセスの分も入るが、揺れの理由は切り分けていない。
50ステップやガウシアンを最大にした条件を含め、Idol の重みで測ったどの条件でも、ピークは RTX 5080 で7.2GiB、RTX 5060 Ti で8.5GiBを超えなかった。ピークはカード全体の最大値で、Idol が必要とする最小量ではない。12GB や 8GB のカードで動くかどうかは測っていない。
配布元はピークを7.2GBとしているが、測り方は書かれておらず、この表の値と測り方が同じとは限らない。
画像生成や動画生成、LLM ではそれぞれ VRAM がどれだけ要るのかを比べたい場合は、生成AI用グラボの選び方の記事で用途別に整理している。
被写体ごとの出来と、元のTripoSplatとの比較
ここで言えるのは、RTX 5080・テンプレートの設定で各被写体を1つの seed (アニメ調のキャラクターだけは3つ) で作り、周回動画を目で見た範囲まで。画質を数値で評価してはいない。
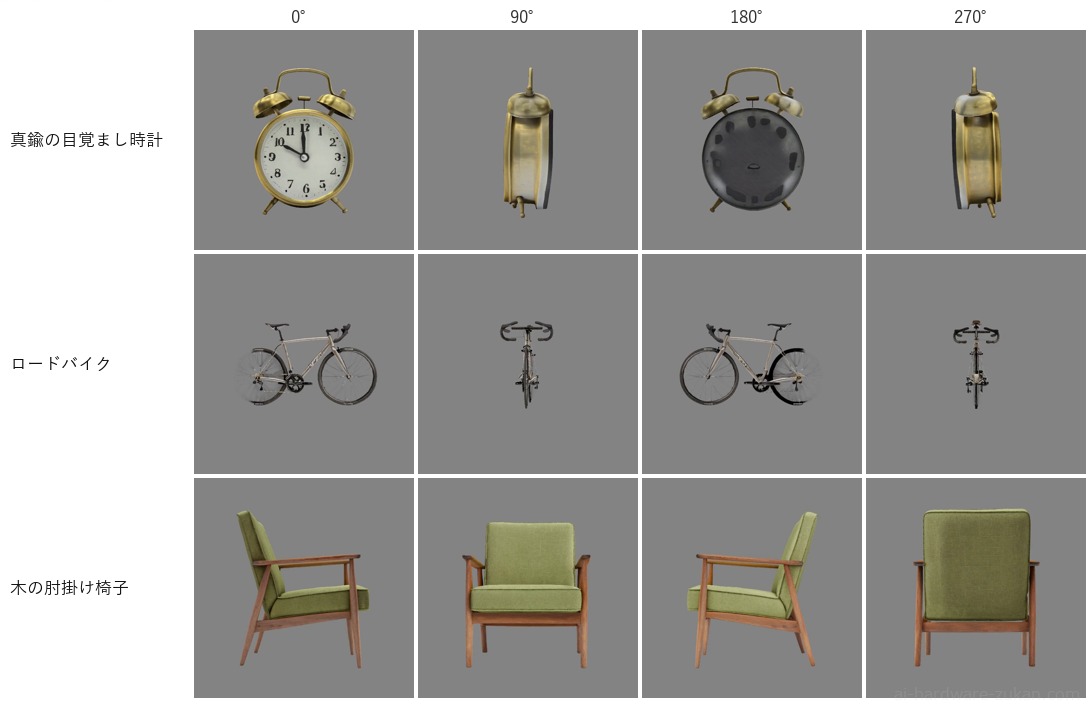
seed 46 の周回動画では、人物・椅子・時計・フィギュアは、正面だけでなく側面と背面の形も推定で作られていた。テンプレートの注記が既知の限界として挙げる「側面と背面は推定」という点と同じ見え方になる。
真鍮の目覚まし時計の背面は、文字盤の無い灰色の板として作られた。ロードバイクは後輪がにじみ、スポークの一部が消えた。注記にある、細い部分が痩せるという限界と重なる崩れ方になる。木の肘掛け椅子も、側面と背面の形は推定で作られている。
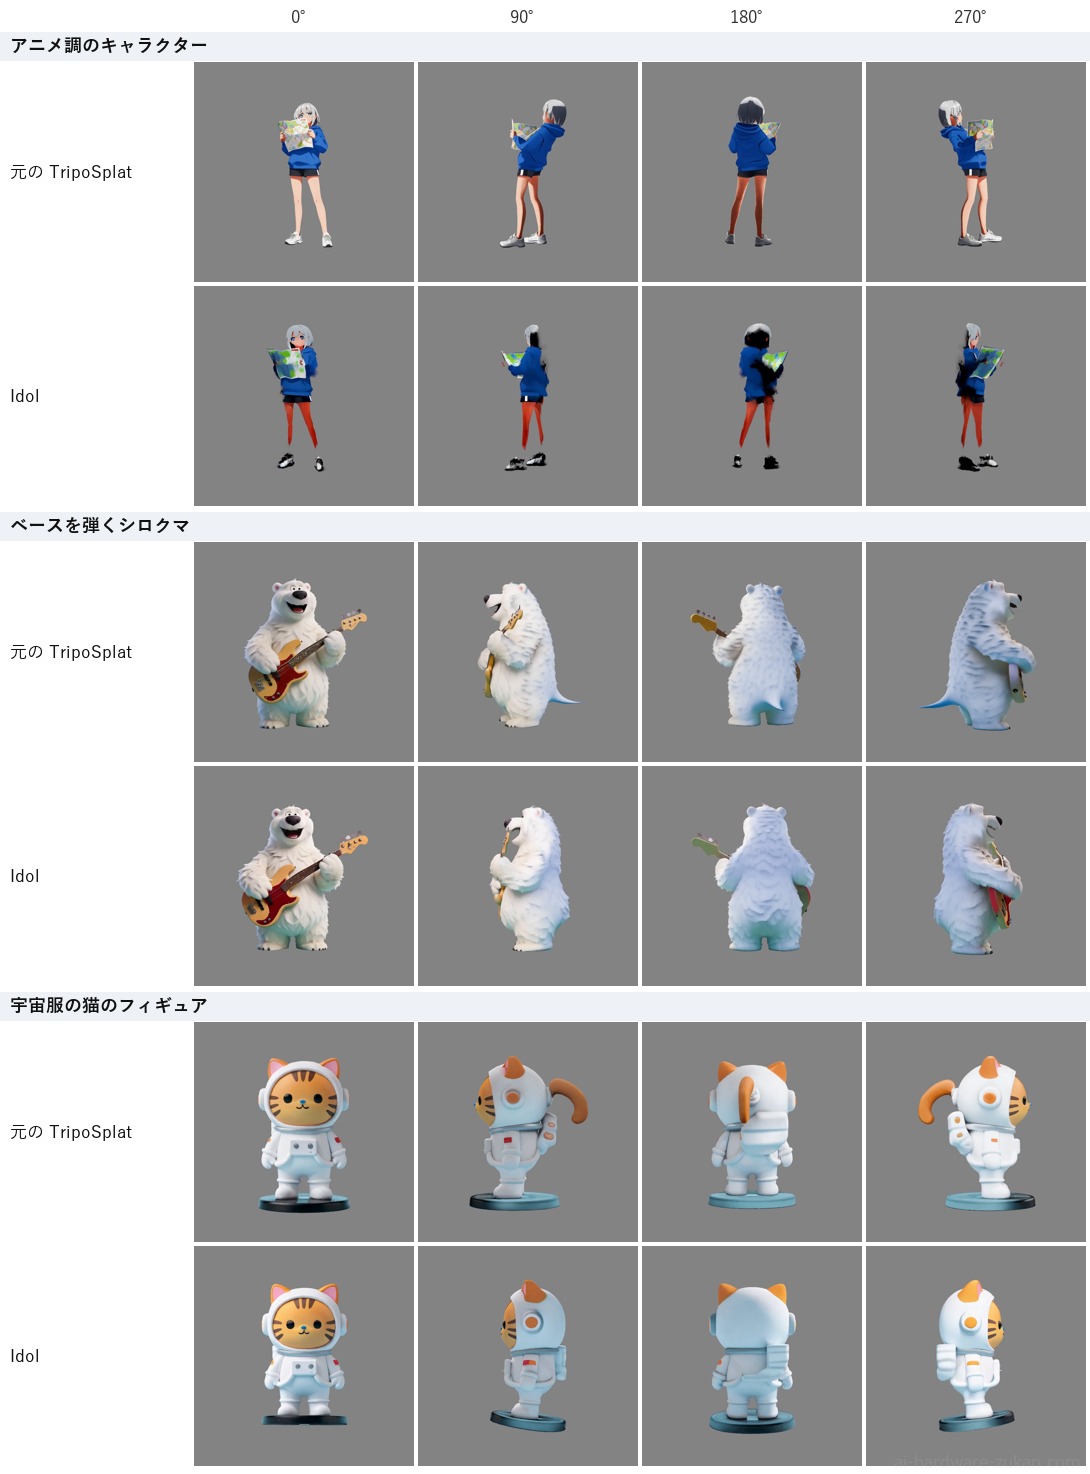
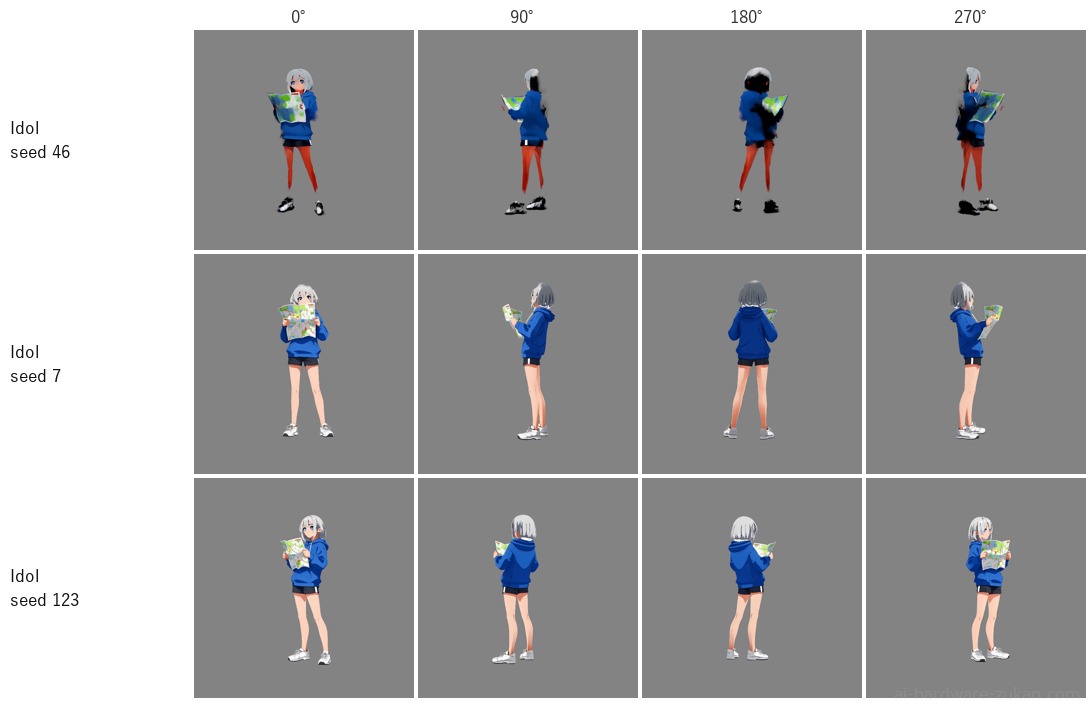
重みだけを元の TripoSplat に替えて同じ seed 46 で並べると、アニメ調のキャラクターは Idol で脚の色が赤く変わり、靴が脚から離れ、頭の後ろと背中に黒いにじみも出たが、元の TripoSplat では形は崩れなかった。一方、シロクマと猫のフィギュアでは、元の TripoSplat の側面と背面に、元の画像に写っていない尻尾のような突起が出て、Idol では出なかった。この枚数と seed の数では、どちらの重みが全体として優れているかは言えない。
時間も同じ条件で比べた。RTX 5080・テンプレートの設定 (20ステップ・seed 46) でプレビューを切り、出力は .spz と周回動画にして、重みだけを入れ替えている (画像のエンコーダと背景除去は共通)。同じ8枚を1回ずつ流し、モデルを読み込んだ後の7回の中央値を「重み別の1枚の時間」の表に示す。
| 重み | 1枚の時間 | うちサンプラー | うち周回動画の描画 |
|---|---|---|---|
| 元の TripoSplat | 37.4秒 | 12.6秒 | 17.1秒 |
| Idol | 46.5秒 | 12.6秒 | 25.9秒 |
サンプラーはどちらも同じ構造のモデルを同じステップ数で回していて、時間は12.6秒と12.6秒で同じだった。1枚の時間は Idol のほうが約9秒長く、その差はほぼ周回動画の描画の差だった。描画が長くなった理由は切り分けていない。
アニメ調のキャラクターをサンプラーの seed 7 と seed 123 で作り直すと (デコードの seed は固定)、Idol でも崩れなかった。1つの seed で崩れた被写体でも、seed を変えて作り直すと結果が変わることがある (確かめたのは、この1体を3つの seed で作った範囲)。
ガウシアンの数を増やすと
ガウシアンの数はテンプレートの num_gaussians で指定する。テンプレートの設定 (20ステップ) でプレビューを切り、出力を .spz と周回動画にして、同じ3枚を各2回流し、モデルを読み込んだ後の5回の中央値 (VRAM は最大) を「ガウシアンの数と時間・大きさ」の表に示す。RTX 5060 Ti の 262,144個の行だけは .glb も出した条件で、1,048,576個の行とは出力の組み合わせが1つ違う。
| GPU | ガウシアンの数 | サンプラー | 周回動画の描画 | .spz の大きさ | VRAM使用量のピーク (最大) |
|---|---|---|---|---|---|
| RTX 5080 | 262,144個 (テンプレートの値) | 12.7秒 | 26.5秒 | 3.1MB | 7.0GiB |
| RTX 5080 | 1,048,576個 (最大) | 12.7秒 | 29.4秒 | 11.5MB | 6.2GiB |
| RTX 5060 Ti | 262,144個 (テンプレートの値・.glb も出力) | 28.0秒 | 27.8秒 | 3.1MB | 8.5GiB |
| RTX 5060 Ti | 1,048,576個 (最大) | 28.1秒 | 88.1秒 | 11.5MB | 8.5GiB |
ガウシアンを最大にしても、サンプラーの時間はほぼ変わらず、.spz の大きさと周回動画の描画のほか、デコードと .spz への変換の時間も増えた (RTX 5080 でデコードが0.5秒から1.3秒、変換が0.6秒から2.5秒)。周回動画の描画は RTX 5080 では少し伸びただけだったが、RTX 5060 Ti では88.1秒まで伸びた。VRAM のピークと共有GPUメモリはどちらの GPU でも 262,144個のときと同じ程度で、RTX 5060 Ti で描画が伸びた理由は切り分けていない。
RTX 5080 の周回動画で、262,144個と 1,048,576個の猫のフィギュアの正面の同じコマを等倍で切り出して並べても、違いはほとんど見分けられなかった。目で比べた範囲で、画質の数値評価はしていない。
テンプレートの注記は、ガウシアンを増やしても点を重ねて密にするだけで細部は増えず、VRAM と時間がかかるとしている。見た目と時間については、測った範囲で注記と矛盾しなかった。VRAM のピークは、この測り方で分かる範囲では同じ程度だった。RTX 5060 Ti は 262,144個の行だけ .glb も出しているので、ガウシアンの数だけの影響は切り分けていない。RTX 5060 Ti のピークは同じ条件でも5.2〜8.5GiBで揺れるので、小さな増減は見分けられない。表の VRAM は3枚・5回の最大値で、VRAM の節の8枚・15回の最大値とは条件が違う。
.glbの解像度と被写体による大きさの違い
.glb で問題になるのは時間よりファイルの大きさで、メッシュ化そのものは1秒前後で終わった。RTX 5080・テンプレートの設定 (20ステップ) でプレビューを切って出力を .glb だけにし、SplatToMesh の解像度 (resolution。メッシュを取り出すための格子の、いちばん長い辺の方向の細かさで、テクスチャの画素数ではない) を 384 と 256 で比べた。各被写体のモデルを読み込んだ後の回 (シロクマは1回、他は2回) の中央値を「.glb の解像度と大きさ」の表に示す。ポリゴン数は .glb の三角形の数、MB は10の6乗バイト、メッシュ化の時間は SplatToMesh ノードの時間。
| 被写体 | 解像度 | ポリゴン数 | .glb の大きさ | メッシュ化の時間 |
|---|---|---|---|---|
| ベースを弾くシロクマ | 384 (テンプレートの値) | 3,189,108 | 74.8MB | 0.7秒 |
| ベースを弾くシロクマ | 256 | 1,197,688 | 27.7MB | 0.4秒 |
| レインコートの人物 | 384 (テンプレートの値) | 930,292 | 21.7MB | 0.3秒 |
| レインコートの人物 | 256 | 377,220 | 8.6MB | 0.3秒 |
| 猫のフィギュア | 384 (テンプレートの値) | 3,770,168 | 88.2MB | 1.2秒 |
| 猫のフィギュア | 256 | 1,481,520 | 34.2MB | 0.4秒 |
解像度を 256 に下げると、3枚ともポリゴン数とファイルの大きさがはっきり減り、.glb を小さくできる。.glb の保存はどの条件でも1秒未満だった。RTX 5060 Ti でも同じ3枚で測り、メッシュ化の時間の中央値は解像度 384 で 1.0秒、256 で 0.7秒 だった。
同じシロクマ・解像度 384 でも、テンプレートのまま流した回のポリゴン数は 3,189,100 で、条件の違う回の間で数ポリゴンの差が出た。メッシュの形の正確さや、Blender などに読み込んだときの扱いやすさは評価していない。
被写体による違い
テンプレートのままでも、.glb の大きさは被写体で大きく違う。テンプレートの設定のまま RTX 5080 で流した8枚の、モデルを読み込んだ後の回 (各被写体2回、シロクマは1回) の中央値を「被写体ごとの時間と出力の大きさ」の表に示す。
| 被写体 | 1枚の時間 | .glb のポリゴン数 | .glb の大きさ | .spz の大きさ |
|---|---|---|---|---|
| ベースを弾くシロクマ (テンプレートの見本) | 45.6秒 | 3,189,100 | 74.8MB | 3.1MB |
| レインコートの人物 (全身) | 44.1秒 | 930,292 | 21.7MB | 3.0MB |
| アニメ調のキャラクター (全身) | 45.7秒 | 404,920 | 9.5MB | 2.9MB |
| 真鍮の目覚まし時計 | 45.3秒 | 2,394,764 | 56.5MB | 3.3MB |
| 宇宙服の猫のフィギュア | 66.0秒 | 3,770,168 | 88.2MB | 3.1MB |
| 木の肘掛け椅子 | 66.8秒 | 4,257,912 | 100.0MB | 3.1MB |
| いちごのショートケーキ | 55.7秒 | 1,126,708 | 25.9MB | 3.1MB |
| ロードバイク | 63.9秒 | 132,640 | 3.1MB | 2.9MB |
.glb はロードバイクの約13万ポリゴンから肘掛け椅子の約426万ポリゴンまで開き、大きさも数MBから100MBまで違った。.spz はどれも3MB前後だった。同じ画像・同じ seed なら、同じ GPU の2回で .spz は同じ大きさになり、.glb の差も数百バイト以内だった。
1枚の時間は2群に分かれ、シロクマ・人物・アニメ調・時計の4枚が44.1〜45.7秒、猫のフィギュア・椅子・ケーキ・ロードバイクの4枚が55.7〜66.8秒で、後の4枚は周回動画の描画と保存が長かった。8枚は表の順に流しており、被写体のせいか順番のせいかは切り分けていない。テンプレートのままの1枚の時間 (中央値55.0秒) は、この2群の境目にあたる。
.glb を残すと、被写体によっては1枚で100MBほどになる。生成物でディスクがどこまで埋まるかは、ローカルAIでSSDが何TB要るかの記事で扱っている。
公称の「VRAM 7.2GB・2秒未満」と配布元の速度表
配布元のモデルカードは冒頭で、Idol は一般的な GPU で動き、VRAM 7.2GB を使い、2秒未満で動かせると書いている。どの GPU・ステップ数・処理の範囲で2秒未満なのかは書かれていない。
同じモデルカードの速度表は、50ステップ・ガウシアン 262,144個・8枚の中央値・全 GPU で同じコードと設定・1台に GPU 1枚という条件で測ったリクエスト時間を、10種の GPU で載せている。そこから一部の行を抜き出したのが「配布元の速度表 (抜粋)」の表で、値はすべて配布元のもの。
| GPU | 配布元の値 (50ステップのリクエスト時間) |
|---|---|
| B300 | 3.4秒 |
| H100 | 6.7秒 |
| RTX 5090 | 14.1秒 |
| RTX 4090 | 19.1秒 |
| RTX 3080 10GB | 46.2秒 |
| L4 | 54.6秒 |
全10行のどれも2秒未満ではなく、表の最速は B300 の3.4秒。冒頭の2秒未満と速度表が同じ条件の値なのかどうかは、配布元が示していない。
配布元の部品表では、背景除去・画像のエンコーダ (DINOv3)・生成本体・デコーダなどを合わせて約18億パラメータ、VRAM に載る重みは3.7〜4.4GB、ピークは7.2GBとされている。ピークの測り方は書かれていない。
配布元の SDK の README によると、既定は50ステップ・CFG 3.0・time shift 3.0 で、GPU では PyTorch のコンパイルなどの高速化が既定で有効になり、プロセスの最初の1枚はコンパイルの分だけ遅い。
この記事の値を速度表と同じ物差しで並べられないのは、速度表の説明に使ったコードや高速化の設定が書かれておらず、ComfyUI で測ったこの記事の値と条件が揃っているとは言えないため。この記事の50ステップの行も、ComfyUI の上でステップ数とサンプリングの方式を SDK の既定に近づけたもので、速度表の条件と揃えたものではない。速度表には RTX 5080 と RTX 5060 Ti の行も無い。
12GB 以下のカードを使っている場合、速度表には RTX 3080 10GB の行があるが、条件が揃っていないので、ComfyUI で動かしたときの時間の目安にはならない。
検証環境と測り方
測定は ComfyUI 0.44.0・PyTorch 2.14.0+cu130 で、RTX 5080 と、OCuLink で外付けした RTX 5060 Ti を1枚ずつ使った。2026年11月7日の時点で PyTorch は2.15.0が出ているが、本文の数値はすべて2.14.0+cu130で測ったもの。構成を「測定環境」の表にまとめる。
| 項目 | 内容 |
|---|---|
| GPU | RTX 5080 (PCIe 5.0 x16) |
| GPU | RTX 5060 Ti (OCuLink・PCIe 4.0 x4 で外付け) |
| CPU | Intel Core i7-14700F |
| メインメモリ | 96GB |
| OS | Windows |
| ComfyUI | 0.44.0 |
| PyTorch | 2.14.0+cu130 |
| テンプレート | ComfyUI 公式テンプレート「Idol: Image to Gaussian Splat」(2026年11月3日に更新されたもの) |
| 測定日 | 2026-11-07 |
測定機の構成の詳しい内容は、検証環境のページに載せている。2枚目の GPU で ComfyUI を動かす手順は、ComfyUI で使う GPU を指定する記事で解説した。
入力画像
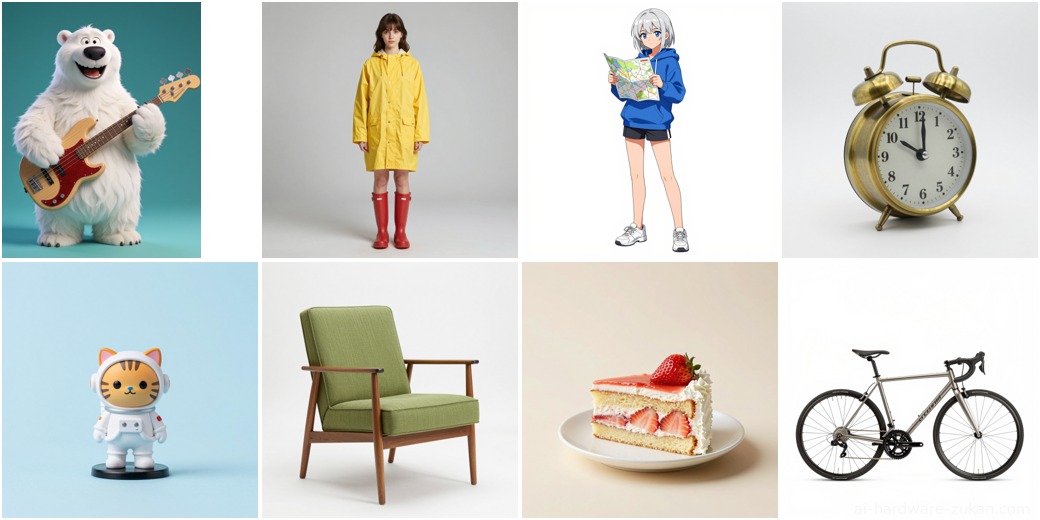
入力は8枚で、テンプレートに同梱の見本 (ベースを弾くシロクマ、896×1152) 1枚と、画像生成モデル (Z-Image Turbo) で作った架空の被写体7枚 (1024×1024)。実在の人物や既存のキャラクターは使っていない。7枚の被写体は、レインコートの人物 (全身)、アニメ調のキャラクター (全身)、真鍮の目覚まし時計、宇宙服の猫のフィギュア、木の肘掛け椅子、いちごのショートケーキ、ロードバイク。
回数と中央値の取り方
テンプレートのままの条件は、8枚を各2回流し、モデルを読み込んだ後の回 (各 GPU 15回) の中央値をとった。出力とステップ数を変えた条件も、8枚を各2回流してモデルを読み込んだ後の回の中央値をとっている。プレビューの有無とガウシアンの数は同じ3枚を各2回流した後の5回、.glb の解像度は各被写体のモデルを読み込んだ後の回 (シロクマは1回、他は2回)、重みの入れ替えは8枚を1回ずつ流した後の7回の中央値。同じ画像を続けて流すと、ComfyUI は入力が前回と同じノードの処理を省いて前回の結果を使い回す (実行キャッシュ)。これを避けるため、画像の中身と seed はそのままで入力のファイル名だけを回ごとに変え、背景除去から後の処理が省かれず毎回実行されたことを確かめた。モデルは同じプロセスで読み込み済みのものを使った。
テンプレートは、プログラムから送れる形式 (API 形式) に変換して ComfyUI に送った。1枚の時間は、ComfyUI が返す実行開始の通知 (execution_start) から完了の通知 (execution_success) までの時刻の差。ノードごとの時間は、そのノードの実行開始の通知を受けた時刻から、次のノードの実行開始の通知か終了の通知を受けた時刻までを、そのノードの時間とした値で、通知が届くまでの遅れも含む目安になる。VRAM は nvidia-smi で見たカード全体の使用量で、約0.6秒おきに取った値の最大をピークとし、MiB の値を1024で割って GiB で書いている。取得の間隔より短い山は取り逃がしうる。どの回も、ComfyUI のプロセスの中で PyTorch が使った GPU の名前を記録し、nvidia-smi で測ったカードの名前と一致することを確かめた。16GB のカードは nvidia-smi の表示で約15.9GiB になる。ファイルの大きさの MB は10の6乗バイトで、テンプレートの注記の MB・GB だけはバイト数を1024で割った値になっている。
除いた回
RTX 5060 Ti の50ステップは、別の処理が同じ GPU を使っていた時間帯に重なった3回を外し、その2枚を測り直した値を合わせた15回の中央値にした。
測っていないこと
- 12GB 以下の GPU。動くかどうかも、1枚の時間も測っていない
- 通常の PCIe スロットに挿した RTX 5060 Ti。サンプラーの差が GPU の違いによるのか、OCuLink の接続の違いによるのかは切り分けていない
- 配布元の SDK そのもの
- 20ステップと50ステップの見た目の差
- 生成物の画質の数値評価 (見た目は周回動画を目で見た範囲)
- Blender などに .glb を読み込んだときの扱い
- 周回動画を外したときに、.spz や .glb を別に開いて出来を確かめる手間
- ComfyUI の画面でグループを無効にする操作 (測定では外した出力の処理を実行対象から除いた)
- 50ステップで周回動画を付けた条件の時間
- Linux
- 重みが OS のファイルキャッシュに無い状態からの読み込み
本文の実測値は2026年11月7日に測定したもの。ComfyUI 0.44.0・PyTorch 2.14.0+cu130 で、モデルやテンプレートの更新で変わりうる。
まとめ
Idol は、測った16GBのカード2枚 (RTX 5080 と、OCuLink で外付けした RTX 5060 Ti) のどちらでも ComfyUI のテンプレートのまま最後まで動き、VRAM 使用量のピークはカードの半分ほどだった。20ステップの条件では、周回動画を外しプレビューも切って .spz と .glb を残すと、1枚の時間の中央値は2枚の GPU ともテンプレートのままの半分以下だった。同じ画像・同じ回どうしを組にして比べると、RTX 5060 Ti では15組のうち4組で半分をわずかに上回った。.glb まで外しても、縮むのは中央値で1秒未満だった。50ステップ (Euler) にすると、.spz だけの条件で時間は20ステップの2倍以上になった。
周回動画を成果物として使わないなら外せて、.glb は時間より被写体ごとのファイルの大きさが問題になる。周回動画そのものを使う場合は動画の枝を残すことになる。.glb とプレビューを外して周回動画を残した RTX 5080 の別の測定では、1枚の中央値は46.5秒だった。
見た目は、1つの seed を目で見た範囲で、側面と背面は推定で作られ、ロードバイクではスポークなどの細い部分が崩れた (テンプレートの注記が挙げる限界と重なる)。アニメ調のキャラクターは seed 46 で脚の色が変わり靴が離れたが、seed 7 と 123 では出なかった。seed を変えて確かめたのはこの1体だけで、ロードバイクの崩れが seed で変わるかは確かめていない。
配布元の「2秒未満」は条件が書かれておらず、配布元自身の速度表にも2秒未満の行は無い。
参考資料
- speridlabs/idol — Hugging Face モデルカード
- speridlabs/idol-sdk — GitHub
- Comfy-Org/Idol — Hugging Face モデルカード
- Comfy-Org/BiRefNet — Hugging Face
- VAST-AI-Research/TripoSplat — GitHub
- ComfyUI workflow_templates — 3d_idol_image_to_gaussian_splat
- facebook/dinov3-vith16plus-pretrain-lvd1689m — Hugging Face
- black-forest-labs/FLUX.2-dev — Hugging Face