ローカルLLM

LLMを手元のPCで動かすためのモデル選び、必要メモリ、速度の目安をまとめます。

複数のGPU・量子化条件による実測から、動く構成と実用速度を確認できます。
Strata

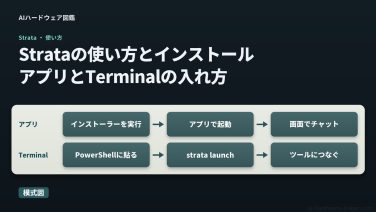
Strataの使い方とインストール|VRAM 16GBのGeForceでアプリとTerminalのどちらで始めるか

Strataをデスクトップアプリで入れるかTerminalで入れるかの選び方と、PowerShellの1行での導入、strata launchでの起動、Claude Codeなどへのつなぎ方、更新とアンインストールまでを、VRAM 16GBのRTX 5080と5060 Tiで試した結果つきでまとめた。
LLM量子化・軽量化

Ternary Nemotron 3.5 LightningをVRAM 12GBで動かす|長い文書でも速さは保てるか

RTX 4070 SUPER(VRAM 12GB)1枚でTernary Nemotron 3.5 Lightningを実測。文脈長368,640の設定でも全層をGPUに置く指定のまま動いた。29万トークンの入力は読み込みに約2分かかり、そのあとの生成は短い入力の約3割に落ちた。
LLM量子化・軽量化

Gemma 4 26B-A4BのQATをVRAM 16GBで動かす|Ollamaとllama.cppのどちらを使うか

Ollama の qat タグ ( gemma4:26b-a4b-it-qat ) は RTX 5080 1 枚で 8K から 256K まで動いたが、この記事の Ollama の設定では、どの文脈長でも 16GB の GPU に全部は載らず、一部が CPU 側に回った。
PC構成

WRX90 AI TOPはローカルLLMのどこで差が出るか|TRX50 AI TOPとどちらを選ぶか

GIGABYTE の WRX90 AI TOP を公称値から読み解く。x16 で動くスロット6本と8チャンネルのメモリが、ローカル LLM のどこで差になるかを先に出た TRX50 AI TOP と比べ、GPU の枚数とメモリの使い方からどちらを選ぶかを整理する。価格と発売日は未発表。
Strata

Strataで動かせるモデルと必要なメモリ|VRAM 12GB・16GBのGPUでどれを選ぶか

Strataで動かせるQwen3.8-Flash-Next・Gyro・Coder・DeepSeek V4.1-Flashを、メインメモリの量とVRAM 12GB・16GBで選ぶ早見表で整理。DeepSeekに要るメモリとディスク、2枚目のGPUを足したときの測定結果も載せた。
Strata

Strataのアップデートで変わったこと|VRAM 12GB・16GBのGeForceは更新すべきか

Strata の 0.2.13 までの更新を、VRAM 12GB・16GB の GeForce と Windows で使う人向けにリリースノートから整理した。0.2 系への上げ方、更新で変わる既定値と戻し方、RTX 5080・5060 Ti で 0.1.41 と 0.1.45 の速さを測った結果を載せている。
PC構成

Ryzen AI Max+ PRO 495の192GBで何が載るか|395の128GBで足りるか

Ryzen AI Max+ PRO 495の192GB機と395の128GB機を、LLMのGGUFファイルの大きさとAMDが示すGPU専用の割り当て量で比べた。国内で注文できる機種と価格、GPU 1枚とメインメモリで大きなMoEを動かした実測も載せる。
ローカルLLM

LFM2.5-24B-A2BはVRAM 16GBで動くか|文脈長ごとの使用量と速さ、Ollamaでの読み込み、Qwen3.6-35B-A3Bとの違い

LFM2.5-24B-A2BをVRAM 16GBのRTX 5060 Ti・5080で実測。文脈の長さごとのVRAM使用量、入力の処理と生成の速さ、Ollamaでの読み込み、Claude Codeでの作業結果を、16GBに載りきらないQwen3.6-35B-A3Bと比べた。
Strata

Claude Code・Codex・OpenCodeをStrataのローカルLLMにつないで比較|VRAM 16GBのRTX 5080でつなぐ設定と、かかった時間・テスト結果

Claude Code・Codex CLI・OpenCode を Strata のローカル LLM につなぎ、VRAM 16GB の RTX 5080 1枚で小さな関数の修正を同じ課題文で解かせた。つなぐ設定、所要時間とテストの合否、Codex の失敗例と直し方をまとめた。
Strata

Strataで2枚目のGPUをどう使うか|層を分ける方式と補助キャッシュの違いをRTX 5080+5060 Tiで検証

Strata で2枚目の GPU を使う3つの方法の違いを整理し、RTX 5080 に OCuLink 外付けの RTX 5060 Ti を足して 0.1.39〜0.1.41 で測った。試した構成では入力の読み込みがどれも1枚より遅かった。起動ログで見えた割り当てと、確かめる手順を載せている。